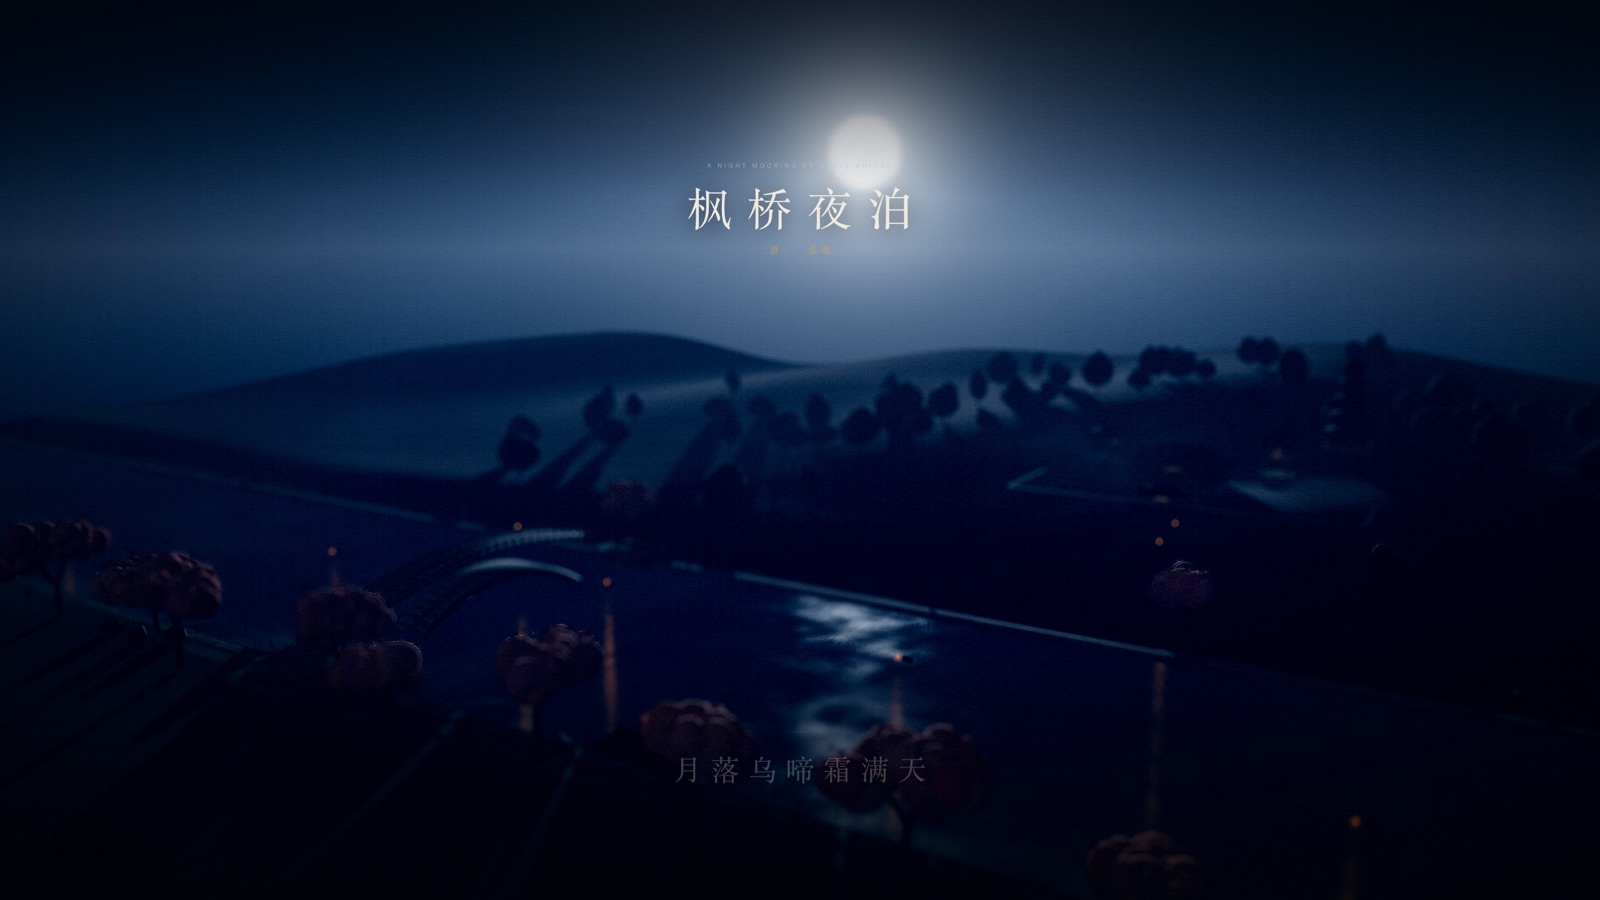
月落江天:开场镜头里的枫桥、江面与压在天际线上的月亮

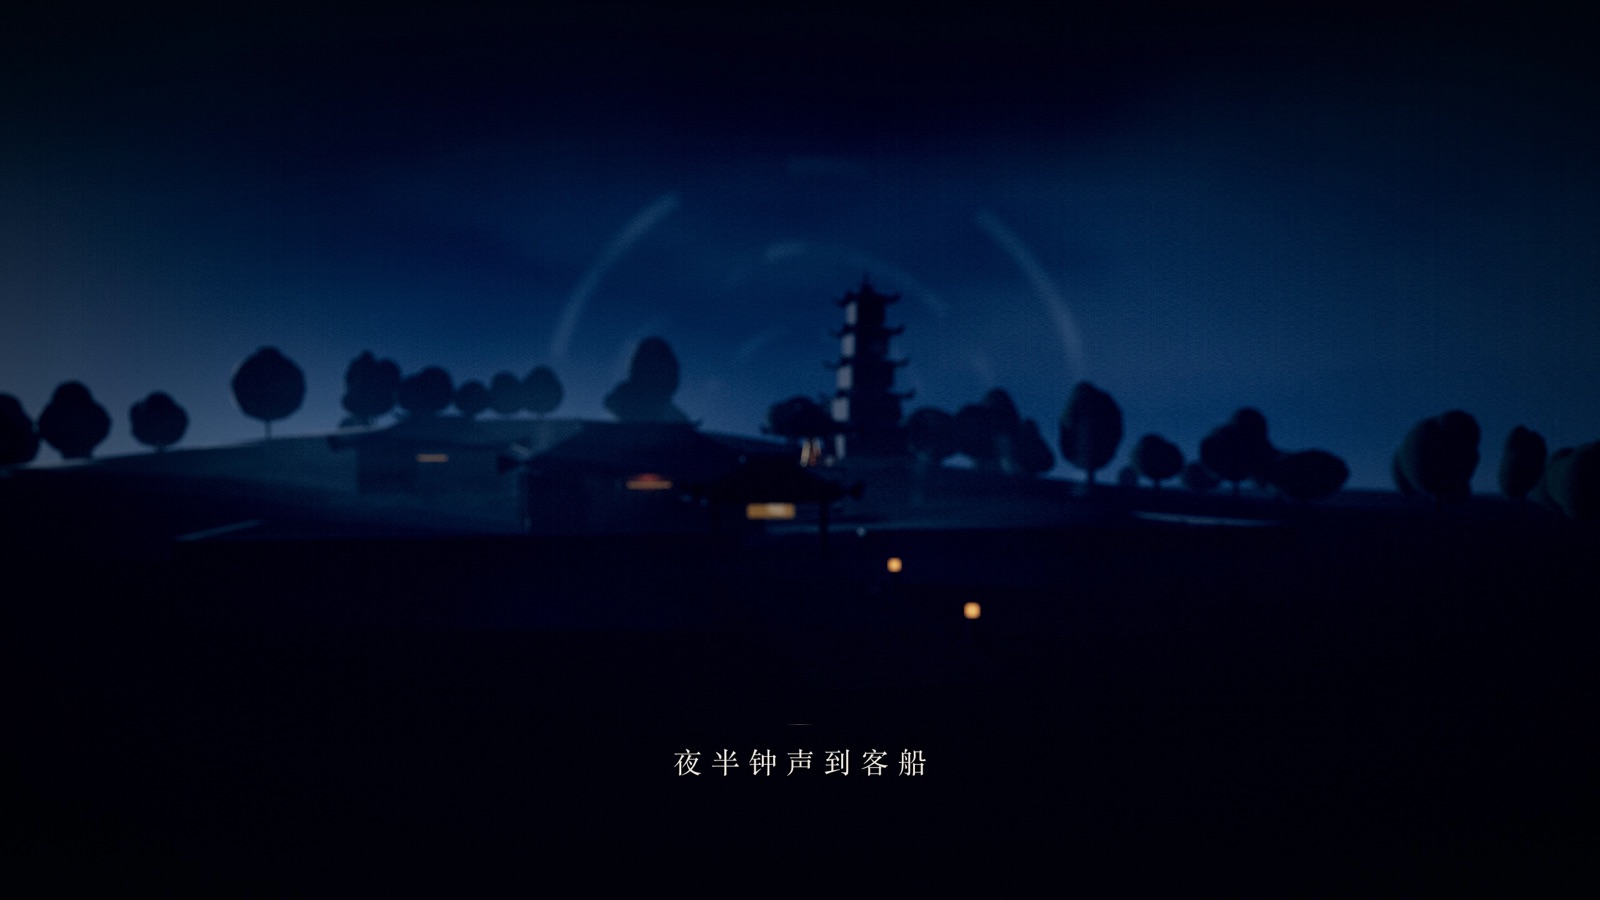
封面:1.6 秒处的开场。月亮已经压得很低,石拱桥和枫林只是江岸上的剪影,月光在江面拉出一条断续的银蓝色碎影。

模型:DeepSeek-flash4.1;harness:Claude Code;能力来源:一组对齐 three.js r186 的 threejs-skills。

这篇文章复盘的是:一份把《枫桥夜泊》拆成空间、时间与机制的提示词,如何落成一个可漫游的三维场景,并导出成 40 秒、60 fps 的短片。下文把输入的那份提示词称为「世界说明书」,把产出称为「场景 v1」。

引言:二十八个字,四十秒

《枫桥夜泊》只有二十八个字。它写了月、乌、霜、江、枫、渔火、姑苏城、寒山寺、钟声、客船。如果只是把这些名词做成模型,一件件摆进画面,得到的是一张会动的明信片,不是这首诗。

诗里真正难画的是动词和时间:月「落」,乌「啼」,霜「满天」,渔火「对」愁眠,钟声「到」客船。落是一个过程,到是一段延迟。把诗变成场景,关键不是把名词堆齐,而是为每个动作找到一个可以被渲染的机制。

这份世界说明书一共十一节,从色彩、建模、动态、镜头、字幕,一直写到导出规格。它不像一份「元素清单」,更像一份世界的说明书:先规定这个夜晚的光、色、尺度和方位,再规定什么东西在什么时候动。

先说结论:这首诗最适合被拆成四条时间轴——月落的轴、风吹叶落的轴、寺院显形的轴、钟声抵达的轴。四条轴对齐在同一个 40 秒里,诗就成了镜头。

一、诗里能动的,是动词

把四句诗拆开,会看到两种东西:布景和机制。

诗句 布景(名词) 机制(动词 / 时间) 主要实现
月落乌啼霜满天 月、乌、霜、天 落、啼、满天 sky.js、birds.js、mist.js
江枫渔火对愁眠 枫、渔火、客船 并置、静默、摇曳 trees.js、fishing.js、boat.js
姑苏城外寒山寺 城、寺、山 城外(距离)、显现 terrain.js、temple.js、雾
夜半钟声到客船 钟、船 到(传播延迟) temple.js、water.js、audio.js

名词决定场景的体积,动词决定动画的预算。提示词里最值钱的句子,往往不是「要有枫树」,而是「部分落叶随风飘落,偶尔落在江面」——它把一棵树从一个静态模型,变成了一个持续发生的系统。

这份提示词还有一个很清楚的取舍:它反复写「不要」。不要做成暴雪,不要科幻雷达波,不要霓虹圆环,不要平面插画代替三维场景,不要让船悬空或穿模。这些禁止项不是修辞,它们是在提前排除模型在信息不足时最容易选择的默认解。

二、先定世界基准,再谈物件

场景 v1 的所有坐标都收在一份 src/config.js 里。这不是为了代码整洁,而是为了让「江」成为整个世界的基准。

坐标系沿用仓库约定:X 轴向东,Z 轴向南,Y 轴向上,1 个世界单位约等于 1 米。河道沿 X 轴展开,z = 0 是江心;南岸是近景的枫桥、枫林、码头与客船,北岸抬升为寒山寺所在的山坡。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
export const WORLD = {
waterLevel: 0.35,
landLevel: 1.35,
bankTop: 1.6,
riverHalfWidth: 34,
riverLength: 520,
templeBase: 9.2,
};

export const LAYOUT = {
bridge: { x: -42, z: 0, width: 7.2, span: 74, rise: 11.5 },
boat: { x: 14, z: 23.4, heading: -0.16 },
temple: { x: 42, z: -118, y: WORLD.templeBase },
bell: { x: 47, z: -126, y: 20.5 },
moonDir: new THREE.Vector3(-0.55, 0.08, -0.83).normalize(),
};

水面高度、陆地高度、河宽、寺院台基,是四个共享的水平面。桥、船、树、寺、渔火都从这几个常量上长出来,而不是各自记一套魔法数字。客船到寺院在 Z 方向上相差 141.4 个单位;这个距离不是随手写的,它同时决定了第 16–26 秒镜头隔着多远的江面去「看」寺院,以及雾要浓到什么程度,才能让寺院「若隐若现」。

月亮的方向也是常量:(-0.55, 0.08, -0.83),仰角大约 4.5°。它压在西北天际线附近,所以才有「落」的余地。提示词里那句「月亮位于远山与天际线附近,呈现月落状态」,最后落成一个随时间缓慢下沉的方向函数:

1
2
3
4
5
6
export function moonDirectionAt(t) {
const drop = THREE.MathUtils.clamp(t / 40, 0, 1);
const az = -0.55 - drop * 0.01;
const elevation = 0.078 - drop * 0.03;
return new THREE.Vector3(az, elevation, -1).normalize();
}

40 秒里,仰角从约 4.5° 降到约 2.7°。变化很小,小到单看一帧几乎察觉不到;但把它交给时间轴,月亮就真的在落。诗里的「落」不是一个状态,是一个斜率。

三、四句诗,四种机制

1. 月落乌啼霜满天

这一句有三个动作,分别落在三个模块里。

天空是一整块 shader。月盘、月海、边缘亮环、月晕、贴近地平线的薄云和稀疏星光都在同一个片元着色器里计算。星光用 step(0.9981, star) 筛出来——只保留约千分之二的网格,正好是「少量星光,不要过度密集」的分量。

乌鸦是低多边形剪影:身体、头、喙、尾,两片可以上下扇动的翅膀。三只乌鸦各自沿一条 CatmullRomCurve3 飞行,用 getPointAt 取位置、用切线定朝向,转弯时按曲率侧倾,翅膀按正弦节奏扇动。它们只在各自的时间窗里出现,所以画面里始终只有一两只,不会变成一群。

「霜满天」最容易被做错。提示词专门写了「不应把画面做成暴雪或大面积飘雪」。最终的方案是 520 个极细的霜粒,加上贴着水面缓慢流动的雾片;它们不是天气系统,只是一层几乎看不清的冷凝感。观众不会注意到霜粒,但会觉得空气是冷的。

这就是「意境」在工程里的样子:不是把比喻做大,而是把它做小,小到刚好能被感觉到。

2. 江枫渔火对愁眠

枫树是递归生成的。主干分出枝,枝再分叉,直到末梢;叶簇和带枫叶剪影的叶片卡片全部用 InstancedMesh。真正让树「活」起来的是一段注入到材质里的顶点风场:每个顶点按世界坐标和时间获得一个很小的位移,整片树冠因此以不同的相位轻轻摇动。

但只有整片摇动还不够。提示词还要「少量枫叶从树枝上脱落,飘落江面」。于是另有 120 片独立模拟的落叶:每片有自己的速度、旋转和相位,受重力和侧风影响;落到 waterLevel + 0.015 时停止下落,转为漂浮,漂 8–12 秒再重新生成。

这里有一个很实用的分层:大面积的叶子交给 GPU 的顶点着色器,少量需要「叙事」的叶子交给 CPU 逐片模拟。 如果 120 片叶子也走 shader,它们会整齐得像一场雨;如果整棵树都走 CPU,2K / 60 fps 的预算立刻不够。

渔火是另一层。江面上有五艘渔船,分布在远近不同的位置,每盏灯有自己的闪烁相位。它们通过 water.setLantern(index, position, color, power) 注册到水面 shader,最多 10 盏。船上的灯是暖橙色 #FFAD58,月光是银蓝色 #B7C9DE;这一冷一暖的对比,就是「对愁眠」里那个「对」字的视觉支点。

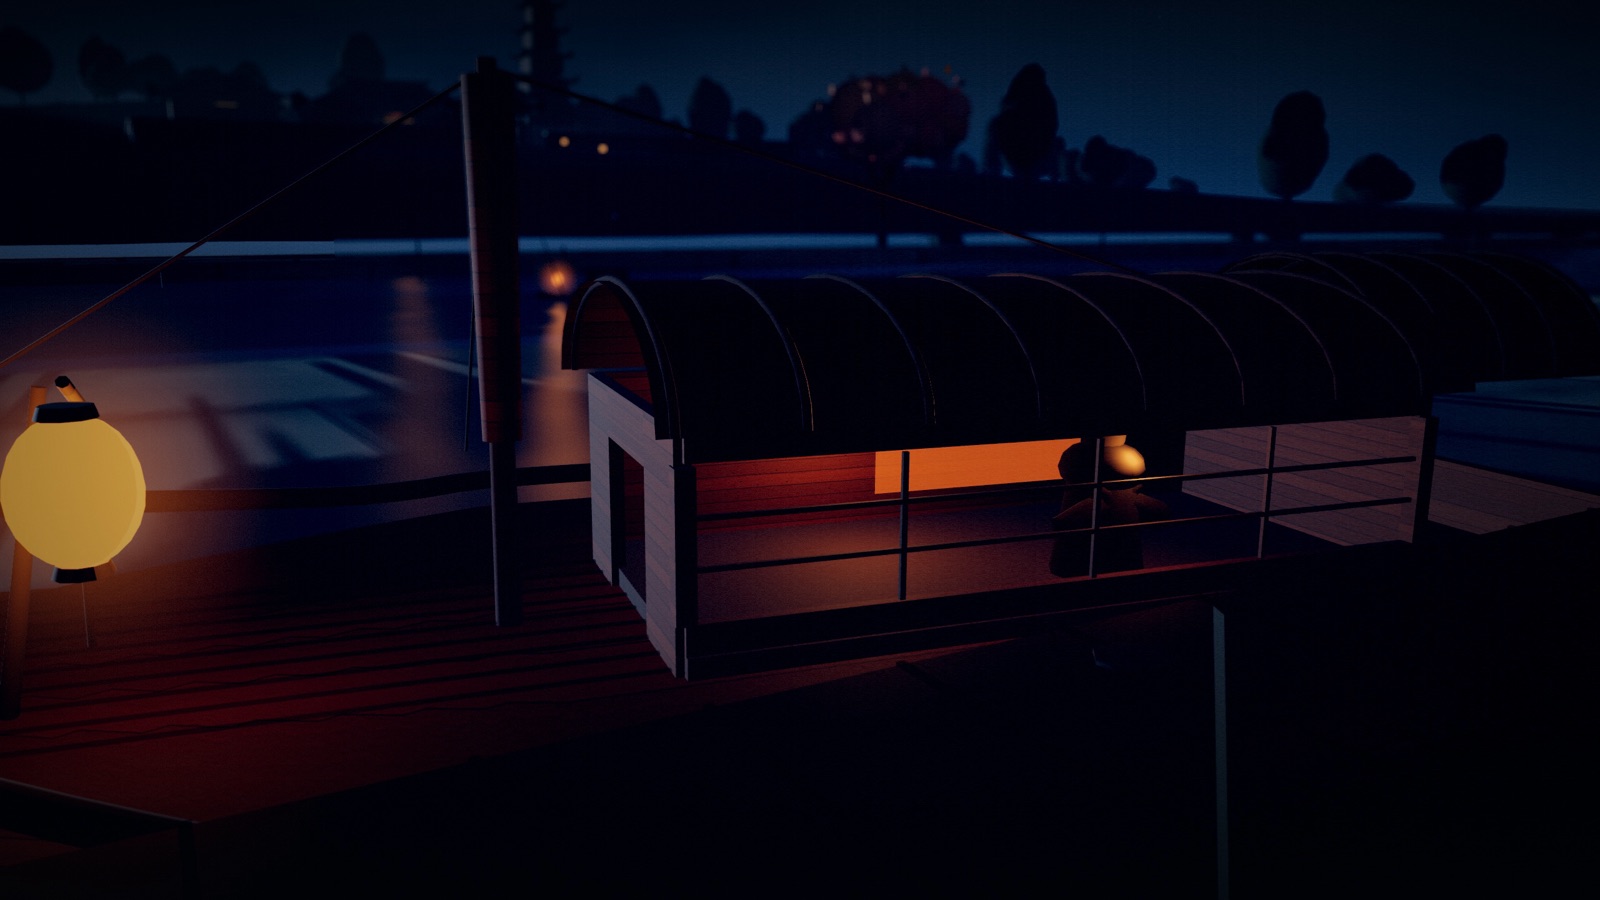
客船停在 (14, 23.4)。船体由逐站截面放样,木舱、竹篷、桅杆、收帆、缆绳和船头灯笼各自成组;船身随水流横摇、升沉、轻微偏航,舱内暖光与窗棂后的诗人剪影保持安静。提示词说人物「不需要复杂的人物动画」,这个克制是对的——诗人一动,画面就从「夜泊」变成了「夜航」。
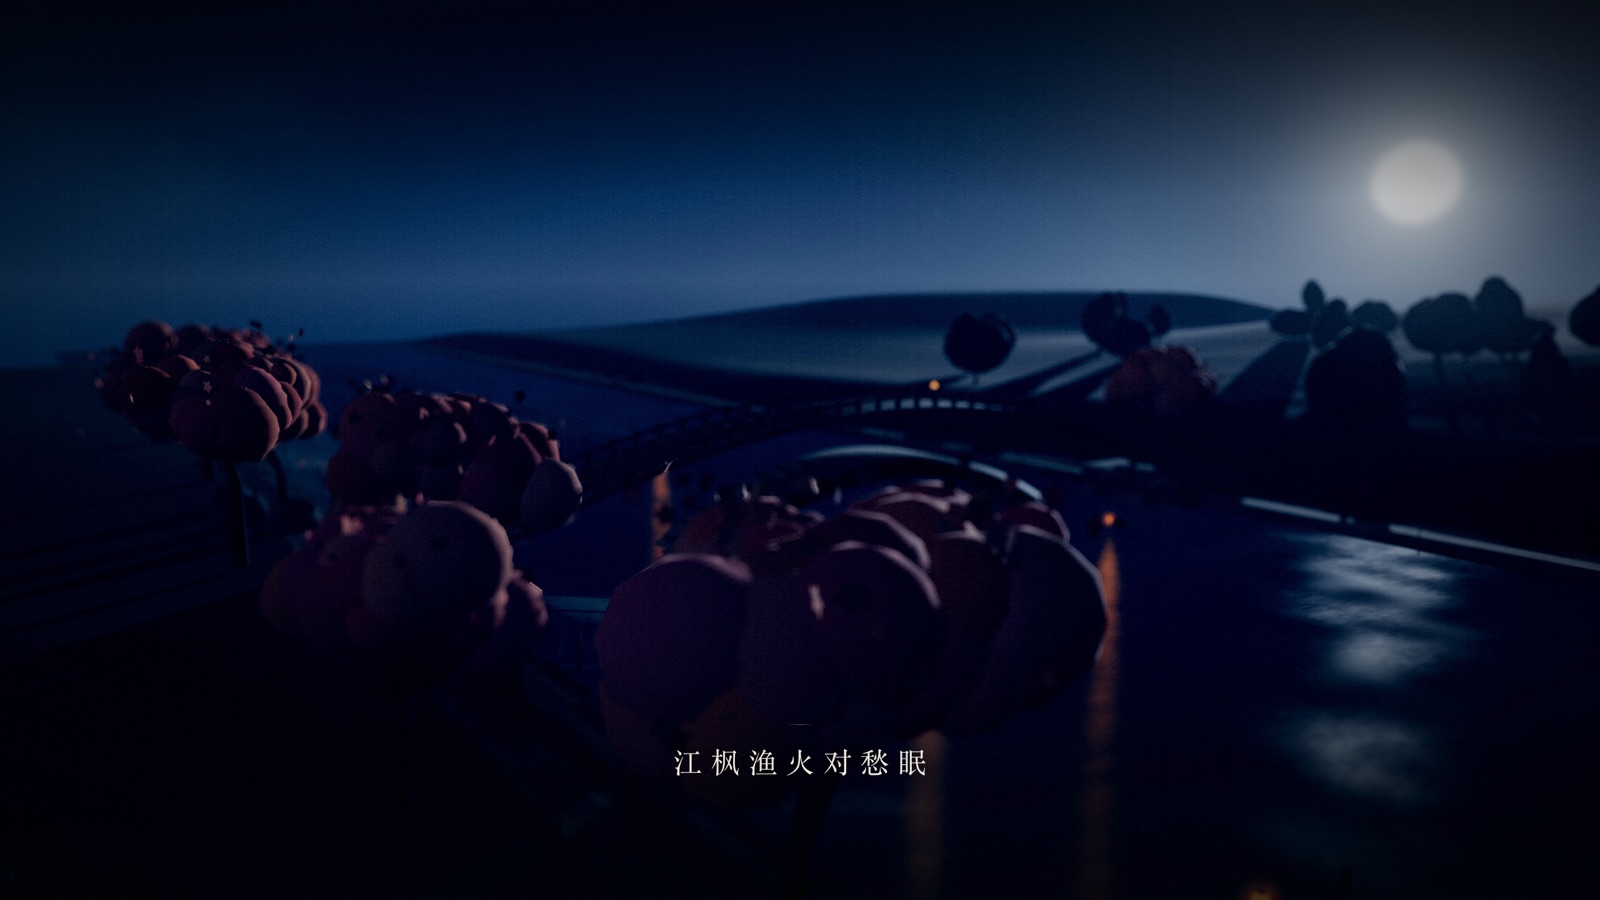
江枫渔火:枫林、渔船灯火与石桥

图 1:9 秒处的江岸。枫树的暗红树冠压在画面上方,渔船灯火在江面拉出暖色倒影;冷的月光和暖的渔火在同一个水面 shader 里共存。

3. 姑苏城外寒山寺

寒山寺在 z = -118,客船在 z = 23.4,中间隔着 141 个单位的江面。提示词要求「建筑轮廓能够被观众辨认,但不应过于突出」「寺院与客船之间存在明确的空间距离」。场景没有靠把寺院做小来实现「远」,而是叠了三层:

  1. 距离:寺院真的在江对岸的山坡上,台基高度 9.2,从客船看过去需要仰视。
  2. 雾:FogExp2,密度 0.0029,越远越接近雾的颜色 #27313F。
  3. 景深:BokehPass 的聚焦距离随相机与注视点更新,远处的屋檐自然变软。

寺院的建筑本身共用一套屋面生成器。山门、主殿、偏殿、钟楼、五层塔的屋顶都由同一个函数生成,用 t 参数控制屋脊高度、坡面曲率和四角起翘;改变尺寸与起翘量,就能得到不同等级的建筑。这样做的价值不在省代码,而在风格一致:所有屋檐的弧线来自同一个曲面族,远看才不会像拼贴。
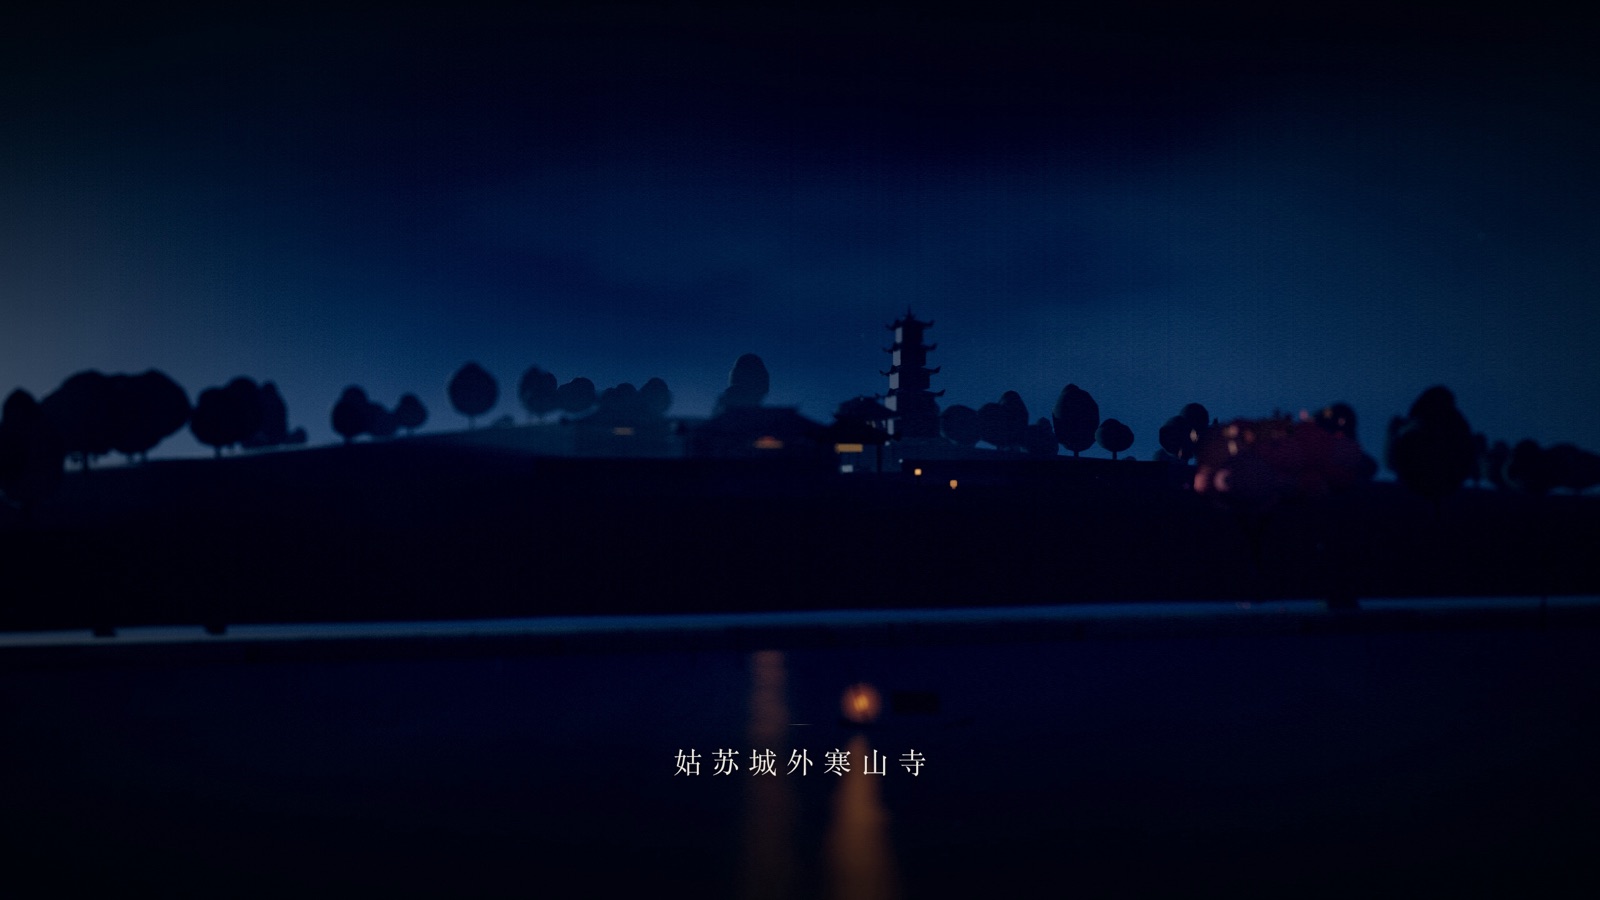
雾中寒山寺:对岸的寺院与钟楼

图 2:24 秒处,寒山寺从雾里显形。寺院被距离、雾和景深三层推开,轮廓可辨,但不抢客船。

4. 夜半钟声到客船

这是全诗唯一一句明确写了「传播」的诗。前三句都是视觉,第四句突然变成听觉;而且「到」字说明钟声不是同时在所有地方响,它需要时间。

场景把这件事写成了绝对时间:

  • STRIKE_TIME = 28.6 秒,撞木在 25.6 秒开始向后拉开,28.2 秒开始荡向古钟,28.6 秒撞上。
  • 钟体在撞击后按指数衰减摆动:sin(strike * 4.1) * 0.105 * exp(-strike * 0.85)。
  • 钟体本身还有极细的震动:sin(strike * 38) * 0.012 * pulse,同时暖光按 exp(-strike * 1.7) 脉冲一次。
  • 31.1 秒和 32.4 秒,江面在客船附近出现两组同心涟漪——这是钟声「到」的时刻,距离撞钟晚了 2.5 秒和 3.8 秒。
1
2
3
4
5
6
7
8
9
10
11
12
const strike = time - STRIKE_TIME;

// 钟摆:先自由微摆,撞后叠加一段指数衰减
let bellAngle = Math.sin(time * 0.55) * 0.008;
if (strike > 0) {
bellAngle += Math.sin(strike * 4.1) * 0.105 * Math.exp(-strike * 0.85);
}
tower.bellGroup.rotation.z = bellAngle;

// 钟体被撞后的细微震动
const pulse = strike > 0 ? Math.exp(-strike * 1.7) * Math.min(1, strike * 8) : 0;
tower.bellMesh.position.x = Math.sin(strike * 38) * 0.012 * pulse;

声波的视觉化是最容易过火的地方。提示词写得很明确:「使用透明环形波纹、空气扰动等视觉方式」「不要使用科幻雷达波或夸张的霓虹圆环」。最终的实现是四道 220×220 的平面,加法混合,半径在 7 秒内从 0.06 扩到 0.76;透明度只有 0.045 - i * 0.006,波前还被噪声打散成不连续的弧。换句话说,它几乎看不见——只在寺院前的雾里留下一圈很淡的扰动。

江面的涟漪则通过 uniform 写进水面 shader:最多 6 组 (x, z, 起始时间, 强度),每组的径向斜率叠加到基础波场上。钟声抵达时,涟漪从客船附近向外扩散,和月光、渔火共用同一套法线。
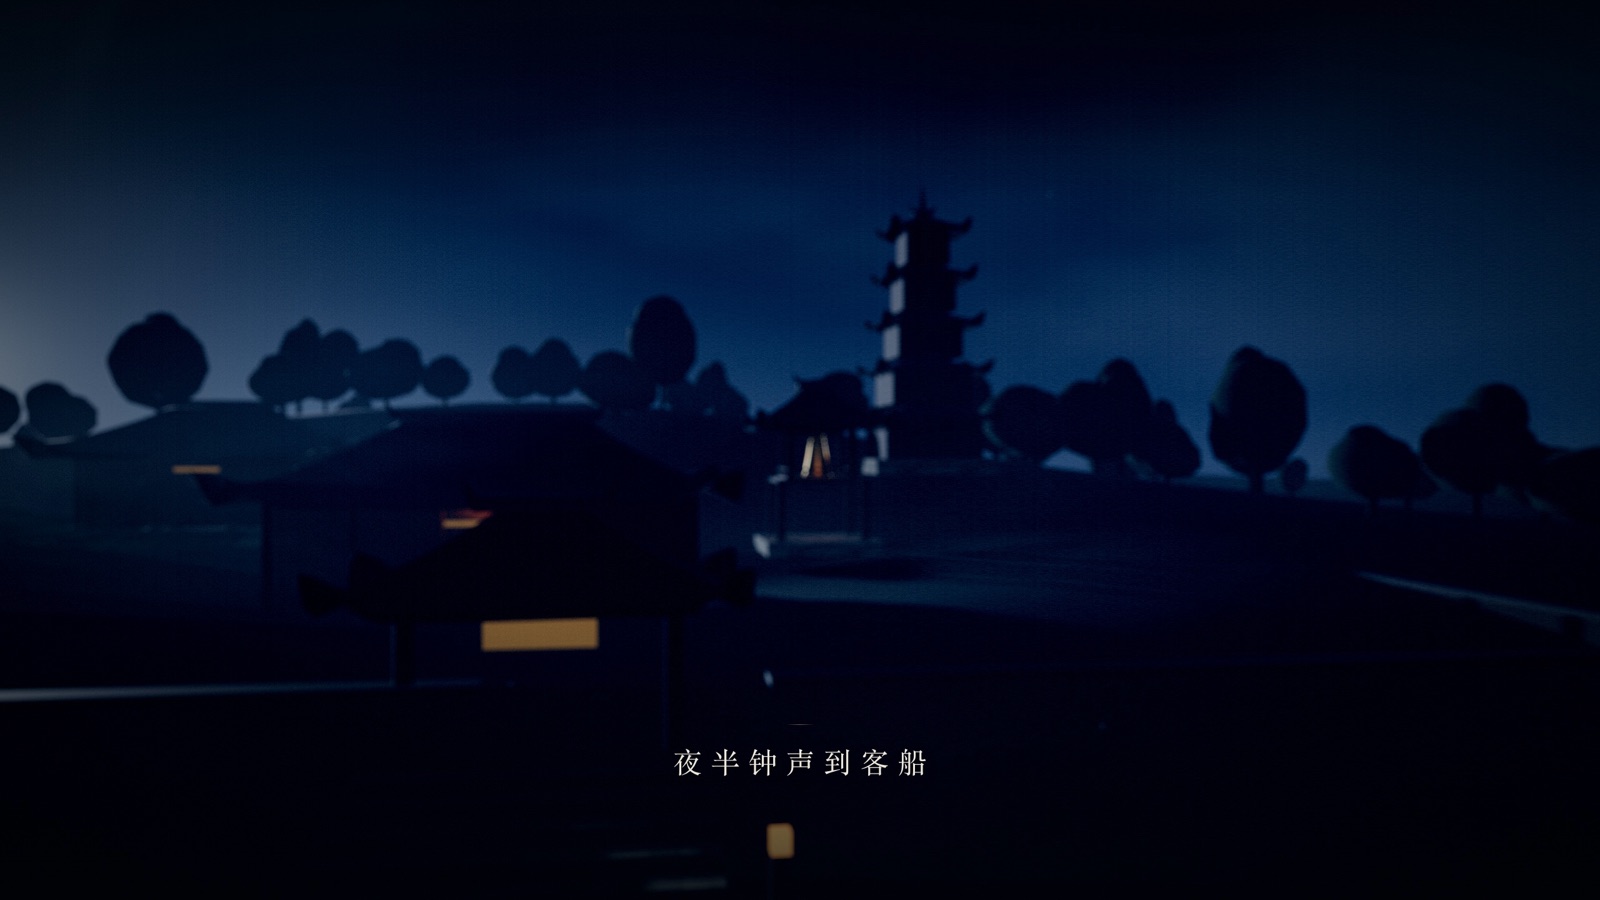
钟楼与古钟:撞钟前的瞬间

图 3:34 秒处的钟楼。古钟悬在二层,撞木已经荡开;钟体的青铜色和寺院的暖光只在局部出现。
声波越过江面:四道极淡的环形波前

图 4:30.4 秒,钟声正在越过江面。波前被噪声打散,透明度极低,只够让雾和江面轻轻动一下。

声音本身由 Web Audio 实时合成:钟声是几组带轻微拍频的正弦分音,乌鸦是滤波后的噪声脉冲,水声和风声是噪声加低频振荡;混响发送量 0.36,让钟声在江面上留一条尾巴。成片音轨则用 Python 离线渲染,和画面在同一张时间表上对齐。

四、水面:四句诗叠在同一个 shader 里

江面是整篇文章里技术密度最高的部分。它用 Reflector 做真实的平面镜像——天空、寺院、枫树、灯火都会被反射——再在镜像之上叠一层自定义 GLSL。

这一层 shader 同时负责五件事:

  1. 波纹:四组不同频率、不同速度的行波叠加成斜率,再用两层低频噪声打破规则感。
  2. 反射扰动:用波斜率偏移反射纹理的 UV,让倒影随水波扭动;再取一次偏移更大的采样做混合,避免倒影太干净。
  3. 月光碎影:沿「相机 → 月亮」的方位拉出一条细长的银色路径,路径内部再用高光项和噪声切成断续的碎片。
  4. 渔火倒影:把每盏灯沿水面镜像,取「相机 → 镜像点」的线段,在江面上形成一条被噪声打断的暖色光带。
  5. 钟声涟漪与贴岸泡沫:涟漪作为径向斜率叠加;靠近岸线 |z| > 31 时压暗水面,形成一条暗色水线。

月光那一段值得单独看:

1
2
3
4
5
6
7
8
vec2 toPoint = normalize(p - cameraPosition.xz + vec2(0.0001));
vec2 moonH = normalize(uMoonDir.xz);
float angleDiff = acos(clamp(dot(toPoint, moonH), -1.0, 1.0));
float path = exp(-angleDiff * angleDiff * 170.0);

vec3 halfDir = normalize(normalize(uMoonDir) + viewDir);
float sparkle = pow(max(dot(normal, halfDir), 0.0), 58.0);
col += uMoonColor * path * (0.008 + sparkle * 0.5) * shimmer * micro;

它没有一张「月光贴图」。月光之所以在江面上,是因为相机、月亮方位和水面法线在每一帧重新算了一次。镜头一动,碎影跟着动;月亮下沉,路径跟着偏。渔火倒影同理。倒影不是画上去的,是算出来的。

这也是提示词里那句「通过 Shader 实现水面反射和扰动」真正的价值:它要求的不是某个 API,而是一种建模方式——把水面当成一个光学系统,而不是一张会动的背景。
客船与诗人:舱窗后的剪影

图 5:16 秒处的客船。船体、木舱、竹篷和缆绳都是程序化生成;舱内暖光只够照亮窗棂和诗人的轮廓。

五、40 秒是一条函数

影片时间线在 src/film.js。它只做一件事:把任意时刻 t 映射成相机位置、注视点、字幕透明度和世界状态。

相机不是用关键帧动画软件做的,而是两组关键点加 Catmull-Rom 插值:

1
2
3
4
5
6
7
const KEYS = [
{ t: 0.0, position: V(106, 68, 138), target: V(-8, 26, -42) },
{ t: 4.0, position: V(78, 45, 110), target: V(-9, 20, -34) },
{ t: 7.0, position: V(44, 22, 78), target: V(-16, 12, -18) },
// ……
{ t: 34.6, position: V(46, 17.0, -64), target: V(54, 17, -126) },
];

每个关键点同时给出位置和注视点,两个都做 Catmull-Rom 插值。这样相机既经过每个机位,又保持速度连续,不会在关键点之间突然拐弯。35 秒之后换用另一组 FINALE_KEYS:镜头回到客船,再拉远到全景。

35 秒处有一次刻意的黑场。钟楼在江对岸,客船在南岸;如果让相机直接横跨 141 个单位的江面,观众会看到一段没有叙事的长距离平移。黑场遮住这次切镜,比硬切更自然,也比强行飞过去更诚实。

时间 镜头 字幕 主要机制
0–7 s 高空俯视,月落江天 月落乌啼霜满天 月亮下沉、乌鸦飞行、霜粒与雾
7–16 s 下降掠过枫林与渔火,靠近客船 江枫渔火对愁眠 风场、落叶、渔火倒影、船体横摇
16–26 s 从客船望向对岸,寺院显形 姑苏城外寒山寺 距离、雾、景深、屋面生成器
26–35 s 推进钟楼,撞钟,声波越江 夜半钟声到客船 撞木、钟摆、声波环、江面涟漪
35–40 s 黑场切回客船,拉远,全诗淡出 全诗 第二组相机曲线、字幕淡出

字幕不单独做动画状态机,而是几个 fade(t, inStart, inEnd, outStart, outEnd) 窗口。applyOverlay(t) 每帧根据绝对时间设置透明度和位移;拖动时间轴时,字幕会直接落到正确的位置,不会「补动画」。

这套结构还有一个直接好处:可重复导出。 在 ?film=1&capture=1 下,页面关闭实时循环,由 window.__capture.renderAt(t) 以固定 1/60 秒步长推进;deterministic.js 用固定种子覆盖 Math.random,树叶、乌鸦、雾和渔火的随机相位每次导出都一致。2400 帧捕获了 349 秒,平均约 6.9 fps;中断后可以加 --resume 从已有帧继续。

如果所有状态都从 t 推导,那么播放、暂停、拖动时间轴、重导出就是同一个函数的不同调用方式。反过来,只要有一处动画依赖「上一帧的状态」,时间轴一拖就会漂移,导出也无法复现。
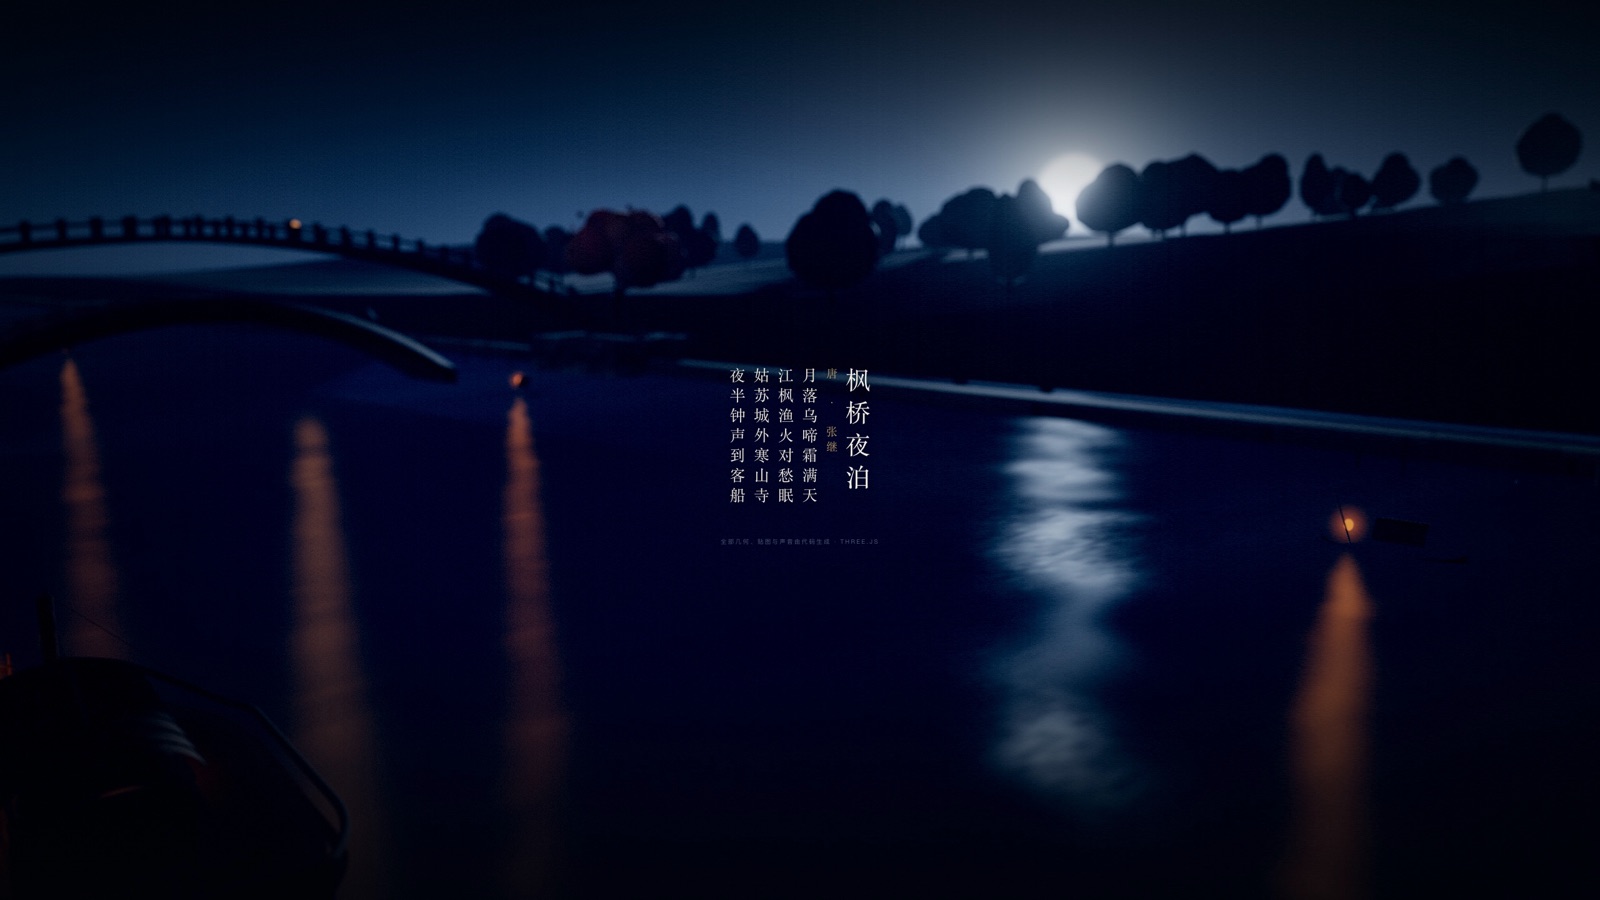
诗意收尾:客船、月影与完整诗篇

图 6:38 秒处的收尾。镜头回到客船,远处寒山寺隐入夜雾,诗名、作者与四句诗依次浮出。

六、三个看得见的坑

第一,阴影贴图不能在首帧之前关掉。

项目一度把 renderer.shadowMap.autoUpdate 设为 false,想省掉每帧更新阴影的开销。结果是首帧没有生成阴影贴图,所有 MeshStandardMaterial 在采样 sampler2DShadow 时失败,整批网格直接不绘制。画面不是「阴影不对」,而是「东西不见了」。现在保持 autoUpdate = true。这条教训很具体:性能优化必须在首帧就验证,不能只看后面的帧率数字。

第二,可重复导出不是默认能力。

树叶、乌鸦、雾和渔火都用了随机数。如果不固定种子,每次导出的帧序列都不一样:第 1200 帧的某片叶子可能在这里,也可能在那里。deterministic.js 在捕获模式下覆盖随机源,导出脚本从 0 秒重放,才让「同一份代码导出同一段视频」成立。

第三,2K / 60 fps 的预算决定了雾的做法。

提示词要求「避免过度使用高成本实时体积渲染」。场景里的雾因此是贴水的横向雾片、寺院前的雾团和极细的霜粒,而不是体积雾;阴影是单主方向光的 2048² PCF;叶簇、叶片、栏杆柱、芦苇、山树全部实例化;像素比上限 1.6。这些选择不显眼,但它们决定了 2400 帧能不能在 349 秒内跑完。

七、导出:2400 帧与两版配乐

成片规格是 ffprobe 实测出来的,不是估计:

项目 实测值
分辨率 / 帧率 2560 × 1440 / 60 fps
时长 / 总帧数 40.000 s / 2400
视频编码 H.264 High Profile Level 5.1,BT.709
视频码率 / 文件大小 39.2 Mbps / 约 188 MiB
音频 AAC LC 192 kbps,48 kHz 立体声
响度 -18.0 LUFS,True Peak -8.9 dBFS
捕获耗时 349 s(约 6.9 fps)

配乐有两个版本。主版本由 scripts/compose-score.py 用 numpy / scipy 程序化合成:水声、风声、鸦鸣、两次寺钟都按时间线写入,不依赖任何外部采样。另一版用 HeyGen 曲库里的古琴 / 箫曲替换音乐层,同时保留画内的水风、鸦鸣和寺钟,画面流直接复制,不做二次编码。

这里的分工也很清楚:画面负责「看见」,声音负责「到达」。 16.5 秒的远钟和 28.6 秒的撞钟不是背景音乐,它们是第四句诗的主语。

八、这份提示词为什么有效

回看这份世界说明书,真正起作用的不是篇幅,而是六种写法。

1. 先写世界基准,再写物件。
提示词第一节不是「要有哪些建筑」,而是天空、山、江、雾、月光的关系。场景因此先有了一条江和两岸的高程,再往上长桥、树、船、寺。

2. 用 hex 和数值代替形容词。
「深蓝黑 #101A2C」「月光银蓝 #B7C9DE」「渔火暖橙 #FFAD58」——这些值直接变成 COLORS 常量,也直接约束了后处理、灯光和水面 shader。形容词只能表达偏好,数值可以验收。

3. 每句诗绑定一个镜头、一个字幕窗口、一个机制。
0–7 秒对应月落与乌啼,7–16 秒对应枫与渔火,16–26 秒对应寺院显形,26–35 秒对应钟声抵达。时间轴不是后期配的,它在提示词里就已经和诗句对齐。

4. 写禁止项。
「不要做成暴雪」「不要科幻雷达波」「不要平面插画代替三维场景」「不允许悬空或穿模」。模型在信息不足时会选最省力的默认值;禁止项就是提前堵住那些默认值。

5. 给可验收的标准。
40 秒、60 fps、2560×1440 或 3840×2160、四句诗对应四个镜头、声波与钟声同步。这些标准可以在浏览器、ffprobe 和截图里逐条检查,而不是「感觉对不对」。

6. 让所有状态由绝对时间推导。
这条提示词没有直接写出「绝对时间」四个字,但它要求时间轴拖动、自动演示、重播和逐帧导出。满足这些要求的唯一稳妥方式,就是让相机、字幕、钟摆、涟漪都成为 t 的函数。

还有一条元规则:让 skill 管 API,让提示词管世界。 提示词不去复述 Three.js 的用法,而是把篇幅留给「这个夜晚应该长什么样、什么时候发生什么」。

九、边界:场景能画到哪里

场景 v1 是风格化还原,不是唐代建筑与船型的考据。石拱桥的拱圈、客船的船体、寺院的屋面,都是从真实形制里抽出来的几何特征,不是实测模型。木材、石材、瓦片、树皮、枫叶的纹理全部由 Canvas 程序化生成;它们可控、可复现,但细节有上限。

比建模更远的边界是「意境」。构建可以通过,脚本可以全绿,ffprobe 可以逐项对上,截图可以非空;但「清冷、孤寂、悠远」最终仍然要人眼看。本文用到的七张配图只做了尺寸与非空校验,没有做人眼审美判断——那一步得留给读者。

还有一层:诗的意义不在几何里。场景能提供的是一个可以走进去的舞台,它不能替代诗,也不应该替代诗。

十、复现

场景是一个独立的 Vite + Three.js 项目,位于 material/枫桥夜泊/。环境要求 Node.js ≥ 20.19,以及支持 WebGL 2 的桌面浏览器。

1
2
3
4
5
6
cd material/枫桥夜泊

npm install
npm run dev # http://localhost:5173
npm run build # 产物在 dist/,base 为 "./"
npm run preview

交互方式:

操作 效果
拖拽 / 滚轮 / 右键拖拽 旋转、缩放、平移;首次操作会暂停影片并进入自由探索
空格 播放 / 暂停
1 – 6 全景、枫桥、江枫、客船、寒山寺、江面
R 重置视角
底部时间轴 拖到任意镜头;松开后保持暂停
雾气 / 字幕 / 声音 独立开关;声音默认关闭,需点击开启
“观看影片” 进入 ?film=1 的纯净 40 秒影片页

导出流程:

1
2
3
4
5
6
7
8
npm run dev -- --port 5188 --strictPort

# 另开终端
npm run export:film -- --url http://127.0.0.1:5188/ --frames deliverables/frames
npm run encode:film -- --frames deliverables/frames \
--out deliverables/fengqiao-yebo-2k60-silent.mp4
npm run score
npm run stills:film -- --url http://127.0.0.1:5188/ --out deliverables/previews

源码与完整交付记录在 open-wuxu/unreal-factory。material/枫桥夜泊/deliverables/REPORT.md 记录了成片规格、资源许可、验收清单与两版配乐的混音参数。

结语:先找到那句诗的「机制」

「绘制」这个词有点误导。我们画的不是一张图,也不是四张配图,而是一组会随时间发生的关系:月亮下沉,树冠摇动,落叶落水,寺院从雾里显形,钟声越过江面,最后抵达客船。

二十八个字里,真正需要工程化的不是名词,而是时间。月落是 40 秒的下沉,钟声是 2.5 秒的抵达,枫叶是 120 个实例的循环。诗不在模型里,在这些时间里。

下次让模型画一首诗,先别急着列名词。先问自己:哪一句里有时间?哪个动作需要一个系统?把那个系统写进第一节。

引用与致谢

  • 提示词原文:prompt/枫桥夜泊.md,与场景源码同在 open-wuxu/unreal-factory。
  • threejs-skills:cloudai-x/threejs-skills,13 个按主题拆分的 Three.js skill,对齐 three.js r186。
  • Three.js:MIT 许可。
  • 场景源码、截图与成片:open-wuxu/unreal-factory 的 material/枫桥夜泊/。文中七张图片取自该项目的 deliverables/previews/。
  • 模型与 harness:DeepSeek-flash4.1 在 Claude Code 中运行。

感谢阅读。
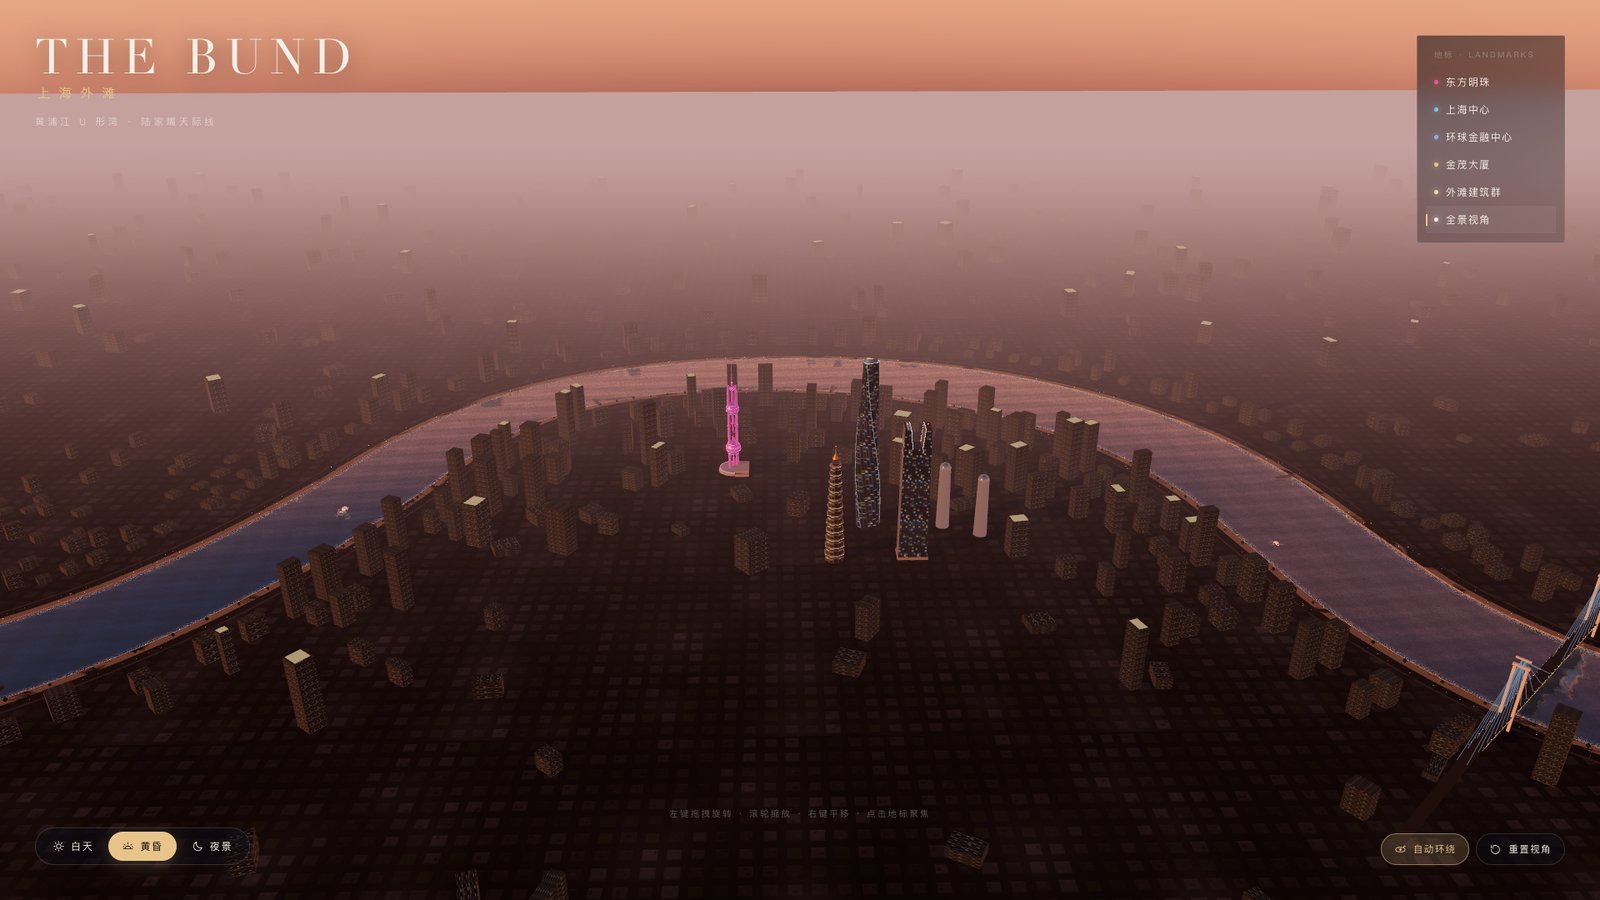
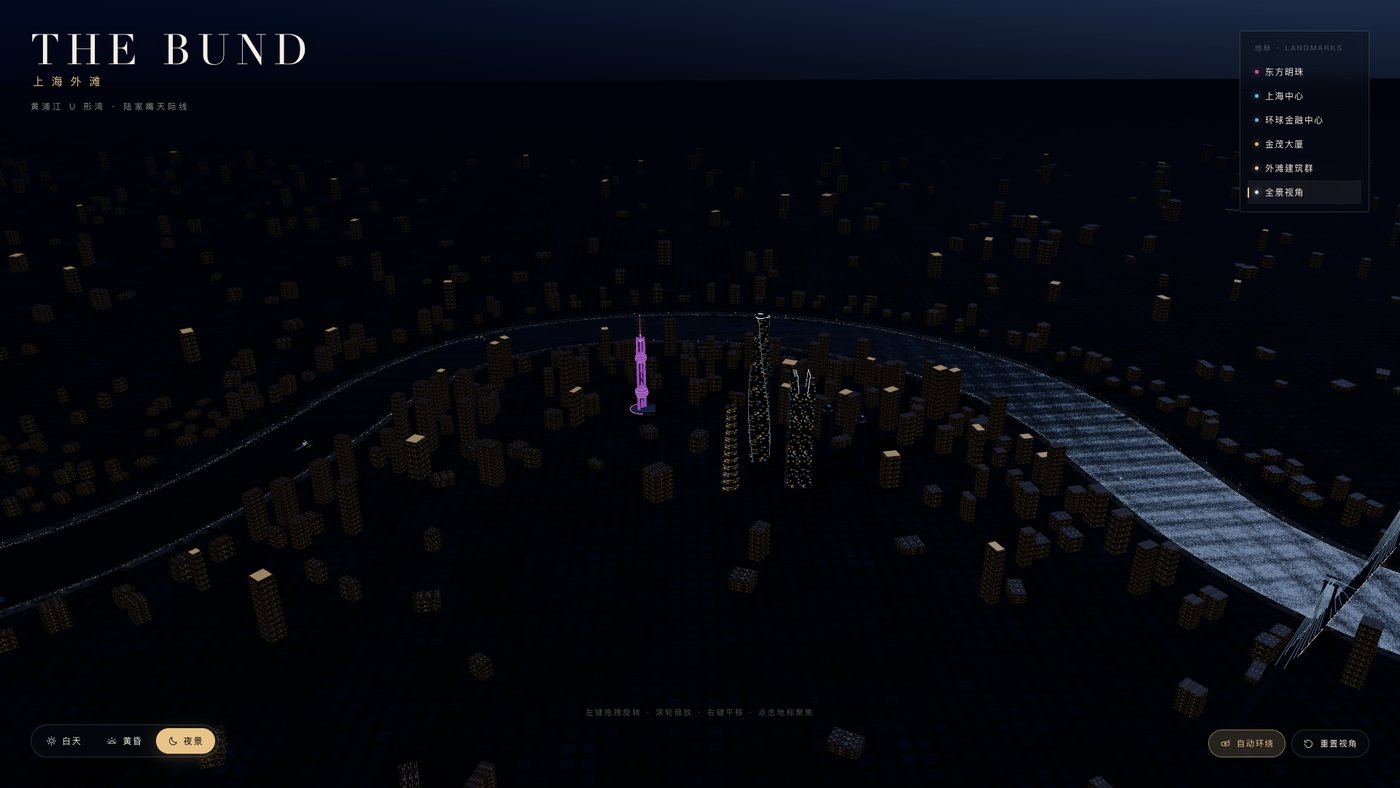
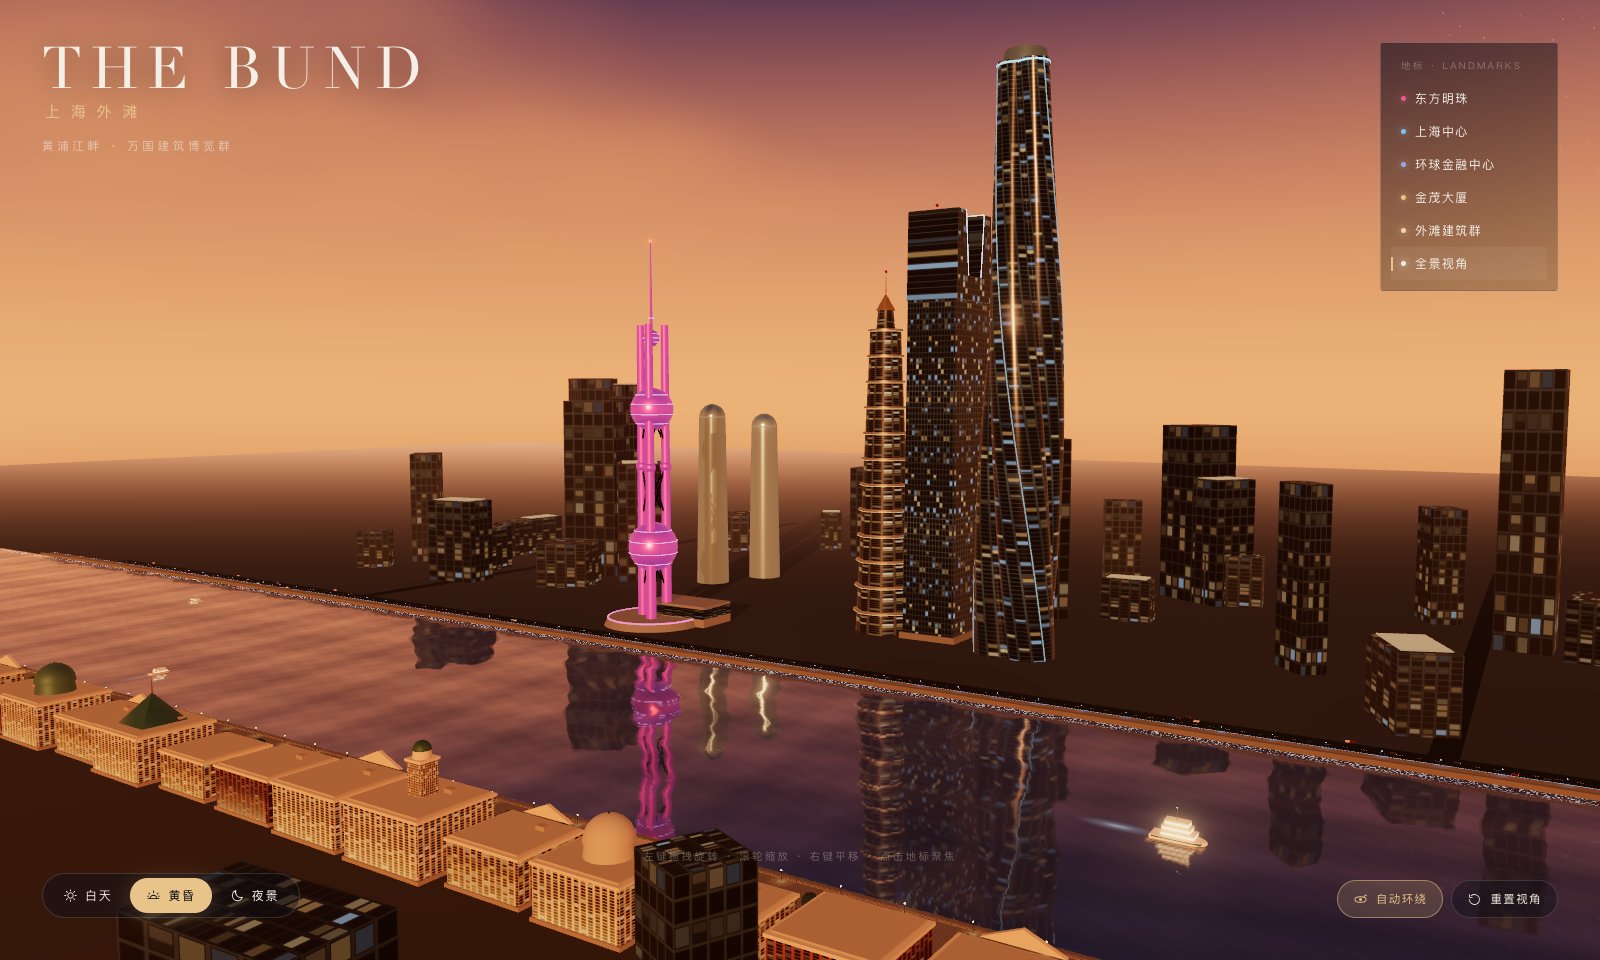
上海外滩 v2.0 的黄昏全景

封面:v2.0 的默认机位。黄浦江从画面左侧远处流入,在陆家嘴北侧绕出一个大弯,再向右前方流出;四座地标落在弯道内侧的半岛上。

模型:DeepSeek-flash4.1;harness:Claude Code;能力来源:一组对齐 three.js r186 的 threejs-skills。

这篇文章复盘的是:同一个模型,为什么第一版只搭出「像外滩的元素」,第二版才搭出「能读出外滩的城」。下文把两份提示词称为「第一版」「第二版」,把产出称为「场景 v1」「场景 v2」,避免混淆。

引言:我要的是一座城,不是一张图

我想让模型替我搭一个可交互的 3D 场景,而不是生成一张图。

「可交互」三个字抬高了门槛。一张图只需要在某个角度成立;一个场景要在任意角度、任意时间状态下都成立。几何、材质、光照、后处理、镜头、性能,任何一项掉链子,画面都会立刻露馅。

我用了两版提示词。第一版要到了外滩的元素,第二版才要到外滩的空间。两版之间的差别,不是字数,而是先说什么。

先说结论:决定这类场景成败的,不是模型会不会写 Three.js,而是提示词有没有把空间关系写成可执行、可验收的约束。 skill 负责让 API 用对,提示词负责让世界成立。

一、工具链:13 个 skill,各管一段

我用的不是「一个 three.js 提示词」,而是一组按主题拆开的 skill。它们来自 cloudai-x/threejs-skills,在项目里由 skills-lock.json 锁定版本,安装后通过 .claude/skills 指向 .agents/skills 下的实体目录。

这一组 skill 都对齐 three.js r186,一共 13 个:

分组 skill 管什么
场景骨架 threejs-fundamentals、threejs-geometry 渲染器、相机、动画循环、内置几何、顶点缓冲、实例化
表面 threejs-materials、threejs-textures、threejs-shaders PBR 材质、程序化贴图、自定义 shader
光与画面 threejs-lighting、threejs-postprocessing 灯光、阴影、Bloom 与合成链
运动与交互 threejs-animation、threejs-interaction 关键帧、控制器、拾取
资源与性能 threejs-loaders、threejs-asset-pipeline、threejs-performance GLTF、资源管线、draw call、内存
React 集成 threejs-react-three-fiber R3F 写法

每个 skill 不是一段「帮我写代码」的咒语,而是一份可检索的领域知识:当前版本的 API 长什么样、哪些写法已经过时、性能上该注意什么。比如 threejs-performance 会先要求你读 renderer.info,再谈优化;threejs-geometry 会把 InstancedMesh 和合并几何放在同一个语境里讲。

这带来一个很重要的分工:skill 解决「怎么写对」,提示词解决「写什么」。

Claude Code 在这条链路里负责把判断落到文件系统和浏览器里:读项目、跑 npm run dev、看控制台报错、改文件、再验证。模型负责在上下文里做决策,harness 负责让决策真的运行起来。

二、第一版:一份「物件清单」

第一版提示词是这样的:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
使用 threejs-skills,创建一个高质量、可交互的 Three.js 3D 城市景观场景。

**场景主题:上海外滩(The Bund, Shanghai)**

要求:
1. 还原上海外滩标志性天际线,包括东方明珠、上海中心大厦、环球金融中心、金茂大厦及黄浦江两岸建筑。
2. 构建具有真实空间层次的 3D 城市环境,建筑使用合理的几何结构、材质和灯光。
3. 设置黄浦江、江面反射、游船、道路及城市灯光。
4. 提供白天、黄昏、夜景三种时间状态切换。
5. 支持鼠标旋转、缩放、平移,以及自动环绕镜头动画。
6. 加入适量动态元素,例如游船移动、灯光变化、江面波纹。
7. 使用 PBR 材质、环境光、阴影和后处理,保证视觉质量及运行性能。
8. 优先使用程序化建模,不依赖付费模型资源;必要时可使用公开授权的 GLTF/GLB 模型。
9. 使用 threejs-skills 中相关 Skill,遵循当前 Three.js API 最佳实践。
10. 最终输出完整可运行的 Web 项目,包含启动说明。

**验收标准:** 场景具有明显的上海外滩辨识度,具有真实的 3D 空间感,交互流畅,支持桌面浏览器运行。

这份提示词写得不算差。它把「一个高质量 Three.js 城市景观」拆成了可以逐条勾选的要求。模型也逐条交付了:四座地标、反射水面、游船、车流、昼夜切换、Bloom、轨道控制器,一个都不缺。

问题出在条目之间没有关系。

河道被实现成 width = 420、length = 7600 的一条直江,水面是一张 PlaneGeometry(430, 7600, 1, 1) 的长方形;两岸是两块 PlaneGeometry(3800, 9000) 的大地,建筑按世界坐标摆上去。默认机位高 285 米,看向 200 米高的目标,视角更接近滨江平视。

于是画面里出现了三个症状:

  1. 没有骨架。 黄浦江是一条直的水带,不是一条河。外滩之所以是外滩,首先因为江水在那里拐了一个弯。
  2. 建筑是孤岛。 每栋楼都按坐标放对了位置,但楼与楼、楼与岸线之间没有生成关系。外滩建筑群像一排摆好的模型,而不是沿着岸线长出来的城市。
  3. 镜头替观众做了选择。 平视镜头能看清单栋楼和滨江步道,但看不到城市形态。读者第一眼看到的是「一排楼」,不是「一座城」。

这不是模型偷懒。提示词只说了「设置黄浦江」,没有说这条江怎么弯、陆家嘴在弯的哪一侧、镜头从哪里看。信息缺失时,模型只能选最省力的补全方式:直线、矩形、平视。它在每个局部都做对了,却在整体上做错了。

三、第二版:把地理写进第一节

第二版提示词换了一个开头:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
使用 threejs-skills,创建一个高品质、具有真实地理空间关系的上海外滩 3D 城市景观。

**核心目标:高度还原参考图中的上海黄浦江大尺度 U 形蜿蜒河道,以及陆家嘴被河流环绕的城市空间形态。**

### 1. 地理与空间布局(最重要)
- 黄浦江必须呈现明显、连续、自然的大尺度 U 形弯曲,而不是直线河道或普通弧形滨江。
- 河道从画面左侧远处延伸,向中央区域大幅弯曲,再绕过陆家嘴区域向右侧远处延伸,形成具有包围感的马蹄形水域轮廓。
- 河流两岸自然分布城市建筑、道路、码头和滨江景观。
- 陆家嘴位于 U 形河道内侧的突出城市区域,呈现半岛般的空间视觉效果。
- 河道宽度、弯曲半径、岸线轮廓应具有真实城市地理尺度,避免规则几何弧线。
- 城市建筑沿河岸自然延伸,不能形成孤立的建筑模型集合。

### 2. 标志性建筑
重点还原陆家嘴天际线:
- 东方明珠电视塔
- 上海中心大厦
- 上海环球金融中心
- 金茂大厦

建筑集中分布在河道弯曲区域内侧,保持合理的高度比例、空间距离和地标辨识度。两岸补充密集的城市建筑群。

### 3. 场景与视觉效果
- 黄浦江采用具有真实反射效果的水面材质。
- 加入游船、货轮及其动态航行轨迹。
- 沿岸布置道路、桥梁、码头和城市灯光。
- 使用 PBR 材质、HDR 环境光、阴影和适当的 Bloom 后处理。
- 默认采用日落至蓝调时刻的光照氛围,天空呈现橙粉色与蓝灰色渐变,城市灯光逐渐亮起。

### 4. 镜头与构图
- 使用高空斜俯视的广角摄影机位,参考真实城市航拍照片。
- 镜头高度足够高,确保完整展示黄浦江 U 形弯道及两岸城市空间。
- 河道弯曲轮廓必须成为画面的核心视觉主体。
- 陆家嘴地标建筑群位于画面中央偏后位置。
- 不采用地面平视视角,不要只展示单栋建筑或局部滨江景观。

### 5. 交互与动画
- 支持鼠标旋转、缩放、平移。
- 提供自动环绕镜头展示。
- 支持白天、黄昏、夜景切换。
- 游船沿河道连续移动。
- 江面具有动态波纹和环境反射。

### 6. 技术要求
- 使用 threejs-skills 中相关 Skill。
- 使用 Three.js + WebGL,优先程序化建模。
- 采用合理的几何分段和曲线控制构建自然河岸及河道。
- 使用 CatmullRomCurve3 等曲线技术构建河流中心线和岸线,再生成连续水面网格。
- 建筑、道路、河岸、水面分别建模,保持空间关系一致。
- 优化 Draw Calls、阴影和粒子数量,保证浏览器流畅运行。

**最终验收标准:**
第一眼能够识别出上海陆家嘴和黄浦江;从整体俯视视角能够清晰看到黄浦江环绕陆家嘴的大尺度 U 形蜿蜒轮廓。河流必须具有真实自然的曲折效果,而不是一条直线或简单圆弧。

输出完整可运行的 Web 项目,并提供启动说明。

相比第一版,真正的改动只有四处,但每一处都改变了模型的行为。

第一,把地理放到第一节,并标注「最重要」。 提示词里的顺序就是模型的注意力顺序。第一版把「地标」放在第 1 条,模型就先堆地标,再补河;第二版先定义河,地标只是河湾内侧的产物。

第二,把形容词换成可执行的几何。 「U 形」「从画面左侧远处延伸」「向中央区域大幅弯曲」「绕过陆家嘴区域向右侧远处延伸」「马蹄形」「真实城市地理尺度」——这些描述可以直接变成一条曲线上的控制点和一段宽度函数(实现时河宽落在 390–620 米之间),而不是一句「要有外滩的感觉」。

第三,给出实现路径。 「使用 CatmullRomCurve3 等曲线技术构建河流中心线和岸线,再生成连续水面网格」「建筑、道路、河岸、水面分别建模,保持空间关系一致」。这不是替模型写代码,而是告诉它:用一条曲线作为所有沿江构件的共同基准。

第四,写禁止项和验收标准。 「而不是直线河道或普通弧形滨江」「不采用地面平视视角」「不要只展示单栋建筑或局部滨江景观」——这三句排除错误解;「第一眼能够识别出上海陆家嘴和黄浦江」「从整体俯视视角能够清晰看到……U 形蜿蜒轮廓」——这两句给出可以被眼睛检查的通过条件。

这三层合起来,才是第二版真正有效的原因:约束可执行,结果可验收,优先级明确。

四、落到代码:河道成为唯一空间基准

提示词里那句「用 CatmullRomCurve3 构建中心线」,最后落成了一个 src/world/river.js。它只做一件事:把整条黄浦江变成一套可以查询的空间坐标。

1
2
3
4
5
6
7
8
const curve = new THREE.CatmullRomCurve3(
RIVER.controlPoints.map(([x, z]) => new THREE.Vector3(x, 0, z)),
false,
"centripetal",
);

const spaced = curve.getSpacedPoints(900);
const length = curve.getLength();

29 个控制点定义了河道的走向,按弧长均匀采样 900 段,得到每个采样点的位置、切线、法线和半宽。这里用 centripetal 参数化,是为了减少急弯处的过冲——河道弯得越急,普通 Catmull-Rom 越容易在控制点之间甩出一段不自然的弧线。

紧接着是一段容易被忽略、但不写就会出事的逻辑:

1
2
const radius = angle > 1e-5 ? arc / angle : Infinity;
samples[i].halfWidth = Math.min(samples[i].halfWidth, radius * 0.62);

岸线不是单独画的,而是中心线向两侧偏移「半宽」得到的。弯太急、河太宽,偏移后的内岸会自己穿过自己。所以急弯处必须收窄河宽,0.62 是给偏移留的安全余量;之后再跑两遍平滑,避免宽度在曲率突变处出现折角。

有了这套采样,river 对外只暴露几个查询:

1
2
3
4
5
river.pointAt(u);              // 弧长参数 u ∈ [0,1] 上的点
river.tangentAt(u); // 该点的切线方向
river.bankPoint(u, side); // 岸线取点,+1 为浦西/外滩,-1 为浦东/陆家嘴
river.lanePoint(u, offset); // 江面航线取点
river.nearest(x, z); // 陆地 / 水面判定

然后,所有沿江构件都从这里取点:

  • 水面沿着中心线生成连续 ribbon,而不是一张矩形平面;边缘带 aEdge 属性,用来画贴岸泡沫。
  • 陆地是一整块 ShapeGeometry,河道作为 Path 孔洞挖掉,避免水面和地面互相穿插。
  • 岸墙、步道、滨江道路用 createRibbonGeometry / createBankWallGeometry 沿河生成。
  • 外滩 16 栋历史建筑沿着浦西一侧的 bankPoint 逐栋排布,并朝向江面。
  • 游船和货轮沿着中心线偏移出的航线航行,用 tangentAt 自动跟随弯道转向。

这套结构的价值不在「代码更优雅」,而在改一个地方,全场景跟着变。修改一个控制点,水面、岸线、道路、步道、建筑、船只航线会同时移动;而在场景 v1 里,想挪一下河,得分别改水面、岸墙、道路和建筑。

提示词把「河道是基准」说清楚之后,代码自然长成了「一个中枢 + 多个消费者」。这是我觉得这次迭代里最值得记下来的一点:好的提示词不只描述结果,还会暗示结构。

五、两版放在一起看

场景 v1 场景 v2
河道 沿 Z 轴的直线河道 CatmullRomCurve3 中心线生成的大尺度 U 形弯道
河岸 两条直线岸墙 沿曲线偏移生成、宽度随河道变化的连续岸线
水面 矩形平面 沿河道的连续 ribbon 网格,岸边泡沫随岸线变化
陆地 两块大平面 带河道孔洞的连续地块,道路、步道、建筑共享河岸坐标
城市 以直线路网布置 建筑、道路、车辆、树木、路灯、码头都沿河岸曲线延伸
船 沿 Z 轴往返 沿河道中心线的不同航线连续航行,自动跟随弯道转弯
镜头 平直滨江视角 高空斜俯视,完整展示 U 形江湾与半岛
新增 — 货轮、两座跨江桥、码头上盖、远景城市、城市底图纹理

场景 v1 的预览:直线河道与两块大平面

图 1:场景 v1。元素齐全,但河道是一条直的水带,城市沿两条直线岸线铺开——第一眼看到的是「一排楼」,不是一座城。

场景 v2 的夜景

图 2:场景 v2 的夜景。同一条江被重新定义成一条曲线,陆家嘴三面环水,建筑、道路、船只都沿着这条曲线展开;昼夜系统在 1.9 秒内统一插值天空、太阳、雾、曝光、泛光和所有窗灯,水面参数也参与过渡。

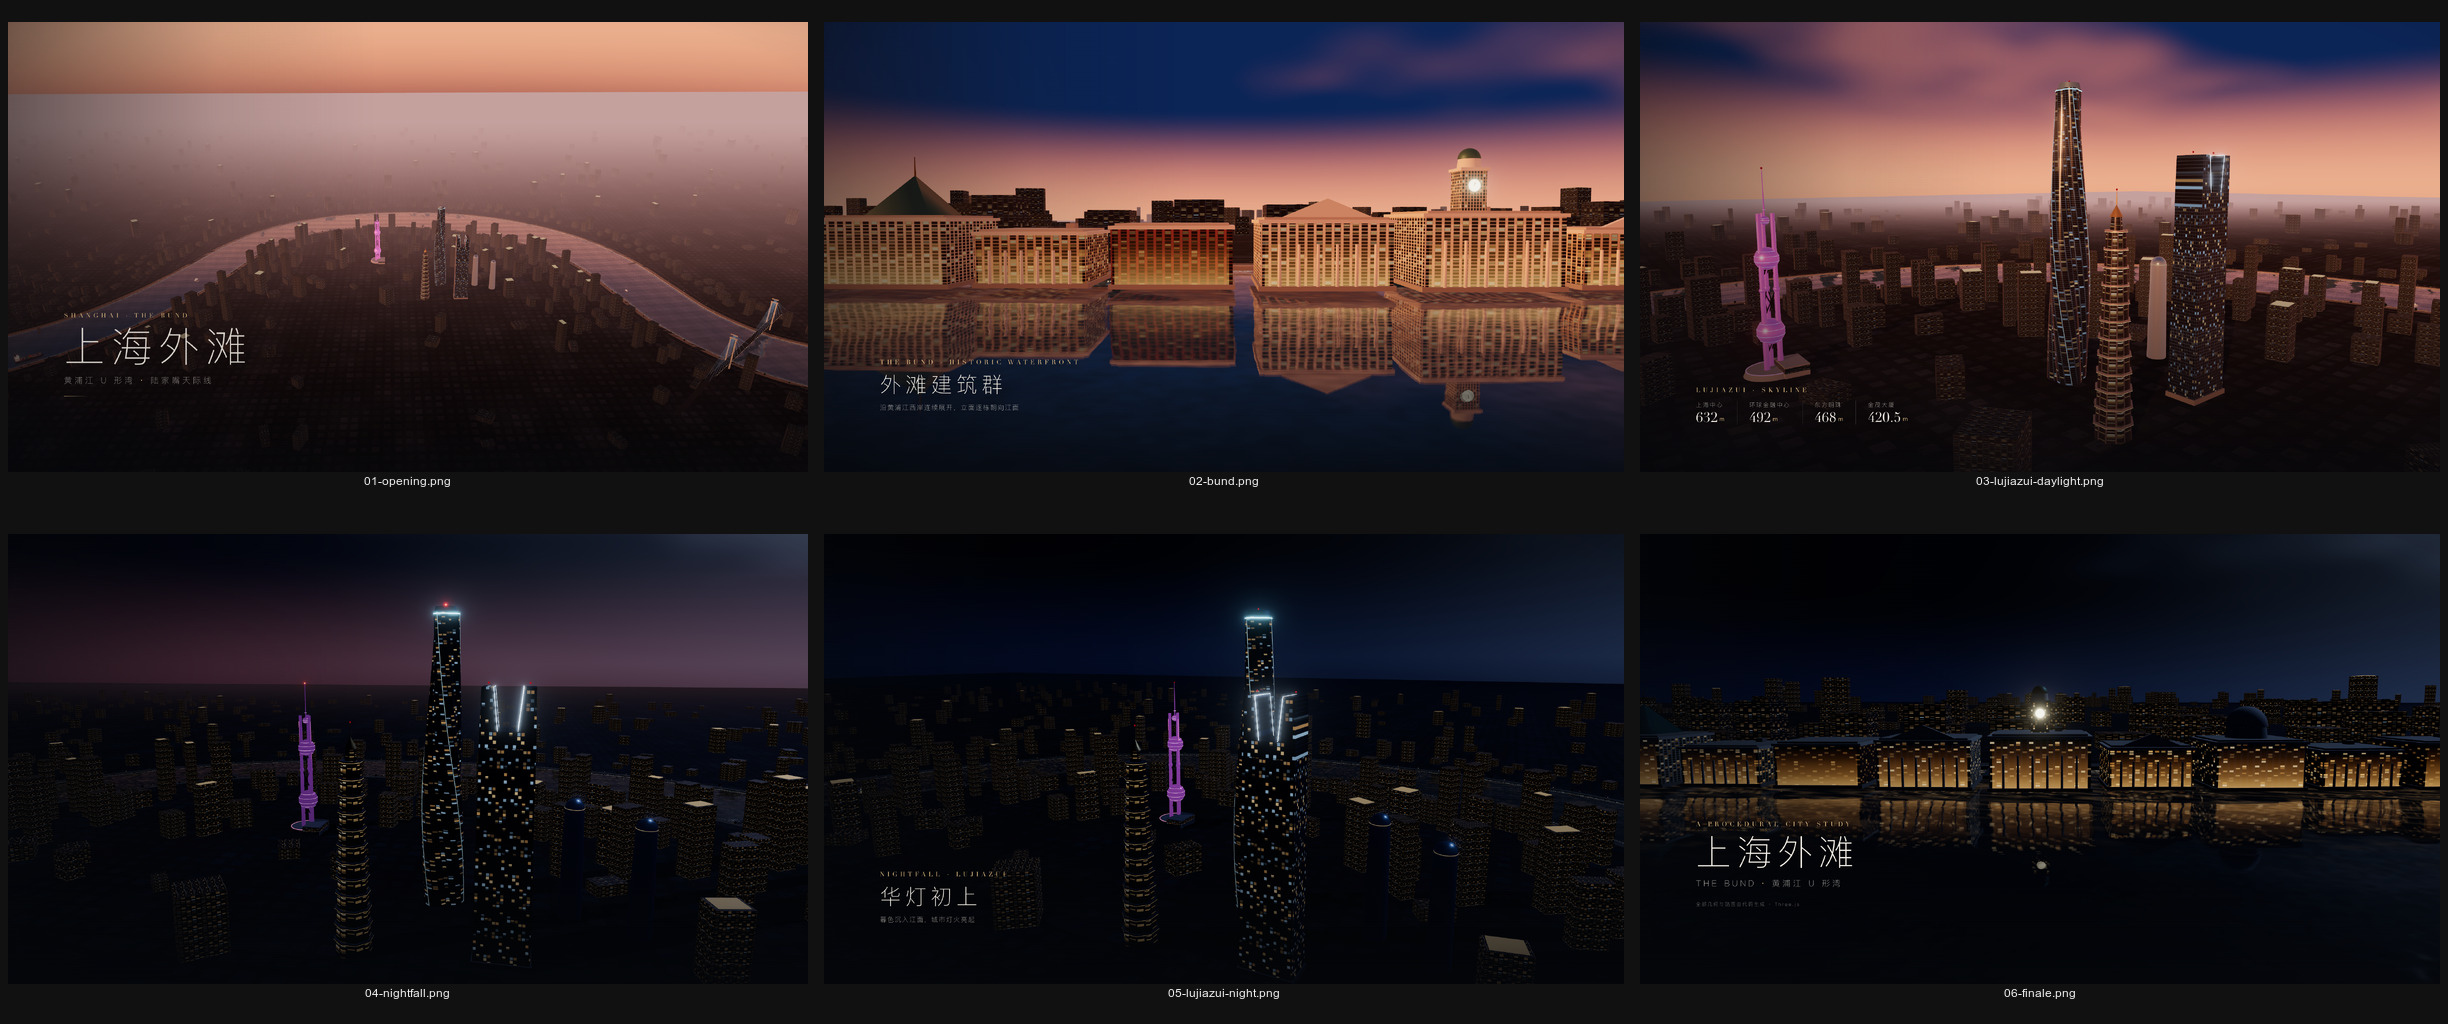
场景 v2 做完之后,同一套场景还被用来导出了一段 28 秒的影片:四个固定镜头从 U 形江湾俯冲进入外滩立面,再环绕陆家嘴四塔,在镜头内完成黄昏到夜景的过渡。下面这张联系表是其中的六帧:

场景 v2 影片模式的六帧关键画面

图 3:v2.0 影片模式的六帧联系表(01-opening → 06-finale)。固定时间线让相机、昼夜和字幕都由绝对时间推导,因此每次导出的帧序列一致。

六、把这次迭代抽成六条写法

如果下次还要让模型搭一个「有地理关系」的场景,我会按这六条写提示词。

1. 先空间,后物件,再氛围。
先定义场景的骨架——哪条线决定其他一切;再列地标和物件;最后谈材质、灯光、后处理。顺序不是排版偏好,而是模型的注意力分配。

2. 把「像」翻译成可验证的关系。
「要有外滩的感觉」无法执行;「河道从左侧远处流入,绕过陆家嘴,再向右远处流出,形成马蹄形」可以。能变成控制点、宽度函数、相机坐标的描述,才是有效描述。

3. 给实现路径,但不锁死细节。
「用 CatmullRomCurve3 构建中心线和岸线」是在指定结构;「用 29 个控制点、900 段采样、三条正弦叠加河宽」就是过度干预。前者让模型少走弯路,后者会让它把注意力花在满足数字上。

4. 写禁止项。
「不要直线」「不要地面平视」「不要孤立建筑」比正面描述更能排除错误解。模型在信息不足时会选最省力的默认值,禁止项就是提前堵住那些默认值。

5. 验收标准要能被眼睛检查。
「第一眼能识别出陆家嘴和黄浦江」「俯视能看到 U 形轮廓」——这类标准可以在浏览器里直接判断。不要写「视觉质量高」这种说了等于没说的句子。

6. 一次只改一个维度。
第二版把主要精力放在空间关系上,材质、光照和后期沿用同一套方案。这样两版之间的差异才能归因:画面变好了,是因为河变了,不是因为同时加了十盏灯。

还有一条元规则:让 skill 管 API,让提示词管意图。 不要用提示词去重复 skill 里已经写好的 Three.js 用法;把提示词的篇幅留给「这个世界应该长什么样」。

七、边界:提示词能走多远

场景 v2 仍然是风格化还原,不是测绘。

四座地标是参数化近似:东方明珠的三根立柱和三个球体、上海中心的 120° 扭转三叶截面、环球金融中心的「开瓶器」顶部、金茂大厦的逐层收分,都是从真实形态里抽出来的几何特征,不是实测模型。河宽是正弦叠加出来的,岸线是曲线偏移出来的,不是从地理数据里读出来的。

再往前一步,问题就换了。第三版提示词要的是 1:1 真实地理:真实岸线、真实建筑位置和高度、统一坐标参考系、OSM/GIS/Cesium/Blender、以米为单位的世界比例,还要求「缺少真实数据时先报告缺失项,不得用虚构数据冒充真实城市模型」。这次工作暂时停在「数据源调研与坐标系统」这一步,没有继续往下做。

这不是提示词写坏了,而是提示词能提高上限,但不能替代数据。当目标从「像外滩」变成「是外滩」时,主要的工程量在数据获取、坐标转换、缺失值标注和精度验收上,不在措辞上。

还有一层边界是视觉终检。构建可以通过、产物可以非空、图片可以被解析,但「像不像外滩」最终仍然要人眼看。工具能保证场景跑起来,不能保证它好看。

八、复现

场景 v1 和 v2 是两个相互独立的 Vite 项目,各自带 package.json 和构建配置。环境要求 Node.js ≥ 20.19,以及支持 WebGL 2 的桌面浏览器。

1
2
3
4
5
6
cd material/上海外滩v2.0

npm install
npm run dev # 默认 http://localhost:5173
npm run build # 产物在 dist/,使用相对路径,可部署到任意子目录
npm run preview # 本地预览构建产物

交互方式:

操作 效果
左键拖拽 旋转视角
滚轮 / 双指 缩放
右键拖拽 / 双指拖动 平移
右上角地标列表 飞行到东方明珠、上海中心、环球金融中心、金茂大厦、外滩建筑群
底部时间切换 白天 / 黄昏 / 夜景(1.9 秒平滑过渡)
自动环绕 开启或关闭自动环绕镜头
键盘 1 2 3 切换时间
键盘 Space 自动环绕开关
键盘 R 重置视角

源码在 open-wuxu/unreal-factory。material/上海外滩v1.0/ 是直线河道的存档版本,material/上海外滩v2.0/ 是当前主版本。

结语:先找到那条「河道」

「绘制」这个词有点误导。我们画的不是一张图,是一组关系:河道决定岸线,岸线决定道路和建筑,建筑决定天际线,镜头决定读者第一眼看到什么。

第一版提示词列全了物件,却没有定义关系,所以模型只能把它们并排放在一起;第二版只多说了几句关于河的话,整座城就跟着河长了出来。

下次让模型搭场景,先别急着列地标。先问自己:这个场景的「河道」是什么?哪一条线一旦定了,其他东西都得跟着它走?

把那条线写进第一节。

引用与致谢

  • threejs-skills:cloudai-x/threejs-skills,13 个按主题拆分的 Three.js skill,对齐 three.js r186。
  • Three.js:MIT 许可。
  • 场景源码与截图:open-wuxu/unreal-factory。文中四张图片均由该项目的场景 v1 / v2 生成;图 3 的联系表来自 v2.0 的影片模式。
  • 模型与 harness:DeepSeek-flash4.1 在 Claude Code 中运行。

感谢阅读。
加利西亚省科斯塔达莫尔特的灯塔,西班牙--死亡海岸

从数据结构选择到扩容、删除与工程边界

引言

写一个能跑的哈希表不难。难的是,每到一个设计分叉路口,你都得做出选择:哈希函数用什么、冲突怎么解、扩容何时触发、删除如何处理、遍历应该遵守什么规则。

标准库替你做完了这些选择,所以平时使用 map 时,很容易只看到接口,看不到背后的权衡。自己从零实现一遍,这些问题才会逐个浮现。

本文按“设计决策”的顺序展开:先提出问题,再比较可选方案,最后说明本文的选择及其代价。代码使用 Go,但核心思路与语言无关。

本文实现的是一个用于学习的数据结构,不追求替代 Go 原生 map。它采用字符串 key、链地址法和全量扩容,目标是让关键机制清楚、可验证。

下面三张图分别对应「整体结构」「key 怎么落到桶」「桶满了怎么搬」这三个最容易被标准库遮住的部分。

图 1:桶数组只负责给出入口,链表负责承担冲突——所以查找成本是「1 次索引计算 + 一条链的长度」,而不是全表扫描;代价是每个元素都要多一次指针和内存分配。

决策一:底层用什么结构?

问题:哈希表要保存 key-value,底层容器应该怎么选?

常见方案有三类:

  1. 纯链表:所有元素放在一条链上,查找需要逐个比较,平均查找成本随元素数量增长,不能发挥哈希索引的优势。
  2. 数组 + 链地址法:数组中的每个位置称为桶;映射到同一个桶的元素,通过链表或其他小型容器组织起来。
  3. 数组 + 开放寻址:所有元素都保存在数组中;遇到冲突时,按一定的探测序列继续寻找位置。

本文选择数组 + 链地址法。原因是它实现直观,删除时可以通过修改链表指针移除节点;负载因子也可以超过 1。不过,链表会引入额外指针和内存分配,冲突链过长时,查找仍可能退化到 O(n)。

开放寻址通常具有更紧凑的内存布局,但删除需要处理墓碑等状态,且性能对装载程度更敏感。这里选择链地址法,是为了突出哈希表的基本机制,而不是宣称它在所有场景中更优。

1
2
3
4
5
6
7
8
9
10
type entry struct {
key string
value interface{}
next *entry
}

type HashMap struct {
buckets []*entry
size int
}

决策二:哈希函数与桶索引怎么设计?

问题:如何把字符串 key 映射到桶数组中的一个位置?这里其实包含两个独立步骤:先计算哈希值,再把哈希值映射为有效的桶索引。

哈希函数负责将 key 转换为一个固定宽度的数值;索引计算则根据当前桶数量,把这个数值映射到 [0, bucketCount) 范围内。扩容会改变桶数量,因此索引可能变化,但哈希函数本身不必改变。

常见选择包括使用语言或运行时提供的哈希函数,使用 FNV-1a、MurmurHash、xxHash 等现成算法,或者为特定数据设计哈希函数。直接对 key 取模并不能替代哈希函数:字符串需要先转换成数值,才能计算桶索引。

本文选择 FNV-1a,主要是因为算法短小、容易手写,适合教学。它不是加密哈希,也不能抵御恶意碰撞攻击;生产系统应优先考虑运行时或经过充分评估的哈希实现。

1
2
3
4
5
6
7
8
func hashString(s string) uint32 {
h := uint32(2166136261)
for i := 0; i < len(s); i++ {
h ^= uint32(s[i])
h *= 16777619
}
return h
}

桶数量采用 2 的幂,例如 8、16、32。此时可以用 h & (m-1) 计算索引,而不是 h % m。对于 m 为 2 的幂的情况,两种计算在数学上等价;位掩码只是索引计算方式更直接,并不会自动改善哈希分布。由于它只使用哈希值的低位,哈希函数低位的分布质量仍然重要。

1
2
3
func (m *HashMap) index(key string) int {
return int(hashString(key) & uint32(len(m.buckets)-1))
}

这个选择也约束了后续扩容:桶数量需要保持为 2 的幂。本文采用翻倍扩容,不采用增加任意素数或乘以 1.5 的策略。

图 2:哈希函数和索引计算是两步,扩容只改第二步。把桶数定成 2 的幂,换来的是「取模变位与」,代价是分布质量全部压在哈希值的低位上。

决策三:冲突怎么解决?

问题:不同 key 可能映射到同一个桶。链地址法把这些元素放在同一条链表中,查询时遍历链表并比较 key。

本文将新节点插入链表头部。头插只需要修改新节点的 next 指针和桶头指针,代码简单,也不需要遍历到链表尾部。它不保证查询更快:只有在新插入元素更容易被访问等特定访问模式下,头插才可能带来平均查找收益。哈希表本身也不承诺遍历顺序。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
func (m *HashMap) Set(key string, value interface{}) {
idx := m.index(key)

for e := m.buckets[idx]; e != nil; e = e.next {
if e.key == key {
e.value = value
return
}
}

m.buckets[idx] = &entry{
key: key,
value: value,
next: m.buckets[idx],
}
m.size++

if float64(m.size)/float64(len(m.buckets)) > loadFactor {
m.resize()
}
}

这里先查找已有 key。若 key 已存在,只更新 value,不增加元素数量,也不触发扩容;只有新增 key 才会增加 size。

决策四:负载因子与扩容时机怎么定?

负载因子定义为 α = n / m,其中 n 是元素数量,m 是桶数量。链地址法允许 α 超过 1,但负载因子越高,平均每个桶中的元素通常越多。

本文将扩容阈值设为 0.75,超过阈值后桶数翻倍。这是一个便于教学的经验值,不是链地址法的理论常数。阈值过低会占用更多桶数组空间;阈值过高则可能增加冲突链长度。实际系统应结合内存、访问模式、哈希分布和性能目标选择阈值。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
const loadFactor = 0.75

func (m *HashMap) resize() {
old := m.buckets
m.buckets = make([]*entry, len(old)*2)

for _, head := range old {
for e := head; e != nil; {
next := e.next

idx := m.index(e.key)
e.next = m.buckets[idx]
m.buckets[idx] = e

e = next
}
}
}

为什么要先保存 next?因为后续会重写 e.next,把当前节点接到新桶链表中。如果不提前保存原来的 next,就会丢失旧链表中尚未迁移的后续节点。

当前实现会重新计算每个 key 的哈希值。由于桶数量翻倍,旧索引与新索引之间其实存在更简单的关系:元素只会留在原索引对应的桶,或者移动到旧索引加旧桶数量的位置。实现可以缓存哈希值或利用该关系优化迁移,但为了让示例聚焦核心逻辑,这里暂不优化。

扩容时机采用“先插入,再判断”。因此触发扩容的那次插入会先进入旧桶数组,再迁移到新数组。严格使用 > 0.75,也意味着负载因子在某次插入后可能暂时超过阈值。

图 3:桶数翻倍时,旧桶 i 的元素只会去新桶 i 或 i + m——这是 2 的幂增长带来的性质,而不是巧合。一次扩容要搬 O(m+n) 个节点,代价是一次明显的停顿;而「只去两个桶」本可以拿来优化迁移,本文为了突出核心逻辑没有这么做。

决策五:删除怎么处理?

链地址法删除节点时,需要找到目标节点,并修改桶头指针或前驱节点的 next 指针。删除头节点和删除链表中间节点是两个需要覆盖的边界情况。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
func (m *HashMap) Delete(key string) {
idx := m.index(key)
var prev *entry

for e := m.buckets[idx]; e != nil; e = e.next {
if e.key == key {
if prev == nil {
m.buckets[idx] = e.next
} else {
prev.next = e.next
}
m.size--
return
}
prev = e
}
}

如果 key 不存在,方法不修改任何状态。链地址法删除后不需要墓碑,因为从桶链表中移除节点不会影响其他节点的查找路径。开放寻址则不同:直接清空某个槽位可能切断后续探测路径,因此通常需要墓碑或其他删除修复机制。

本文没有实现缩容。大量删除后,桶数组可能比当前元素数量所需的空间更大。缩容可以减少空间占用,但也会带来重建成本;如果元素数量在阈值附近波动,还可能出现反复扩容和缩容。因此,缩容应作为独立设计决策,并通过不同的扩容、缩容阈值避免频繁抖动。

决策六:怎么遍历所有元素?

常见接口包括返回元素切片、提供按需推进的迭代器,或者提供回调式 Range。本文选择 Range:不必先创建包含所有元素的副本,并且可以通过回调返回 false 提前终止。

1
2
3
4
5
6
7
8
9
func (m *HashMap) Range(fn func(key string, value interface{}) bool) {
for _, head := range m.buckets {
for e := head; e != nil; e = e.next {
if !fn(e.key, e.value) {
return
}
}
}
}

本文规定:Range 执行期间,不允许修改哈希表结构。原因是插入、删除和扩容都会改变桶或链表结构,可能导致元素遗漏、重复访问等问题。这个限制是本实现主动定义的 API 契约,并不是说 Go 原生 map 在遍历期间的所有写入都一律非法。

Go 原生 map 对遍历期间插入和删除有自己的语言规范语义;并发读写则是另一类问题。运行时可能检测到部分并发读写并触发 fatal error,但不能把它等同于普通的同 goroutine 遍历期间修改。

决策七:并发安全要不要支持?

本文选择不提供并发安全保证,并要求调用方自行同步访问。这样可以避免把锁管理引入基础实现,但并不意味着加锁一定会明显拖慢所有单线程场景;实际成本取决于实现、竞争程度和访问模式。

如果需要并发访问,可以在外层使用 sync.RWMutex 保护整个哈希表,也可以根据 key 分片加锁。不过,分片锁会增加实现复杂度,而且需要谨慎处理扩容、遍历以及跨分片操作。

Go 原生 map 同样不提供通用的并发读写安全保证。sync.Map 是针对特定并发访问模式设计的另一种类型,并不是所有场景下都能直接替代带锁的 map。

完整代码

下面是前述设计决策组合后的完整实现。为保持代码聚焦,实例必须通过 New 创建;零值 HashMap 不可直接使用。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
package hashmap

const loadFactor = 0.75

type entry struct {
key string
value interface{}
next *entry
}

type HashMap struct {
buckets []*entry
size int
}

func New() *HashMap {
return &HashMap{buckets: make([]*entry, 8)}
}

func hashString(s string) uint32 {
h := uint32(2166136261)
for i := 0; i < len(s); i++ {
h ^= uint32(s[i])
h *= 16777619
}
return h
}

func (m *HashMap) index(key string) int {
return int(hashString(key) & uint32(len(m.buckets)-1))
}

func (m *HashMap) Set(key string, value interface{}) {
idx := m.index(key)
for e := m.buckets[idx]; e != nil; e = e.next {
if e.key == key {
e.value = value
return
}
}

m.buckets[idx] = &entry{
key: key, value: value, next: m.buckets[idx],
}
m.size++

if float64(m.size)/float64(len(m.buckets)) > loadFactor {
m.resize()
}
}

func (m *HashMap) Get(key string) (interface{}, bool) {
for e := m.buckets[m.index(key)]; e != nil; e = e.next {
if e.key == key {
return e.value, true
}
}
return nil, false
}

func (m *HashMap) Delete(key string) {
idx := m.index(key)
var prev *entry

for e := m.buckets[idx]; e != nil; e = e.next {
if e.key == key {
if prev == nil {
m.buckets[idx] = e.next
} else {
prev.next = e.next
}
m.size--
return
}
prev = e
}
}

func (m *HashMap) Len() int {
return m.size
}

func (m *HashMap) resize() {
old := m.buckets
m.buckets = make([]*entry, len(old)*2)

for _, head := range old {
for e := head; e != nil; {
next := e.next
idx := m.index(e.key)
e.next = m.buckets[idx]
m.buckets[idx] = e
e = next
}
}
}

func (m *HashMap) Range(fn func(key string, value interface{}) bool) {
for _, head := range m.buckets {
for e := head; e != nil; e = e.next {
if !fn(e.key, e.value) {
return
}
}
}
}

复杂度分析:这些选择带来了什么?

令 n 为元素数量,m 为桶数量,α = n / m 为负载因子。以下平均复杂度假设哈希分布合理,并暂时忽略字符串哈希计算本身的成本;若 key 长度为 L,计算哈希值通常还需要 O(L) 时间。

单次 Set 可能因为扩容而产生 O(m+n) 的成本,但在合理的翻倍扩容策略下,连续插入操作的扩容成本可以摊还到多次插入中。摊还复杂度较低,并不代表每一次操作的延迟都相同;如果系统特别关注尾延迟,就需要进一步研究分批迁移等策略。

测试:如何验证设计决策?

数据结构代码不能只靠“能跑”来证明正确。至少应该验证更新是否改变 size、删除边界是否正确、扩容后元素是否仍可访问,以及 Range 是否支持提前终止。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
package hashmap

import (
"fmt"
"math/rand"
"testing"
)

func TestSetGetUpdateDelete(t *testing.T) {
m := New()

m.Set("name", "Alice")
got, ok := m.Get("name")
if !ok || got != "Alice" {
t.Fatalf("Get(name) = (%v, %v), want (Alice, true)", got, ok)
}

m.Set("name", "Bob")
if m.Len() != 1 {
t.Fatalf("Len() = %d, want 1 after update", m.Len())
}

got, ok = m.Get("name")
if !ok || got != "Bob" {
t.Fatalf("Get(name) = (%v, %v), want (Bob, true)", got, ok)
}

m.Delete("missing")
if m.Len() != 1 {
t.Fatalf("Len() = %d, want 1 after deleting missing key", m.Len())
}

m.Delete("name")
if _, ok := m.Get("name"); ok {
t.Fatal("key should not exist after Delete")
}
if m.Len() != 0 {
t.Fatalf("Len() = %d, want 0 after Delete", m.Len())
}
}

func TestResizeKeepsEntries(t *testing.T) {
m := New()
const count = 1000

for i := 0; i < count; i++ {
key := fmt.Sprintf("key-%d", i)
m.Set(key, i)
}

if m.Len() != count {
t.Fatalf("Len() = %d, want %d", m.Len(), count)
}

for i := 0; i < count; i++ {
key := fmt.Sprintf("key-%d", i)
got, ok := m.Get(key)
if !ok || got != i {
t.Fatalf("Get(%q) = (%v, %v), want (%d, true)", key, got, ok, i)
}
}
}

func TestRangeCanStopEarly(t *testing.T) {
m := New()
for i := 0; i < 10; i++ {
m.Set(fmt.Sprintf("key-%d", i), i)
}

visited := 0
m.Range(func(key string, value interface{}) bool {
visited++
return false
})

if visited != 1 {
t.Fatalf("visited = %d, want 1", visited)
}
}

哈希函数也可以脱离哈希表单独验证:它只负责把字符串变成 32 位整数,不关心桶。直接对照 FNV-1a 的标准测试向量即可。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
func TestHashStringMatchesFNV1a(t *testing.T) {
cases := []struct {
input string
want uint32
}{
{"", 0x811c9dc5},
{"a", 0xe40c292c},
{"foobar", 0xbf9cf968},
}
for _, c := range cases {
if got := hashString(c.input); got != c.want {
t.Errorf("hashString(%q) = %#x, want %#x", c.input, got, c.want)
}
}
}

删除需要分别覆盖链表头、链表中间和链表尾。要构造稳定的冲突链,不能靠猜哈希分布,而应该用 index 反查:不断生成 key 并按桶分组,取凑够数量的那一组。下面的辅助函数属于白盒测试,因此与实现放在同一个包里。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
// pickCollidingKeys 返回 n 个落在同一个桶里的 key。
func pickCollidingKeys(t *testing.T, m *HashMap, n int) []string {
t.Helper()

groups := make(map[int][]string)
for i := 0; i < 1000000; i++ {
key := fmt.Sprintf("collide-%d", i)
idx := m.index(key)
groups[idx] = append(groups[idx], key)
if len(groups[idx]) >= n {
return groups[idx][:n]
}
}
t.Fatalf("failed to find %d keys in the same bucket", n)
return nil
}

// chainKeys 按表头到表尾的顺序读出桶里的 key。
func chainKeys(m *HashMap, idx int) []string {
var keys []string
for e := m.buckets[idx]; e != nil; e = e.next {
keys = append(keys, e.key)
}
return keys
}

func TestDeleteHeadMiddleTail(t *testing.T) {
m := New()
keys := pickCollidingKeys(t, m, 3) // 头插后链序为 keys[2] -> keys[1] -> keys[0]

for _, k := range keys {
m.Set(k, k)
}

idx := m.index(keys[0])
if got := chainKeys(m, idx); len(got) != 3 || got[0] != keys[2] || got[1] != keys[1] || got[2] != keys[0] {
t.Fatalf("chain = %v, want [%s %s %s]", got, keys[2], keys[1], keys[0])
}

// 删除中间节点:前驱的 next 必须越过它
m.Delete(keys[1])
if got := chainKeys(m, idx); len(got) != 2 || got[0] != keys[2] || got[1] != keys[0] {
t.Fatalf("chain after deleting middle = %v, want [%s %s]", got, keys[2], keys[0])
}
if _, ok := m.Get(keys[1]); ok {
t.Fatal("middle key still found after Delete")
}

// 删除头节点:桶头指针必须后移
m.Delete(keys[2])
if got := chainKeys(m, idx); len(got) != 1 || got[0] != keys[0] {
t.Fatalf("chain after deleting head = %v, want [%s]", got, keys[0])
}

// 删除唯一的尾节点:桶必须变空
m.Delete(keys[0])
if got := chainKeys(m, idx); len(got) != 0 {
t.Fatalf("chain after deleting tail = %v, want empty", got)
}
if m.Len() != 0 {
t.Fatalf("Len() = %d, want 0", m.Len())
}
}

图 3 的结论同样可以直接写成断言:桶数翻倍后,旧桶 i 的元素只会出现在新桶 i 或 i + oldLen。构造时要注意阈值——先凑够 6 个同桶 key(6/8 恰好等于 0.75,不触发扩容),再用第 7 个 key 精确触发一次扩容。否则插入过程可能连续扩容两次,断言里写死的桶数就对不上。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
func TestResizeSplitsIntoAtMostTwoBuckets(t *testing.T) {
m := New()
oldLen := len(m.buckets) // 初始 8 个桶
oldIdx := m.index("split-probe")

// 凑 6 个落在 oldIdx 的 key:6/8 == 0.75,恰好不触发扩容
var keys []string
for i := 0; len(keys) < 6; i++ {
k := fmt.Sprintf("split-%d", i)
if m.index(k) == oldIdx {
keys = append(keys, k)
}
}
for _, k := range keys {
m.Set(k, k)
}

// 第 7 个 key 使负载因子超过 0.75,触发一次扩容
m.Set("trigger-resize", 0)
if len(m.buckets) != oldLen*2 {
t.Fatalf("buckets = %d, want %d", len(m.buckets), oldLen*2)
}

for _, k := range keys {
idx := m.index(k)
if idx != oldIdx && idx != oldIdx+oldLen {
t.Fatalf("key %q moved to bucket %d, want %d or %d", k, idx, oldIdx, oldIdx+oldLen)
}
}
}

最后一类是差分验证:随机生成 Set、Delete 序列,每一步都与 Go 原生 map 对比元素数量,结束时全量比对 Get 与 Range 的结果。它不对实现做任何假设,因此扩容、冲突链与删除的交错都能被覆盖到。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
func TestDifferentialAgainstNativeMap(t *testing.T) {
m := New()
want := make(map[string]int)
r := rand.New(rand.NewSource(20261030))

for i := 0; i < 20000; i++ {
key := fmt.Sprintf("k-%d", r.Intn(500))

if r.Intn(10) < 3 { // 30% 删除,70% 写入或更新
m.Delete(key)
delete(want, key)
} else {
v := r.Int()
m.Set(key, v)
want[key] = v
}

if m.Len() != len(want) {
t.Fatalf("step %d: Len() = %d, want %d", i, m.Len(), len(want))
}
}

for k, v := range want {
if got, ok := m.Get(k); !ok || got != v {
t.Fatalf("Get(%q) = (%v, %v), want (%v, true)", k, got, ok, v)
}
}

visited := 0
m.Range(func(key string, value interface{}) bool {
v, ok := want[key]
if !ok {
t.Fatalf("Range yielded unexpected key %q", key)
}
if value != v {
t.Fatalf("Range yielded %q = %v, want %v", key, value, v)
}
visited++
return true
})
if visited != len(want) {
t.Fatalf("Range visited %d entries, want %d", visited, len(want))
}
}

实现放在 hashmap.go,测试放在 hashmap_test.go,两者同属 package hashmap。这里有一个容易踩的坑:不要用 go test hashmap_test.go。显式列出文件时,Go 只编译点名的文件,实现文件不参与,New 会报 undefined。正确的写法是把目录交给它:go test .。上述用例在 Go 1.27 下全部通过,包括 -race。

没有覆盖的部分也很明确:并发安全不是本实现的目标,因此没有并发测试;在 Range 回调里修改表结构属于违反 API 契约,测试无法“验证”一个未定义行为。性能方面可以用 go test -bench . 观察,Set 因为要处理扩容,耗时会明显高于 Get。

与 Go 原生 map 的差距

本文实现的目标是讲清楚基本机制,不是复刻 Go 运行时。比较时还必须注意 Go 版本差异:Go 1.24 起,内置 map 已采用基于 Swiss Tables 的新实现;Go 1.23 及以前的实现采用传统桶与溢出桶结构。不要把旧版实现细节直接描述为当前版本的内部机制。

  • 哈希与安全性:本文使用简单的 FNV-1a,适合教学但不是抗攻击的安全哈希。生产实现需要评估哈希碰撞攻击风险与输入特征。
  • 内存布局:本文每个 entry 都是独立节点,并通过 next 指针连接。当前 Go 原生 map 基于 Swiss Tables,采用开放寻址和分组查找,借助控制字筛选候选 key,以减少不必要的完整比较。
  • 扩容:本文一次性创建新桶数组并迁移全部元素,单次扩容可能带来较高延迟。具体运行时实现会随 Go 版本变化,应该以对应版本的官方资料为准。
  • 冲突处理:本文使用链地址法;当前 Go 原生 map 使用基于 Swiss Tables 的开放寻址方案。它们在空间布局、冲突处理、删除和增长策略上存在不同取舍。

可以阅读 Go 官方文章《Faster Go maps with Swiss Tables》,了解 Go 1.24 的实现变化。

结语:设计决策没有免费的午餐

哈希表的基本思想并不复杂:通过哈希函数把 key 映射到桶,再处理冲突。但工程实现中的每项选择都会带来约束。链地址法让删除简单,却引入指针和额外内存分配;桶数量取 2 的幂让索引计算直接,却要求扩容策略与之配合;全量扩容容易实现,却可能造成单次延迟尖峰;不提供并发安全降低了实现复杂度,却把同步责任交给调用方。

自己实现一次哈希表,真正要学会的不是背下某个阈值或某种结构,而是面对具体场景时,能说清楚:为什么选择它、它解决了什么问题、又把什么代价留给了后续。

这也是理解标准库的一个好方法。标准库里看起来复杂的实现,往往不是为了炫技,而是在性能、内存、延迟、安全性和兼容性之间做长期权衡。

引用与致谢

封面图

  • 图片:加利西亚省科斯塔达莫尔特的灯塔,西班牙——死亡海岸。
  • 作者与版权:Carlos Fernandez / Getty Images,依据图片内嵌的 XMP 元数据。
  • 许可:版权作品。本站仅将原图作为本文封面使用,未取得 Getty Images 授权,也不对其主张任何权利;如需再利用,请向权利人取得许可。

解说图(图 1 ~ 图 3)

  • 生成工具:格物 Gewu —— 一个先把技术内容抽取为可验证解释模型(VEM),再渲染成 SVG 的 Claude Code skill。
  • 说明:三张图均由该工具生成,图中桶数、链长与 key 取值都是示意值,不是某次运行实测的结果。

感谢阅读。

美国国家步道系统,安塞尔·亚当斯的荒野

线上服务在压测时挂了一次。日志里最显眼的是这一行:

1
fatal error: concurrent map writes

它后面其实跟了一段堆栈,但那段堆栈只指向“发现冲突的那个 goroutine”——另一个对手是谁,它并不知道。也没有任何可以 recover 的 panic 信息,程序直接以 exit(2) 结束。更让人困惑的是,这段代码在本地跑了一周都没事,QPS 一上来几秒钟就崩了。

这篇文章不打算罗列“Go map 怎么加锁”的几种方式,而是回答一个更根本的问题:为什么 Go 选择让程序直接死掉,而不是像其他语言那样返回一个错误,或者至少让你 recover 一下?

答案藏在 runtime 的设计哲学里。


一、崩溃现场:一个典型的“看起来没问题”

出问题的结构大致是这样:

1
2
3
4
5
6
7
8
9
var cache = map[string]string{}

func Get(key string) string {
return cache[key]
}

func Set(key, value string) {
cache[key] = value
}

包级 map,HTTP handler 里同时调 Get 和 Set。本地单线程测试没问题,压测时多个 goroutine 同时进来,就炸了。

触发的是两种 fatal error 之一:

  • concurrent map read and map write:一个 goroutine 读,另一个在写;
  • concurrent map writes:两个 goroutine 同时写。

关键在于:它不是 panic,是 throw。


二、runtime 是怎么发现的:一个标志位

这里要先说清版本。Go 1.24 起,内置 map 换成了基于 Swiss table 的实现,代码在 internal/runtime/maps;在此之前是 runtime/map.go 里的 hmap + bucket。两代实现的检测思路一样,但细节不同,网上的分析经常混着讲。

现行实现(Go 1.24+)

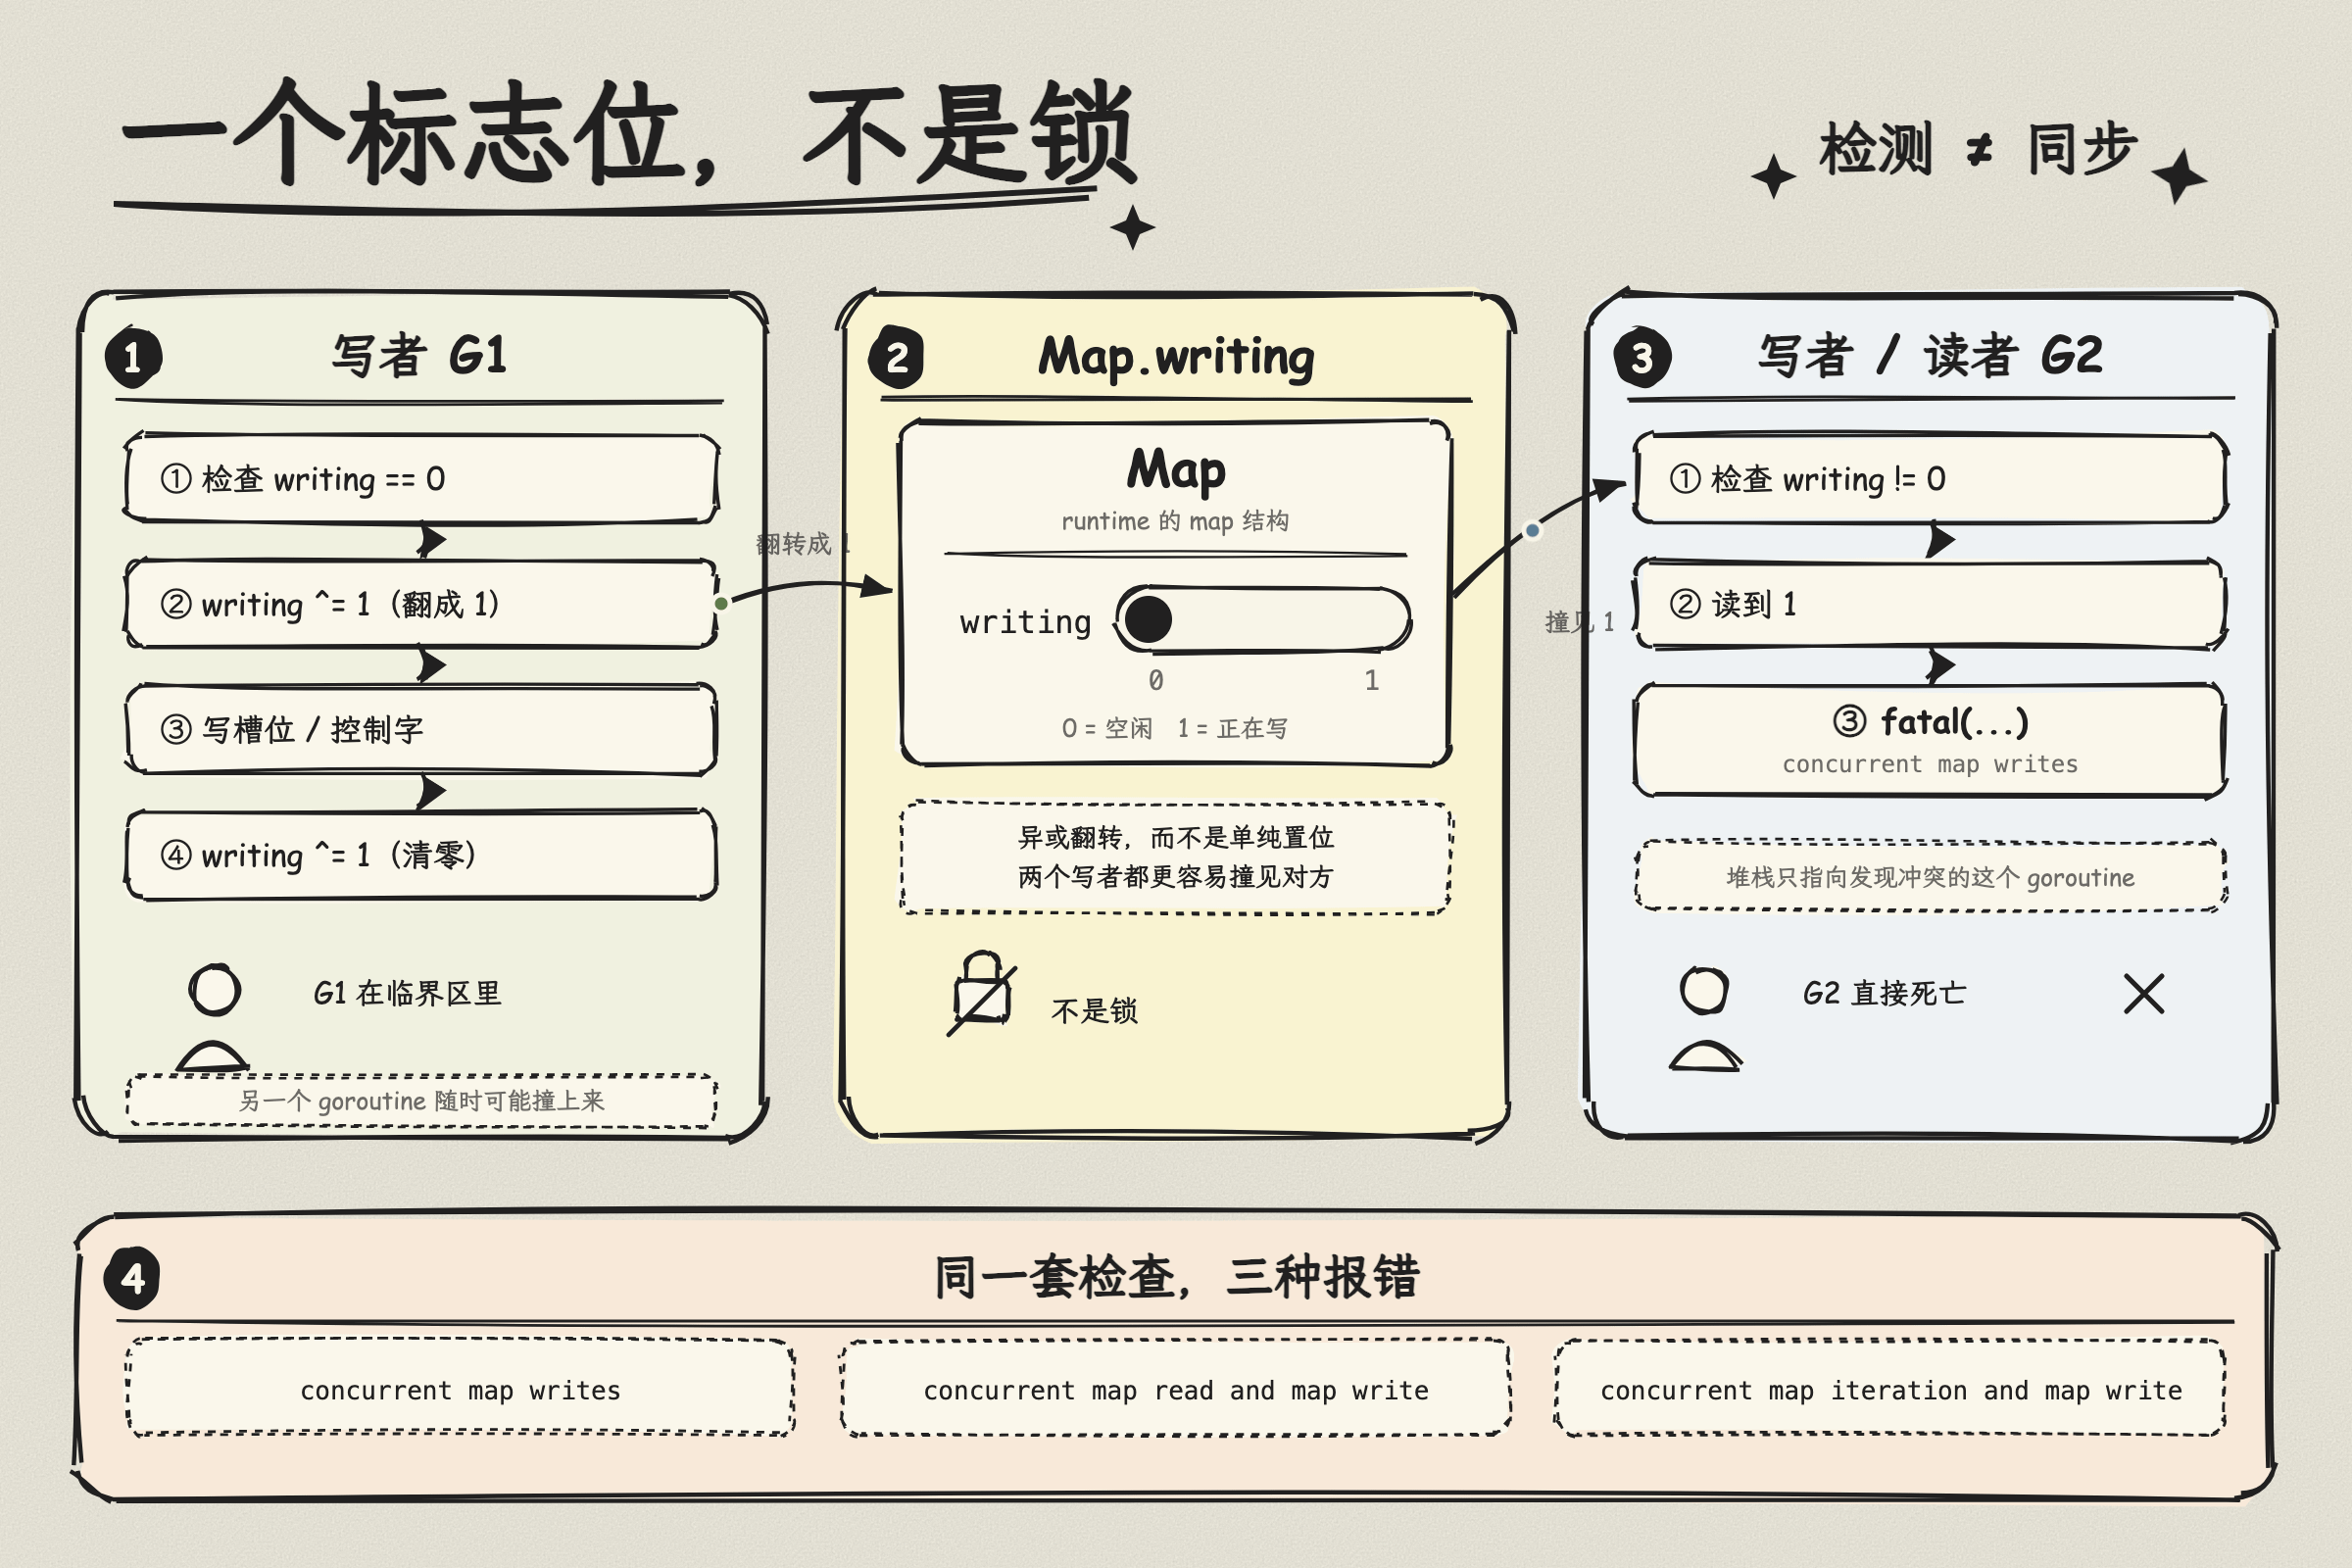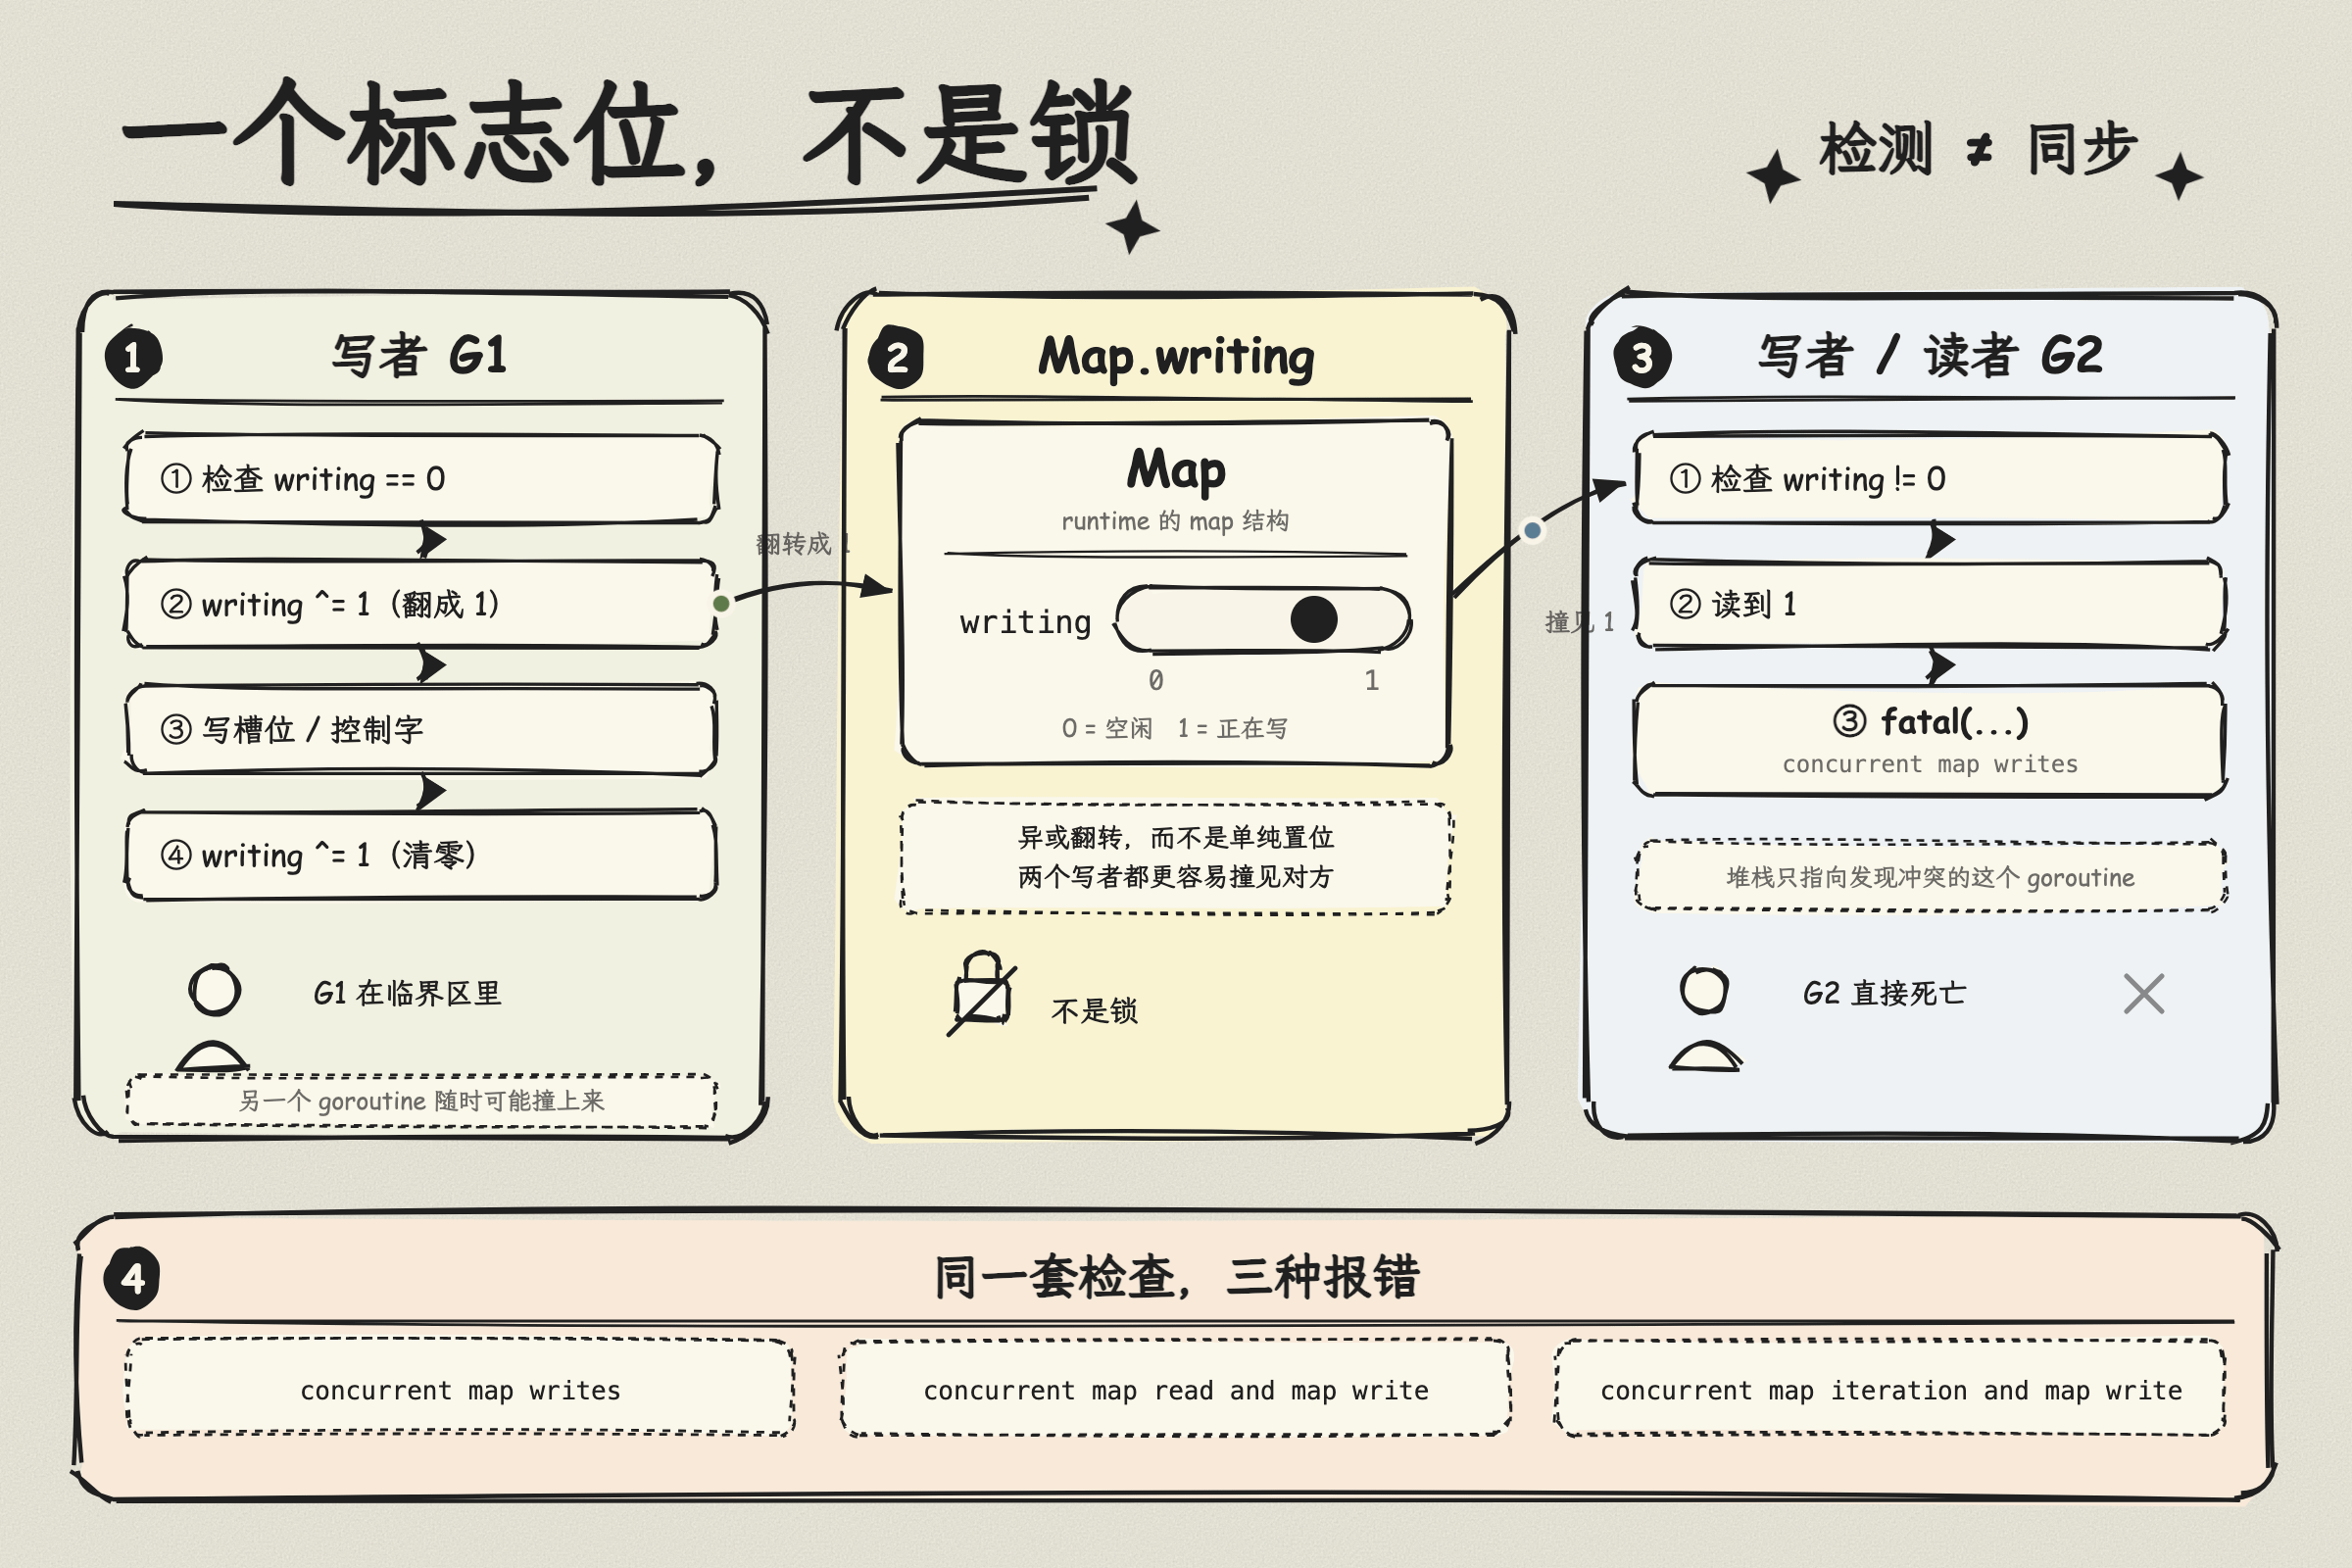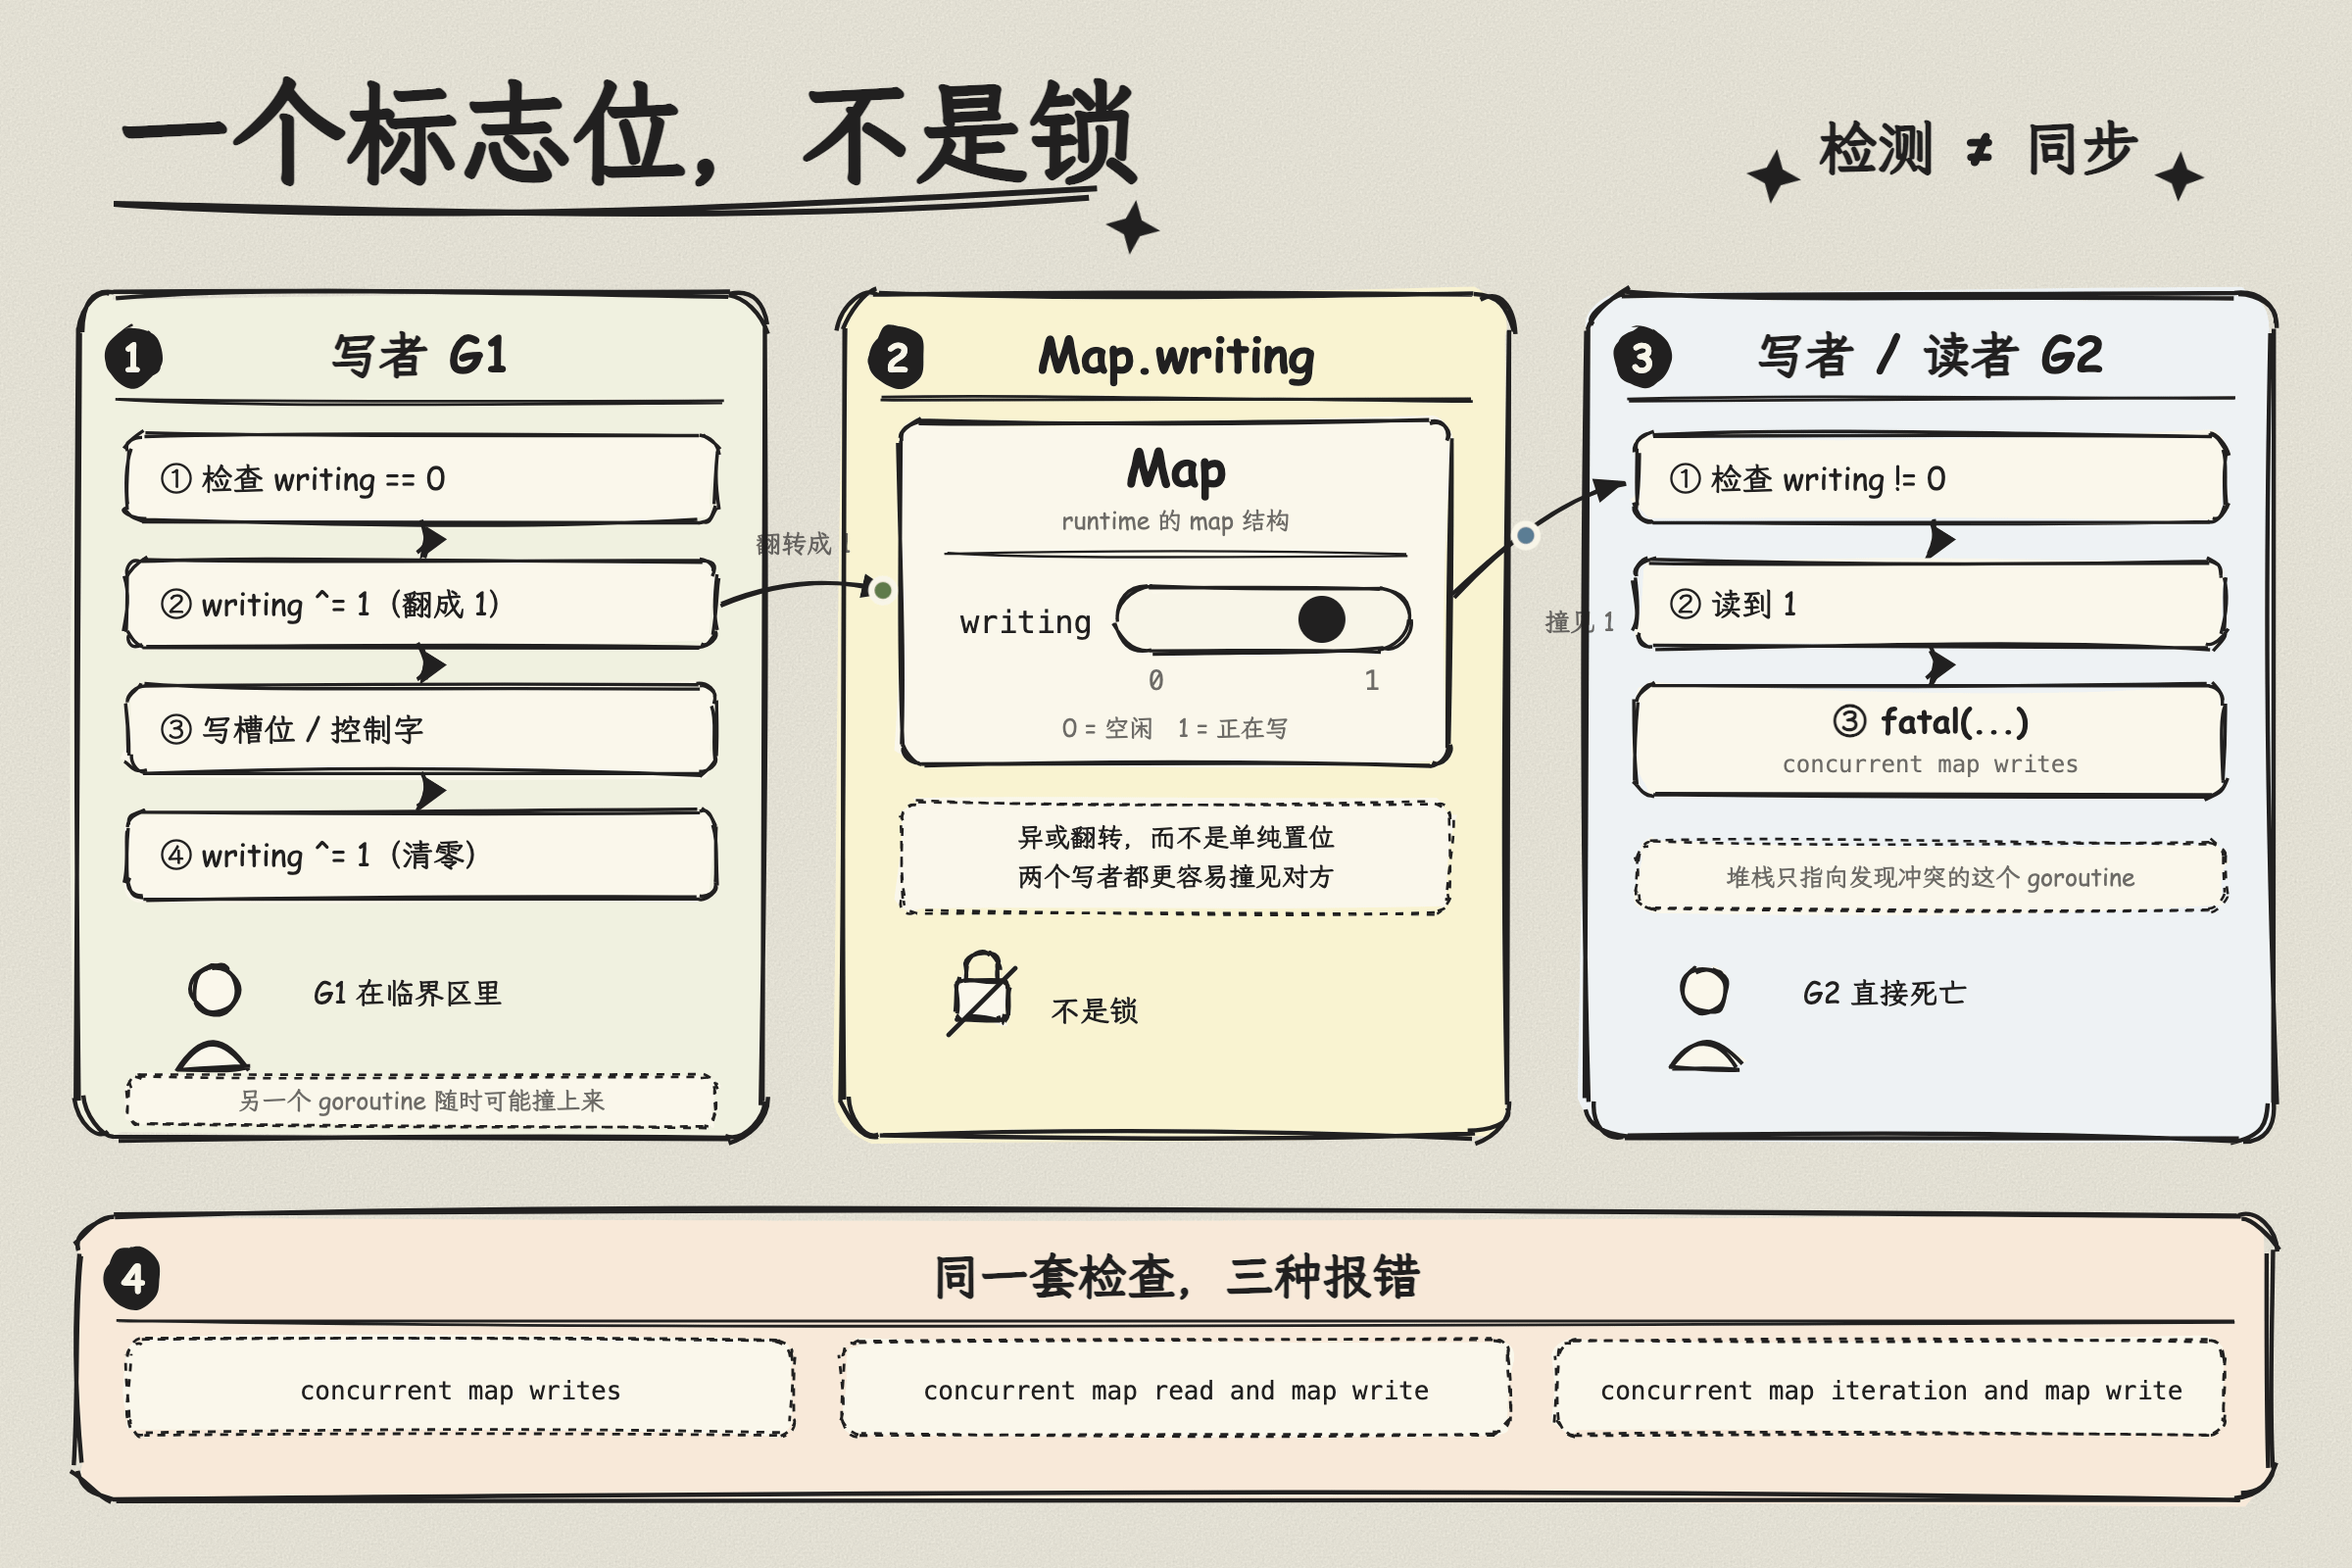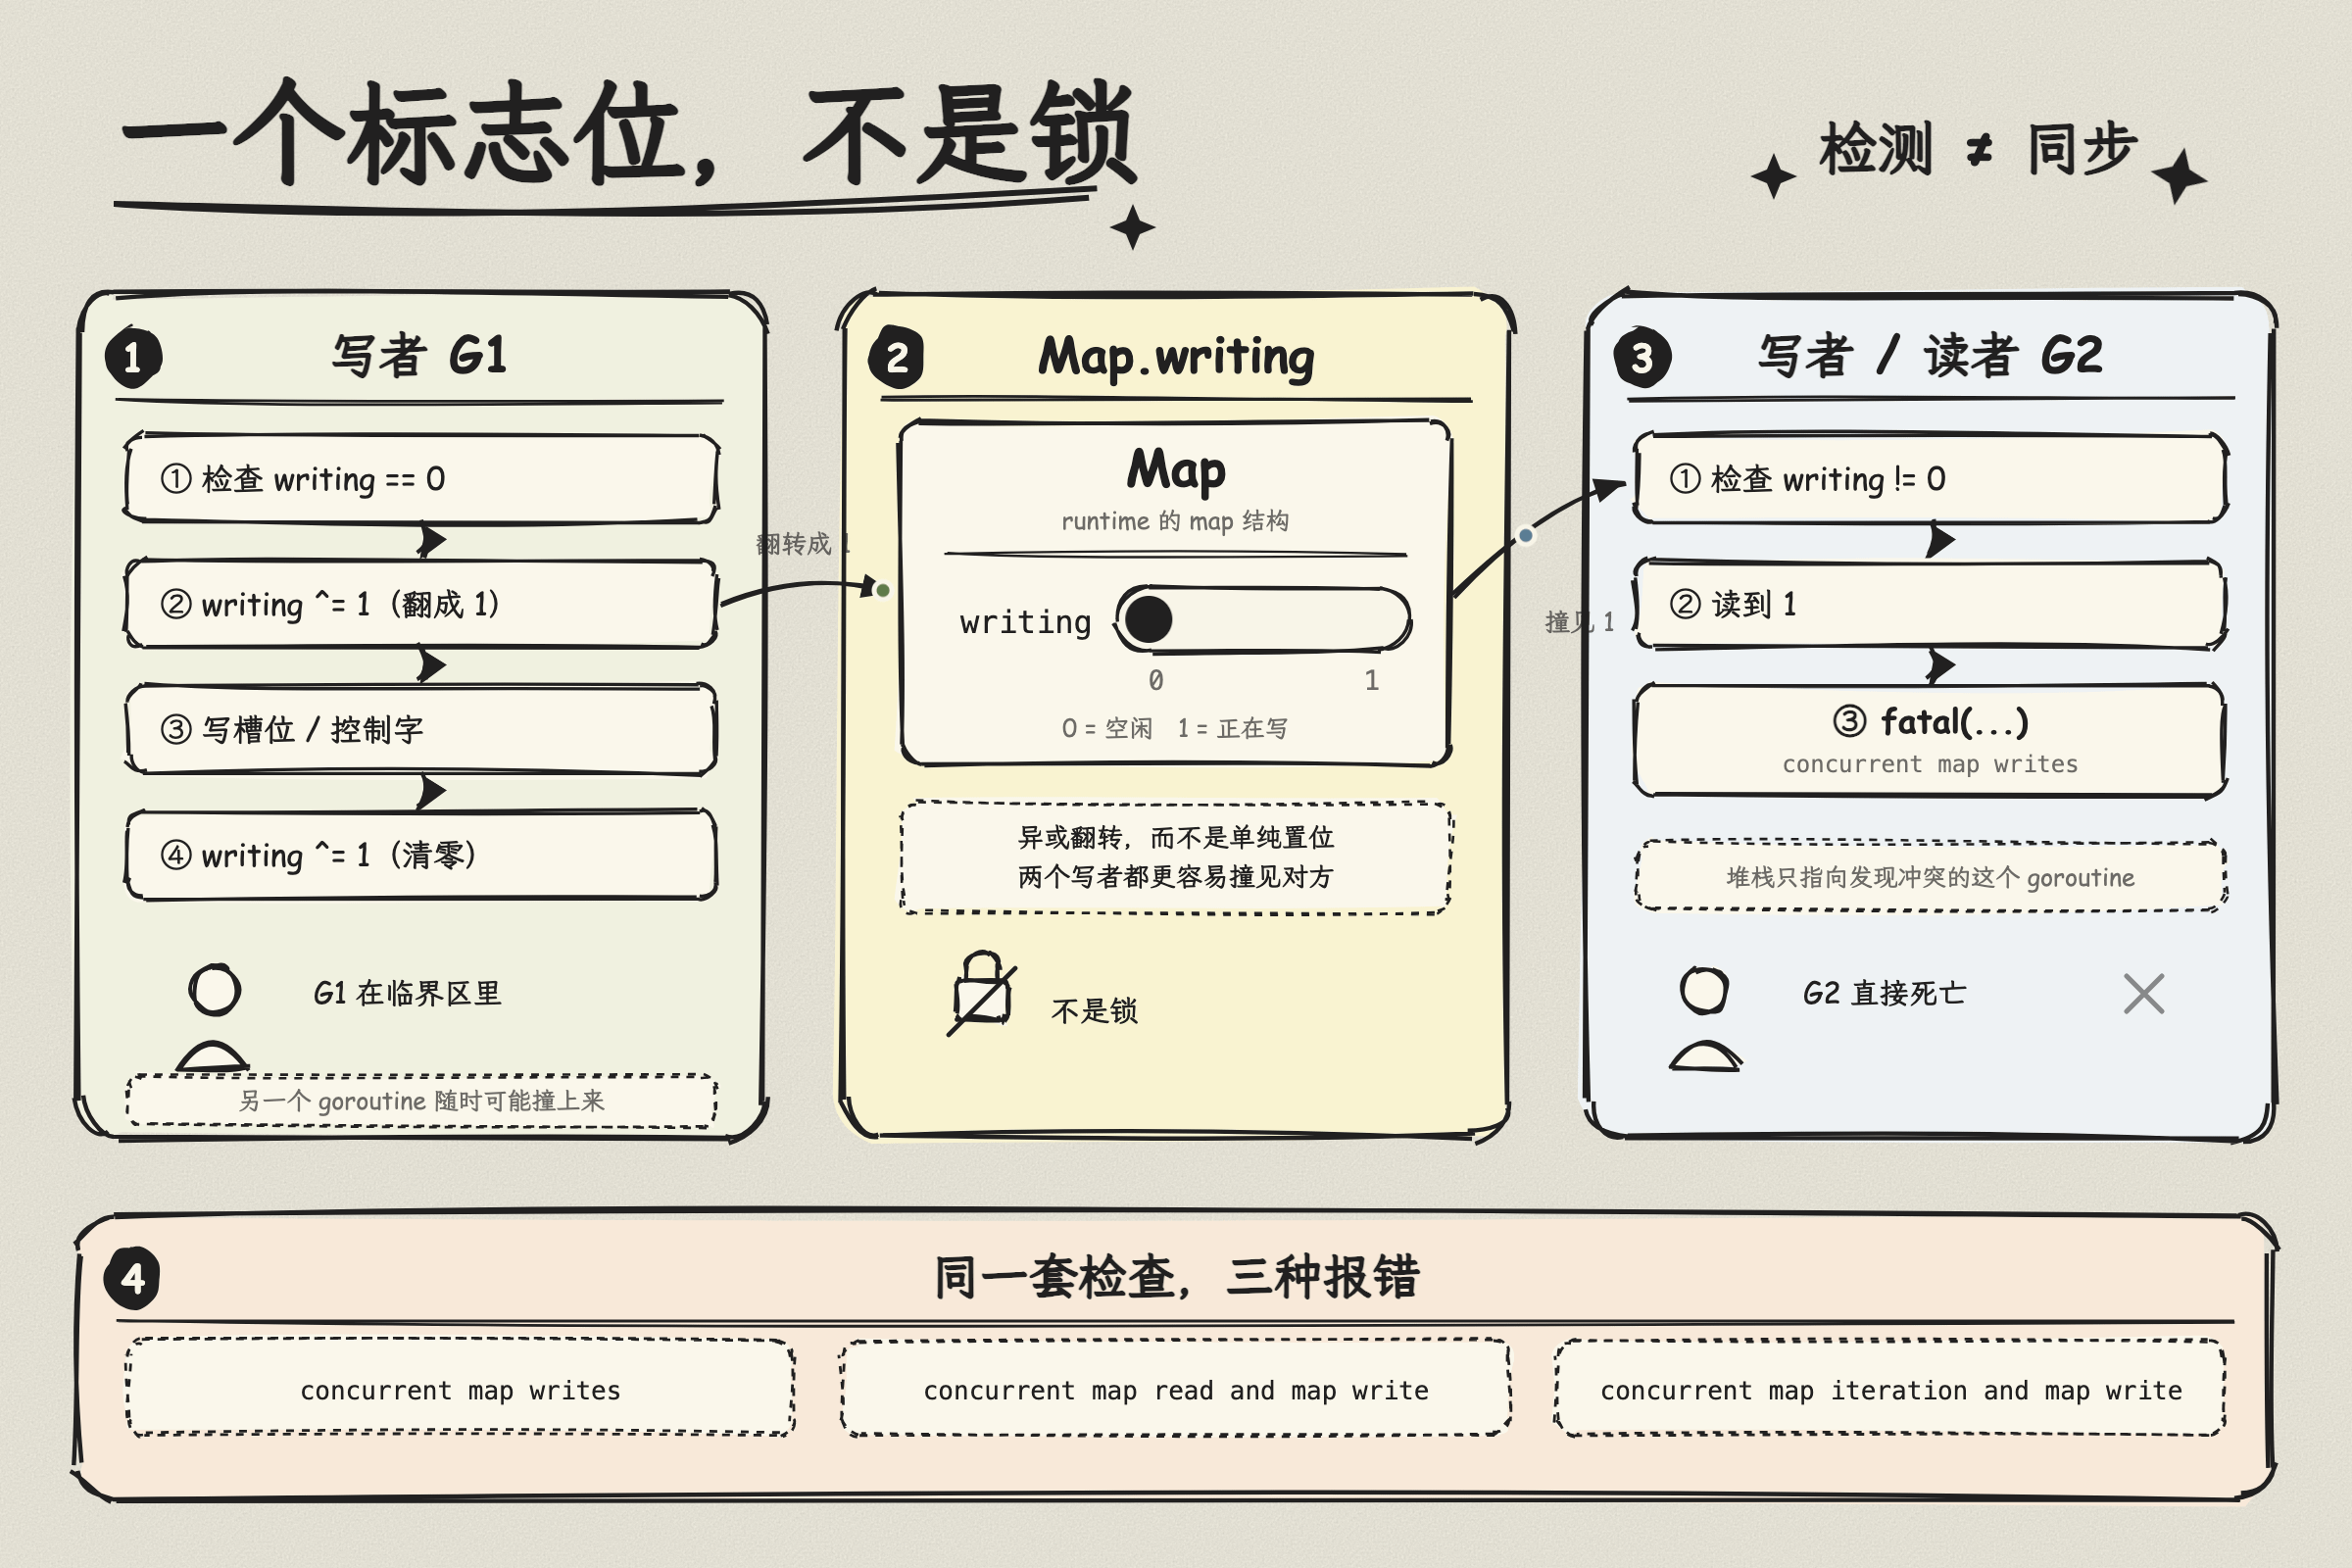
Map 结构体里有一个 writing uint8 字段。写操作不是“上锁”,而是翻转这个标志位,并在进入和退出时各检查一次:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// 写操作(赋值、删除)
if m.writing != 0 {
fatal("concurrent map writes")
}
m.writing ^= 1 // 异或翻转,标记“正在写”
// ... 执行写入 ...
if m.writing == 0 { // 退出前再查一次
fatal("concurrent map writes")
}
m.writing ^= 1

// 读操作
if m.writing != 0 {
fatal("concurrent map read and map write")
}

三个细节值得注意:

  • 用异或而不是置 1/清 0。 源码注释说得很直白:并发写者不止一个时,翻转能提高双方都发现竞争的概率。如果只是置位,后到的写者看到 1 就死了;异或让状态在 0/1 之间来回翻,两个写者都更容易撞见对方留下的痕迹。
  • 进入和退出各查一次。 退出时的 if m.writing == 0 很容易被忽略:如果另一个写者在中途把标志翻回去了,这里也能抓到。
  • 遍历有单独的报错。 mapiterinit 检查的是同一个字段,但报的是 concurrent map iteration and map write。

历史实现(Go 1.23 及更早)

旧实现是 hmap 结构体里的 flags 字段,其中一位叫 hashWriting,值是 4:

  • 写操作开始时 h.flags |= hashWriting,结束时 h.flags &^= hashWriting;
  • 读操作检查 h.flags & hashWriting != 0,发现有人在写就 fatal。

思路完全一样,只是位运算和异或的区别。所以后面讨论的“为什么是 throw”,对两代实现都成立。

runtime 的并发 map 检测:一个标志位,不是一把锁

图 1:runtime 用的是“一个标志位 + 检查”,不是锁。写者进入时翻转标志,另一个写者或读者撞见非零值就触发 fatal;两边的操作并没有被串行化。

注意:这只是一个检测,不是同步。 两个 goroutine 可能刚好错开,也可能刚好撞上。所以表现为“偶发”——本地不崩,压测崩;低流量不崩,高流量崩。

还有一个容易踩的坑:对非空 map,delete 即使 key 不存在,也会走写路径、设置写标志。遍历时如果另一个 goroutine 在删任何 key,遍历都可能触发 fatal。


三、为什么是 throw,而不是 panic

这是整个设计中最关键的问题。

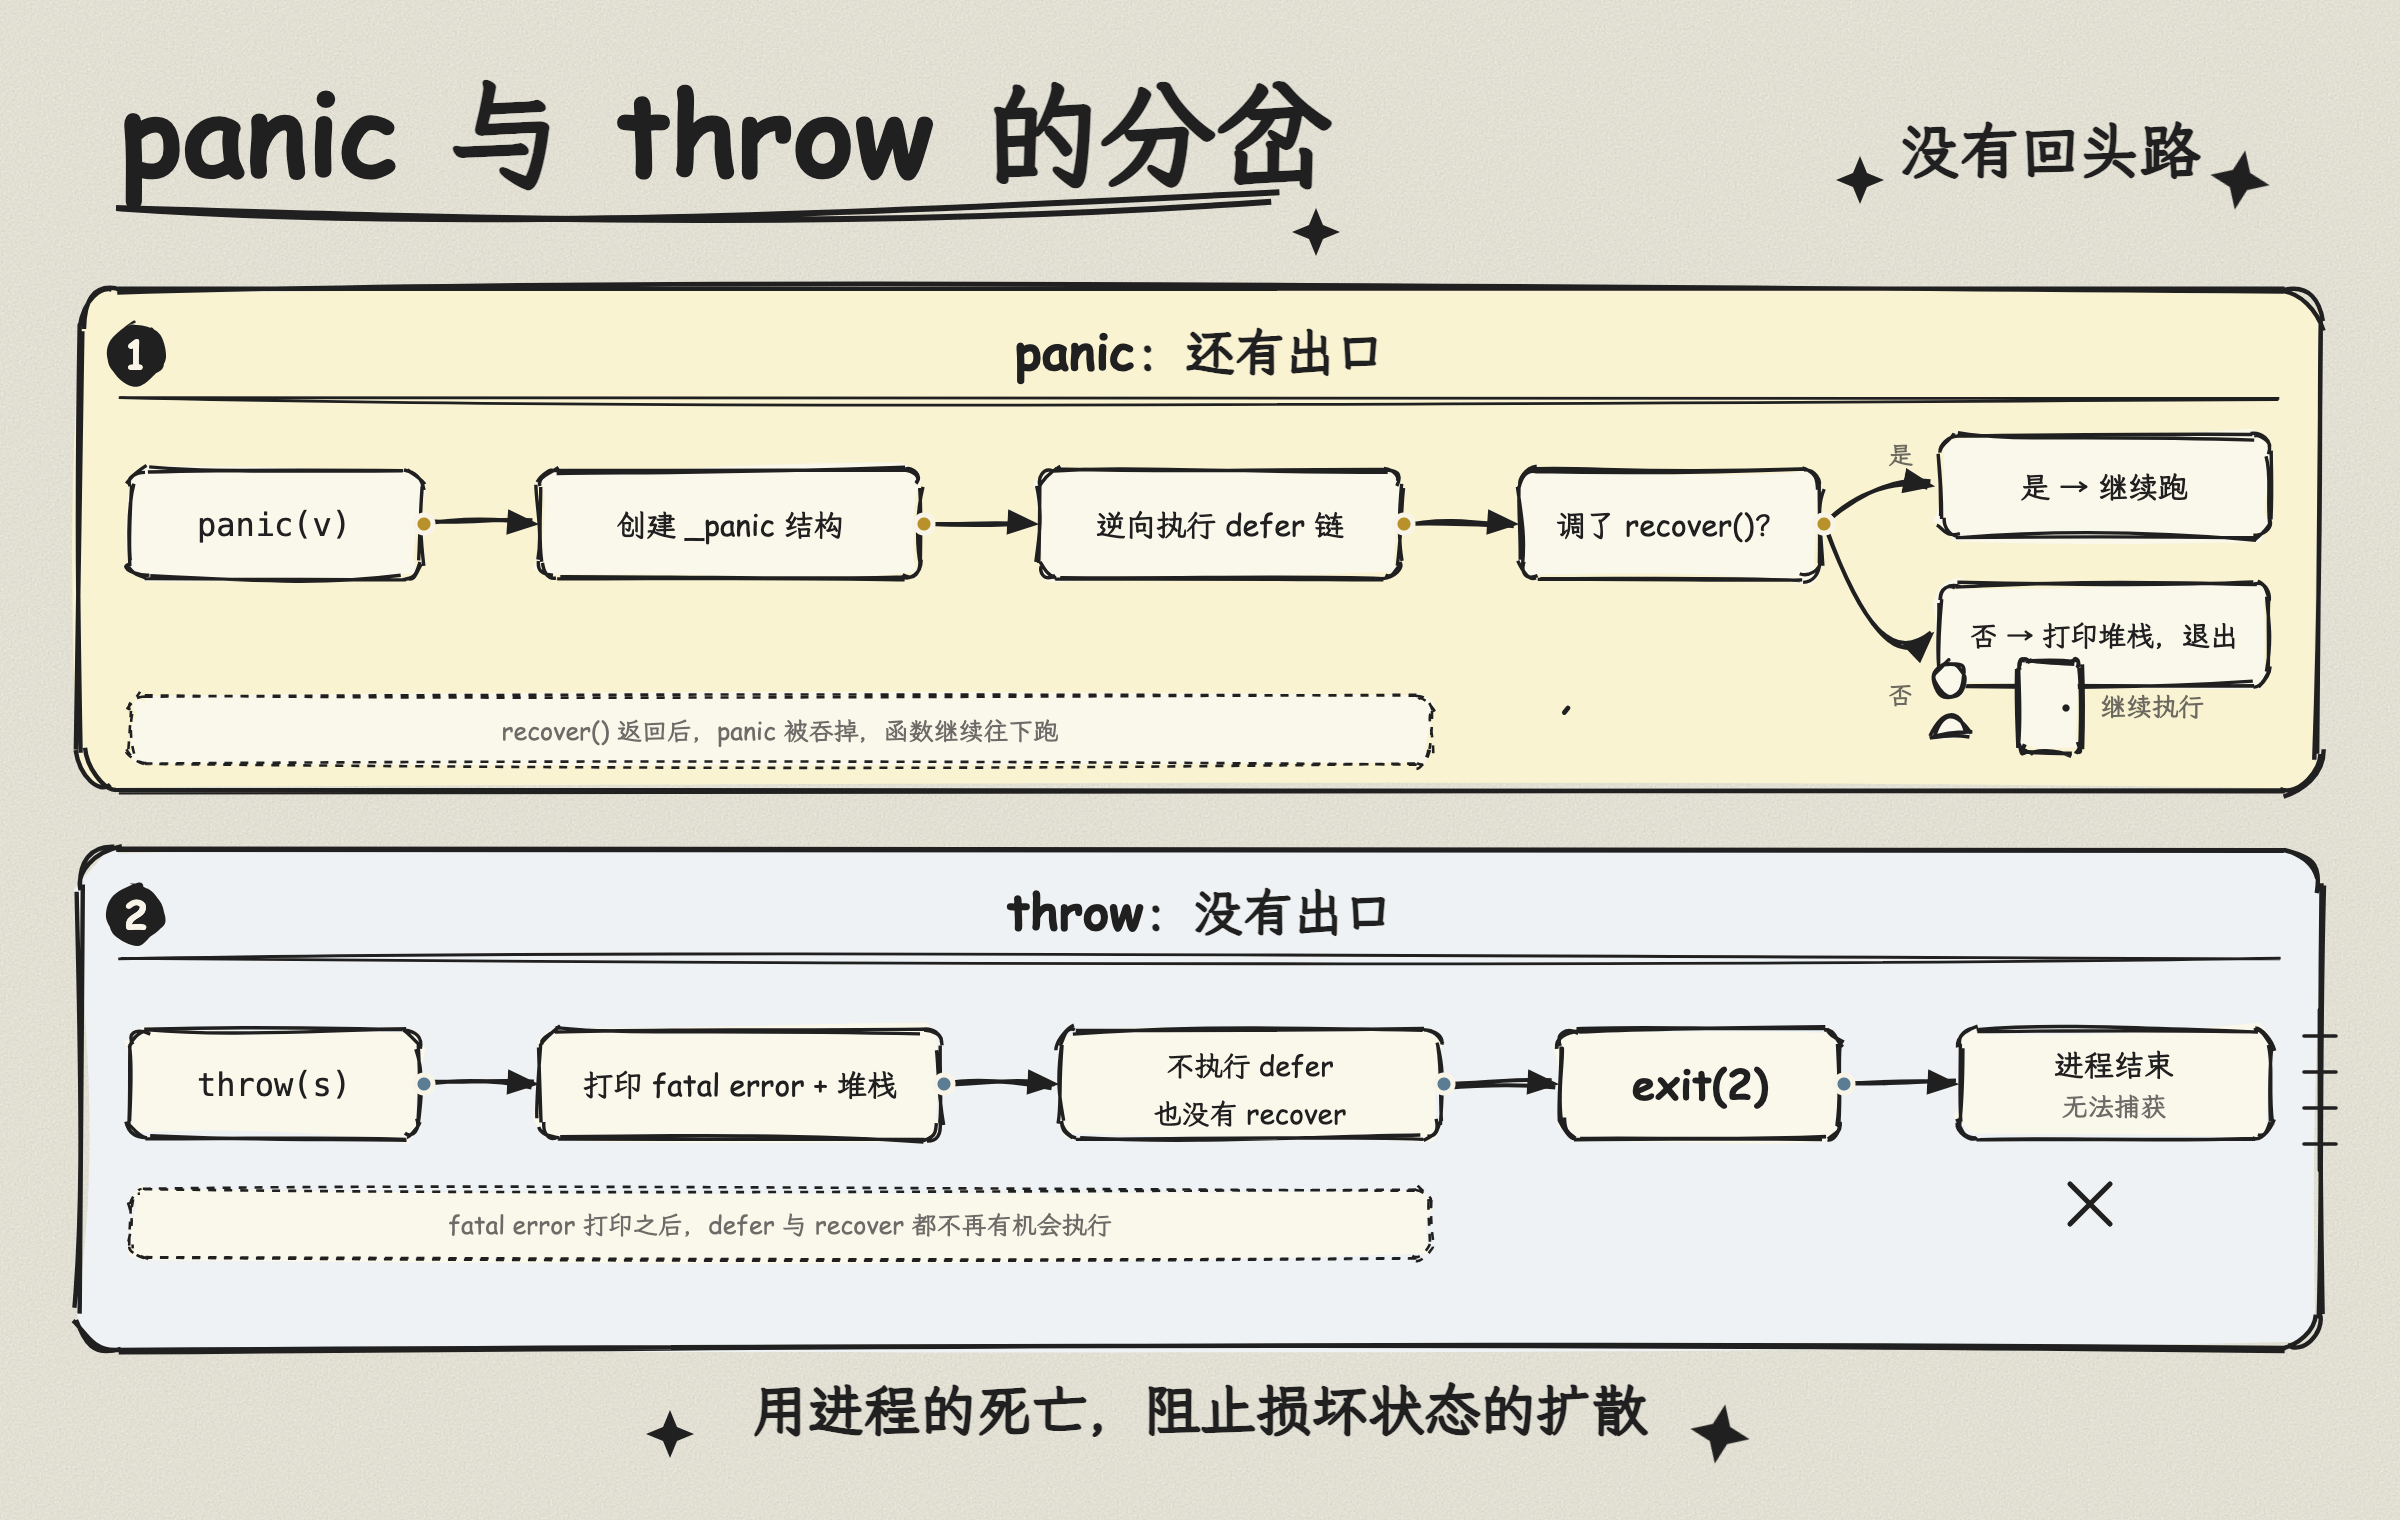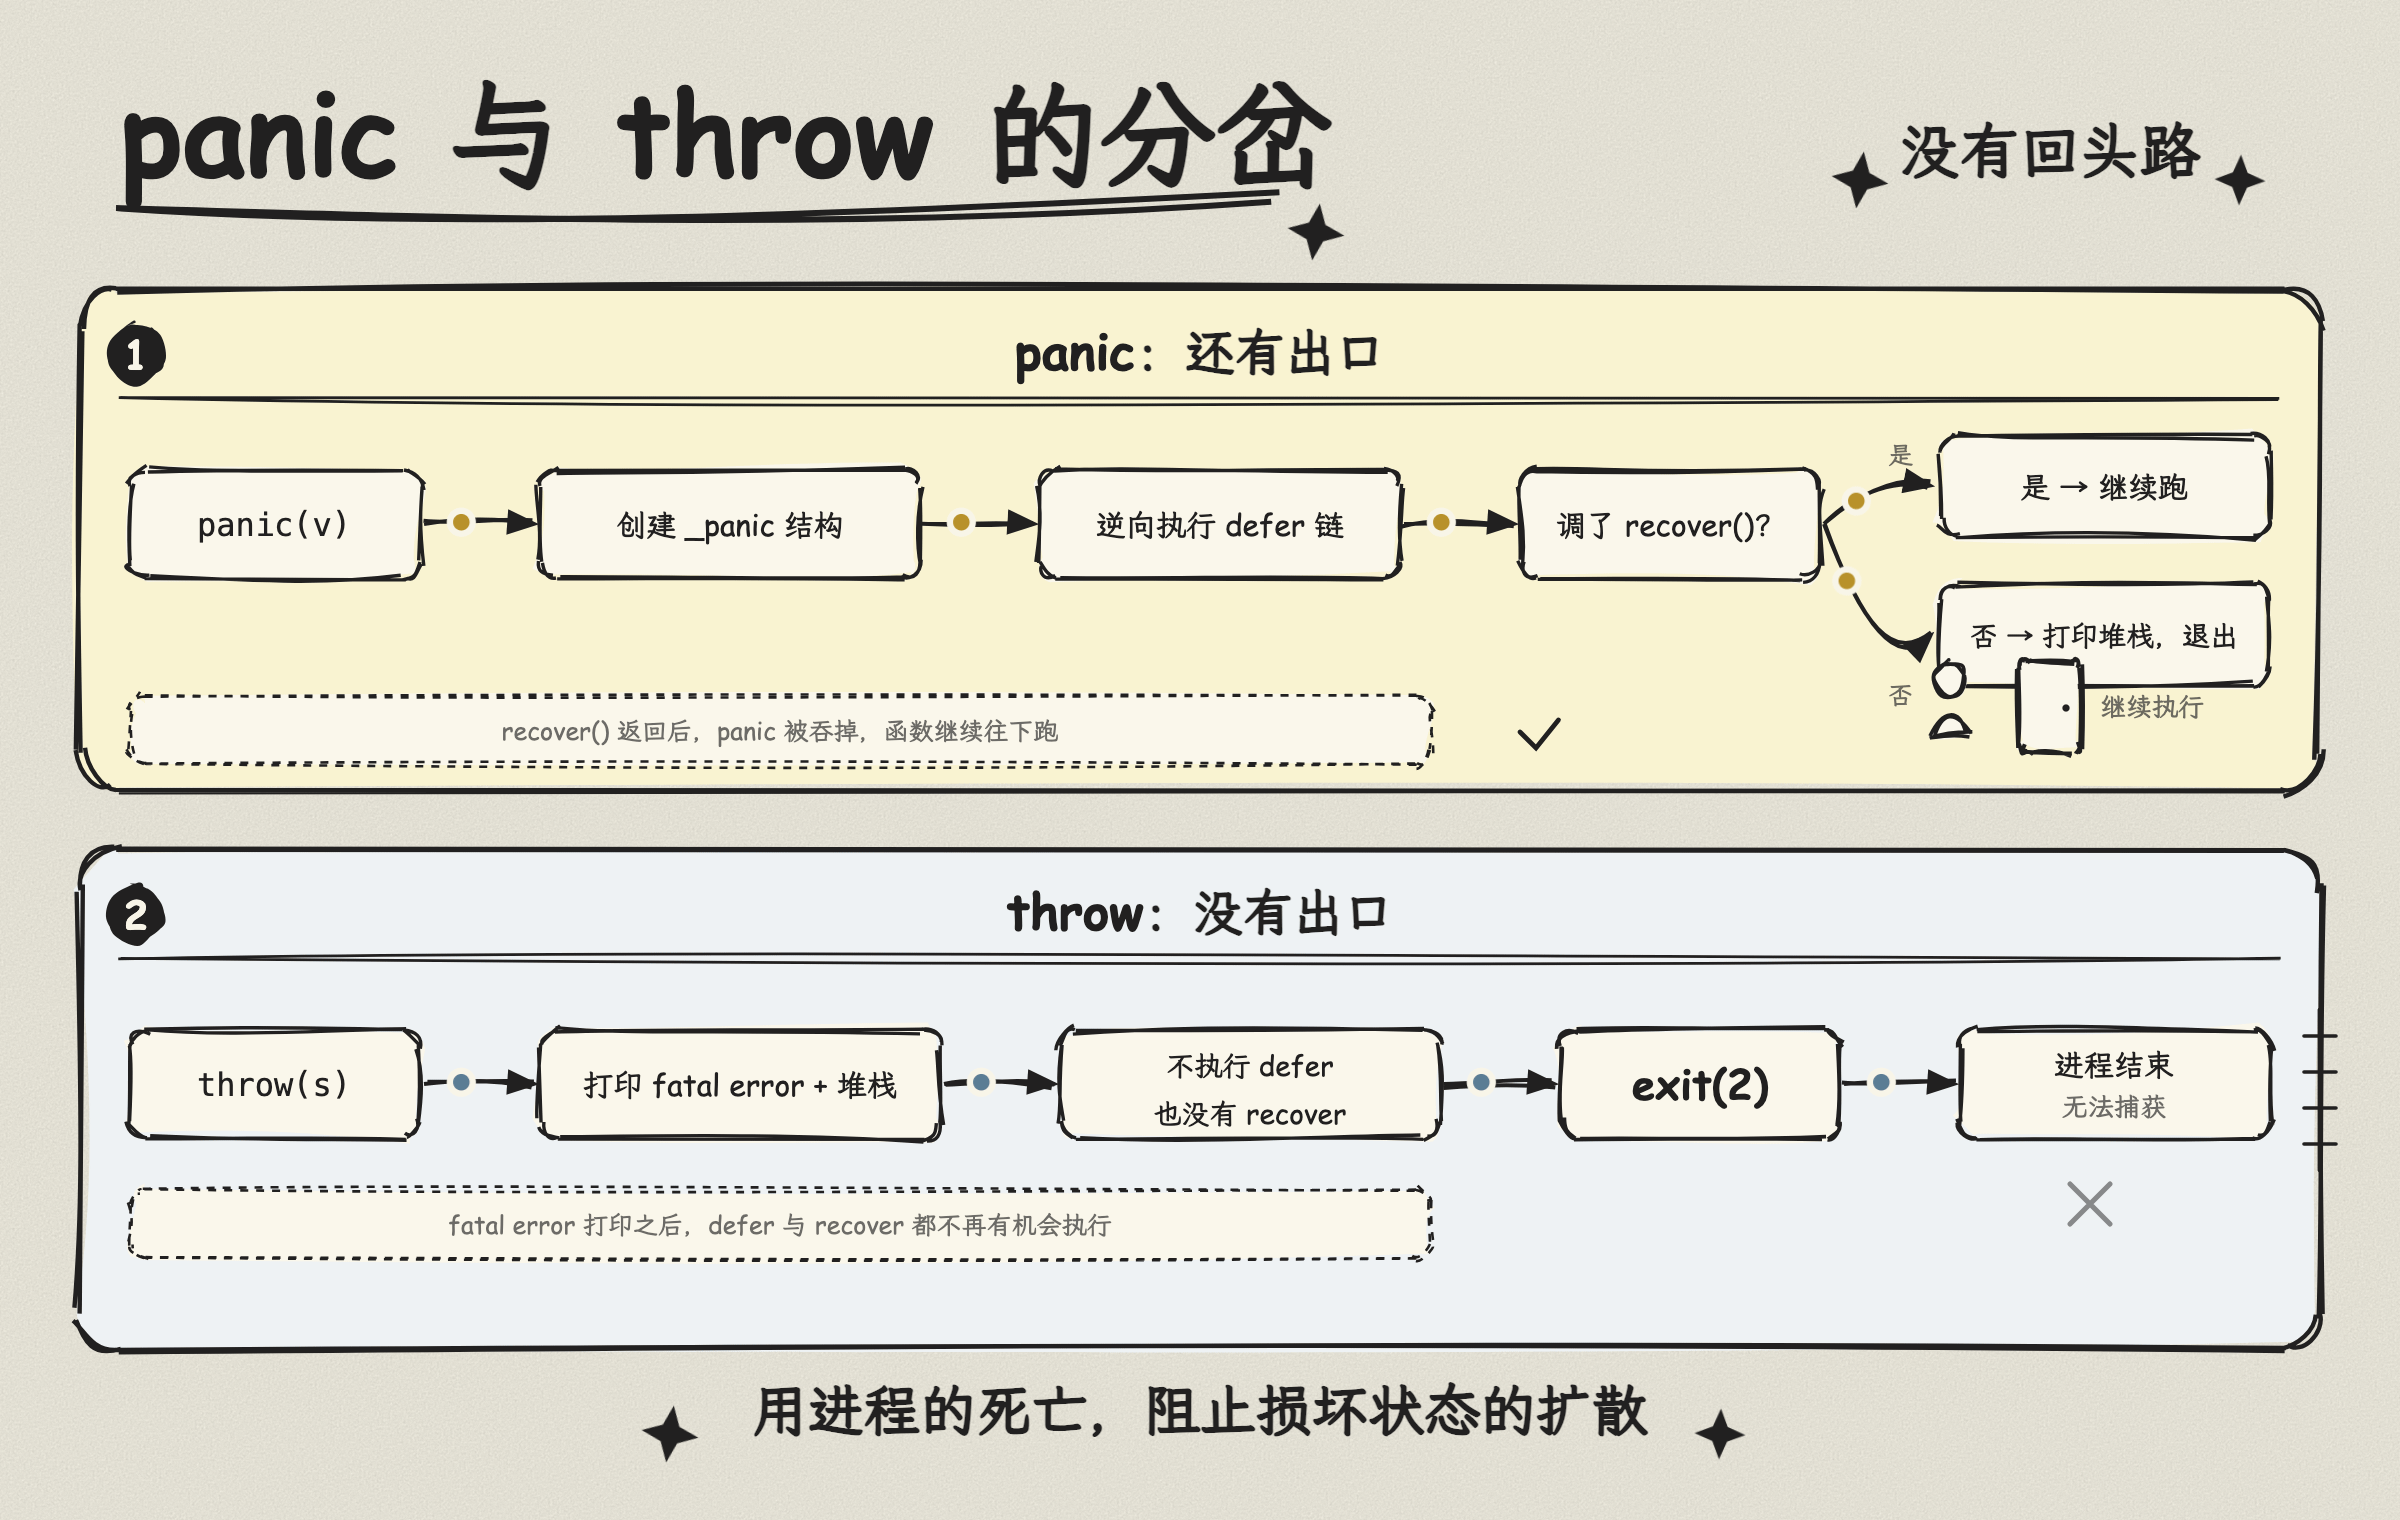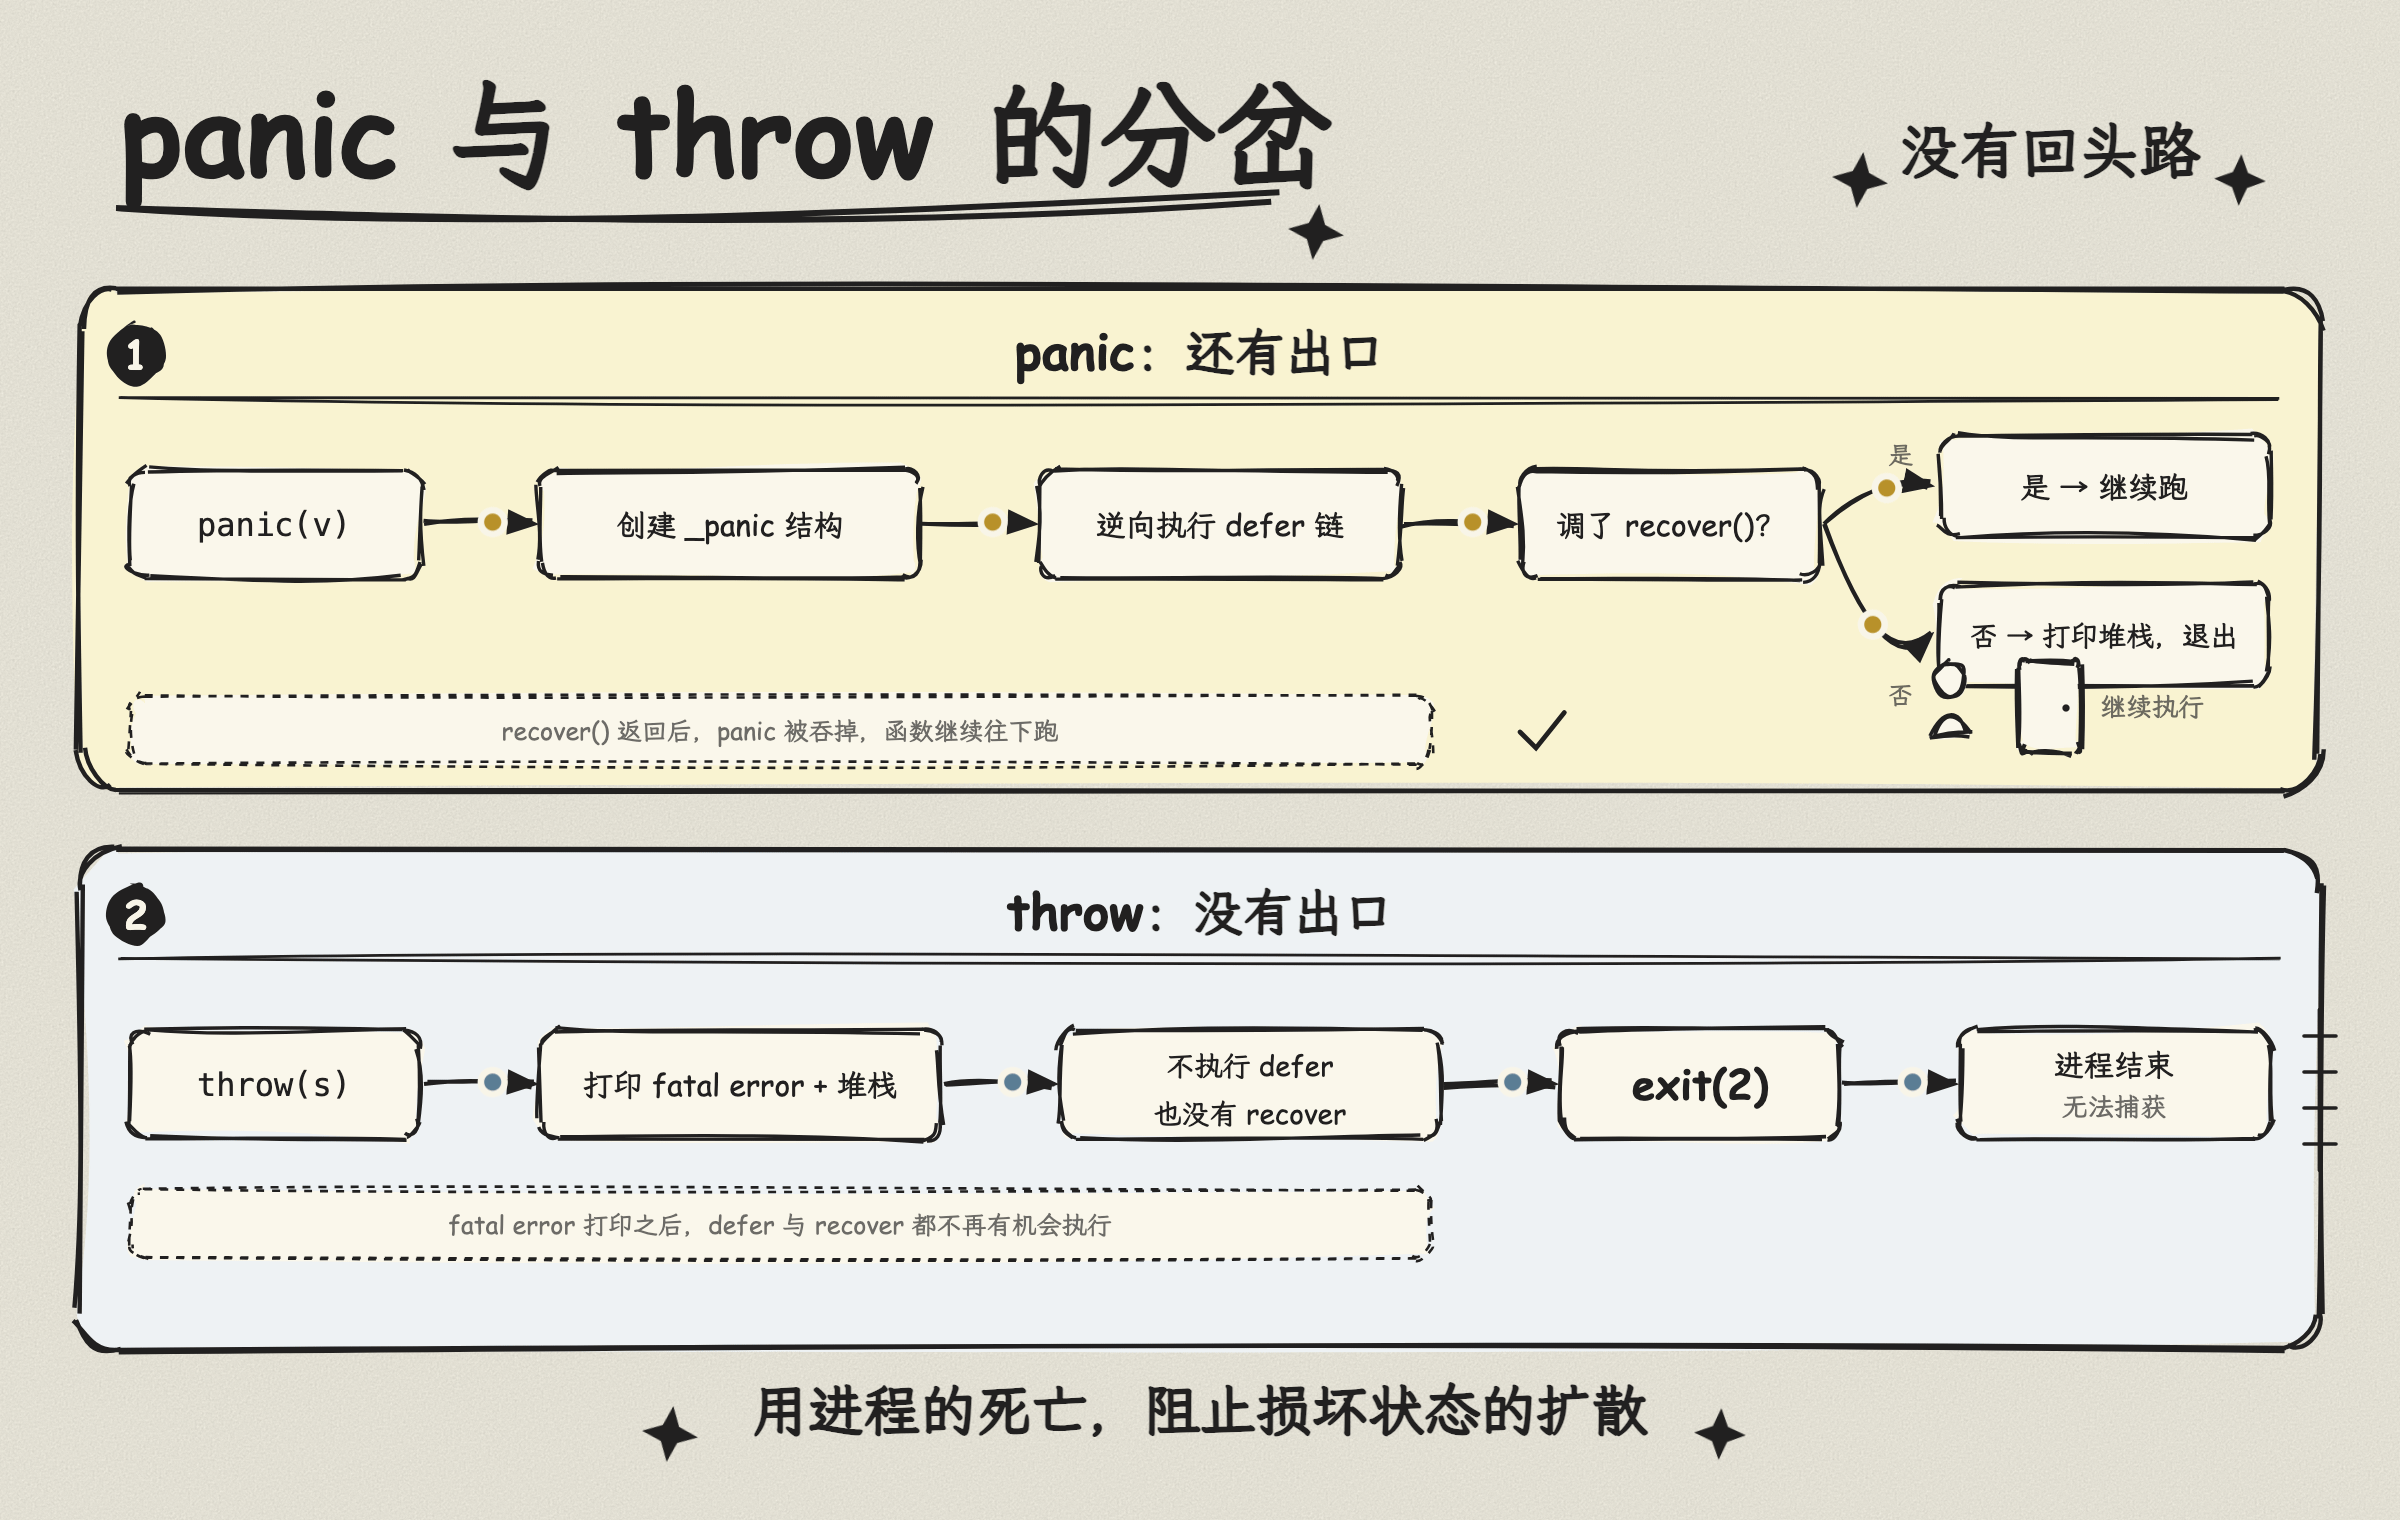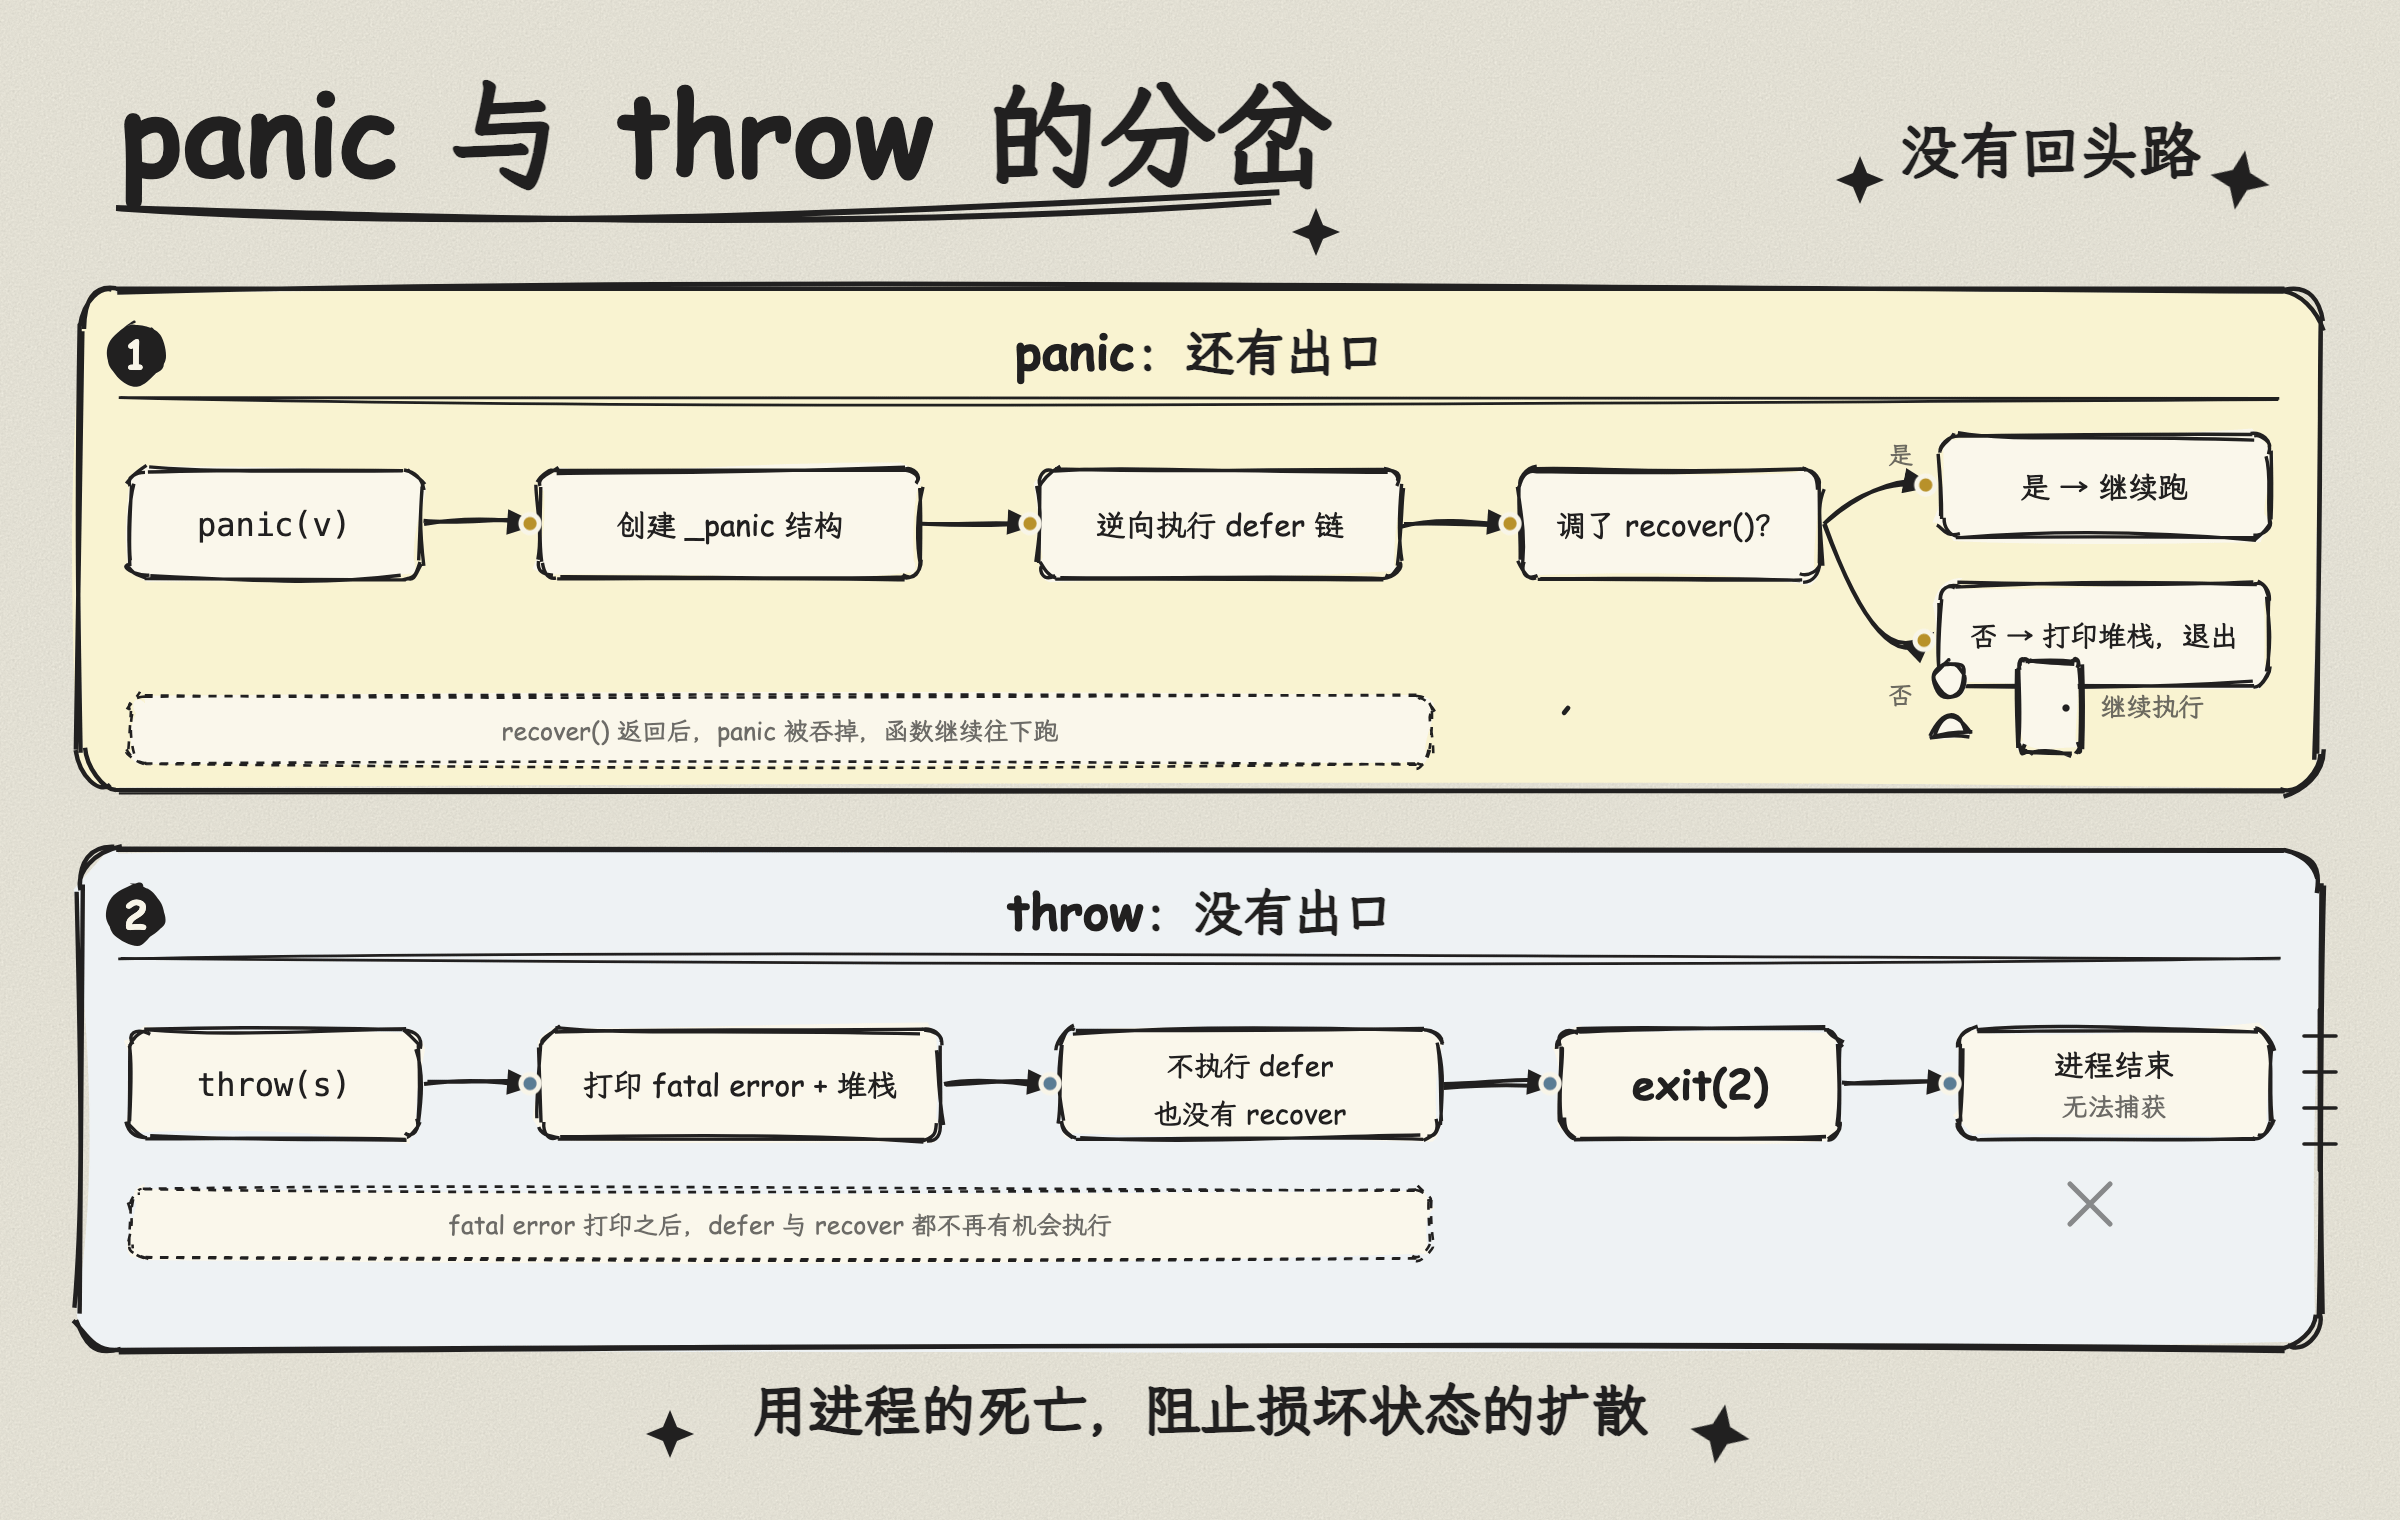
普通的 panic 会创建一个 _panic 结构体,挂到当前 goroutine 上,然后逆向遍历调用栈,执行 defer。如果某个 defer 里调了 recover(),程序就能继续跑。

throw 完全绕过这套机制。它把 fatal error 和当前 goroutine 的堆栈打印到标准错误,然后 exit(2)。没有 defer,没有 recover,没有“恢复”这个选项。

它选择这么做的理由很直接:当 map 的并发冲突被检测到时,内部状态可能已经损坏了。

想象一下:一个 goroutine 正在扩容、把旧表里的槽位搬到新表,另一个 goroutine 同时在读旧表的指针。runtime 发现的时候,控制字和槽位可能已经被改得面目全非——而检测本身只是一个标志位,它只知道“有人撞车了”,并不知道撞坏了多少东西。如果允许你 recover,程序继续跑,后续可能出现更诡异的行为——读到错误的数据、写入丢失、甚至内存越界。

直接死掉,是比“带着损坏的状态继续运行”更负责任的选择。

对比一下 Java 的 ConcurrentModificationException:它允许你捕获,然后继续用那个已经被并发修改过的集合。很多时候你的程序不会立刻崩,但数据对不对,就不好说了。

Go 选择了另一条路:在检测到确定性错误的那一刻,终止进程。 用一次响亮的崩溃,换掉后续所有不可预测的 bug。

panic 与 throw 的分岔

图 2:panic 与 throw 的分岔——panic 会走 defer 链,路上还有 recover 这个出口;throw 直接打印堆栈并 exit(2),没有回头路。


四、sync.Map 不是万能解药

知道原因之后,修复方式看起来很简单:加锁,或者换成 sync.Map。

但 sync.Map 的适用场景很窄,而且它的内部实现这些年也变过。

Go 1.24 起,sync.Map 换成了并发哈希 trie(internal/sync.HashTrieMap):读操作沿树做原子加载,通常无锁;写操作只在命中的中间节点上加锁并替换节点。官方发布说明强调的改进是——修改不相交的 key 集合时,大 map 上的争用明显变少,而且不再需要预热(老实现要先攒出 dirty map,才能进入低争用状态)。

Go 1.23 及更早,它是 read + dirty 两层结构:读大多走 read 这层无锁快照,写则先在 dirty 里累积,攒够次数再提升为新的 read。

两代实现的共同结论没变:它的优势都在读多写少、key 集合相对稳定的场景。写非常频繁时,sync.Map 的写路径(加锁、替换节点、分配)未必比一把 sync.RWMutex 便宜。而且无论哪一代,Range 都不保证一致性快照——遍历期间看到的可能是部分更新后的状态。

所以实际选型通常是:

场景 推荐
读多写少,key 稳定 sync.Map
读写均衡,或需要强一致遍历 sync.RWMutex 保护的普通 map
高并发,锁竞争严重 分片锁(按 key hash 分到 N 个 map,各一把锁)

分片锁的思路和 Redis 的渐进式 rehash 有相似之处:把一个大问题拆成 N 个小问题,让冲突概率降下来。


五、重新理解 runtime 的“不宽容”

这次崩溃之后,我对 Go runtime 的看法变了一点。

以前觉得 fatal error 太粗暴,为什么不能给个错误码,或者至少让我记录一下现场。后来想明白了:map 的并发冲突不是“可以优雅处理”的错误,它是一个已经发生的数据损坏事件。

runtime 在 writing(老版本是 hashWriting)标志上做的检测,本质是一种尽力而为的哨兵。它不保证一定能发现(两个写操作可能刚好错开标志位检查),但一旦发现,说明冲突已经真实发生了。这时候程序内部的状态是否还能安全使用,没有人能保证。

所以它选择 throw。用进程的死亡,阻止损坏状态的扩散。

这其实和 Redis 渐进式 rehash 的设计哲学形成了有趣的对照:Redis 用复杂度换可用性,因为它是单线程的,不能让主线程卡住;Go 用进程死亡换正确性,因为 map 的状态一旦损坏,继续运行比崩溃更危险。

两种选择,面对的是不同层面的“正确性”。


如果你也在线上遇到过这个崩溃,第一件事不是急着加锁,而是用 go test -race 或 go run -race 在测试环境复现一次。-race 能告诉你哪个 goroutine 在写、哪个在读、以及它们各自的调用栈。这比线上盲猜高效得多。

至于那个包级 map——修法很简单,难的是意识到:Go 的 map 从来没有承诺过并发安全,而 runtime 用最不宽容的方式,让这个承诺变得无法忽视。


引用与致谢

封面图

  • 图片:美国国家步道系统,安塞尔·亚当斯的荒野,来源 bing。

动图(图 1 ~ 图 2)

  • 生成工具:Animated Sketch Diagram —— 一个把技术概念画成「黑墨手绘涂鸦 + 米色纸面」风格动画图的 Claude Code 插件。
  • 项目地址:https://github.com/OLDyade/animated-sketch-diagram
  • 作者:OLDyade
  • 许可:见项目仓库中的 LICENSE 文件。
  • 说明:两张动图均由该工具把正文对应段落转成 SVG + CSS 动画后导出为循环 GIF,图中的结构为示意,不是 runtime 内存布局的精确复刻。

事实核对

  • 旧实现(Go 1.23 及更早):src/runtime/map.go 中的 hashWriting = 4 与 h.flags 检查,见 go1.23.0 源码。
  • 现行实现(Go 1.24+):src/internal/runtime/maps/map.go 中的 writing 字段与异或翻转,本文按作者本机 Go 1.27.1 的源码核对。
  • sync.Map 的实现变更:Go 1.24 Release Notes(sync.Map 与内置 map 都在这个版本换了实现)。
  • 文中崩溃输出(fatal error + 堆栈 + 程序 exit(2))来自作者本机 Go 1.27.1 的实际复现;注意用 go run 运行时,外层工具自身会返回 1,日志里的 exit status 2 才是程序本身的退出码。

感谢阅读。

如果你用过 Redis,大概率知道它“快”。但“快”从来不是偶然的。Redis 字典的渐进式 rehash,就是一个典型的例子:它为了不阻塞,主动选择了一种“看起来更慢”的搬迁方式。

这个选择的本质,是在回答一个问题:当一次维护操作的耗时随数据量线性增长时,你愿意把它摊开,还是让它一次性砸下来?

一次性 rehash 的账很好算:1 亿个键值对、单个迁移约 100 纳秒,乘起来就是 10 秒。对一个标榜毫秒级延迟的服务来说,这 10 秒等于服务中断。渐进式 rehash 的答案是——不追求“搬得快”,只追求“永远不停”。它把搬迁拆成一个个桶,塞进每一次普通的增删改查里,让开销跟着请求量自然摊薄。

代价也很实在:迁移期间内存占用翻倍、每次操作要查两张表、所有字典操作都要多一条“是否在 rehash 中”的分支。

下面按问题拆开讲:一次性 rehash 到底会阻塞多久?两个哈希表怎么协作?迁移过程中增删改查各走哪条路?为什么是“每次操作顺带搬”而不是“分批定时搬”?以及——这个设计最终牺牲了什么、换来了什么。


一、字典的基本结构:两个哈希表

Redis 的字典 dict 内部有两个哈希表:ht[0] 和 ht[1]。

正常情况下,数据都在 ht[0] 里,ht[1] 是空的。只有当需要扩容或缩容时,ht[1] 才会被分配空间,然后数据从 ht[0] 逐渐迁移到 ht[1]。

为什么要两个表?

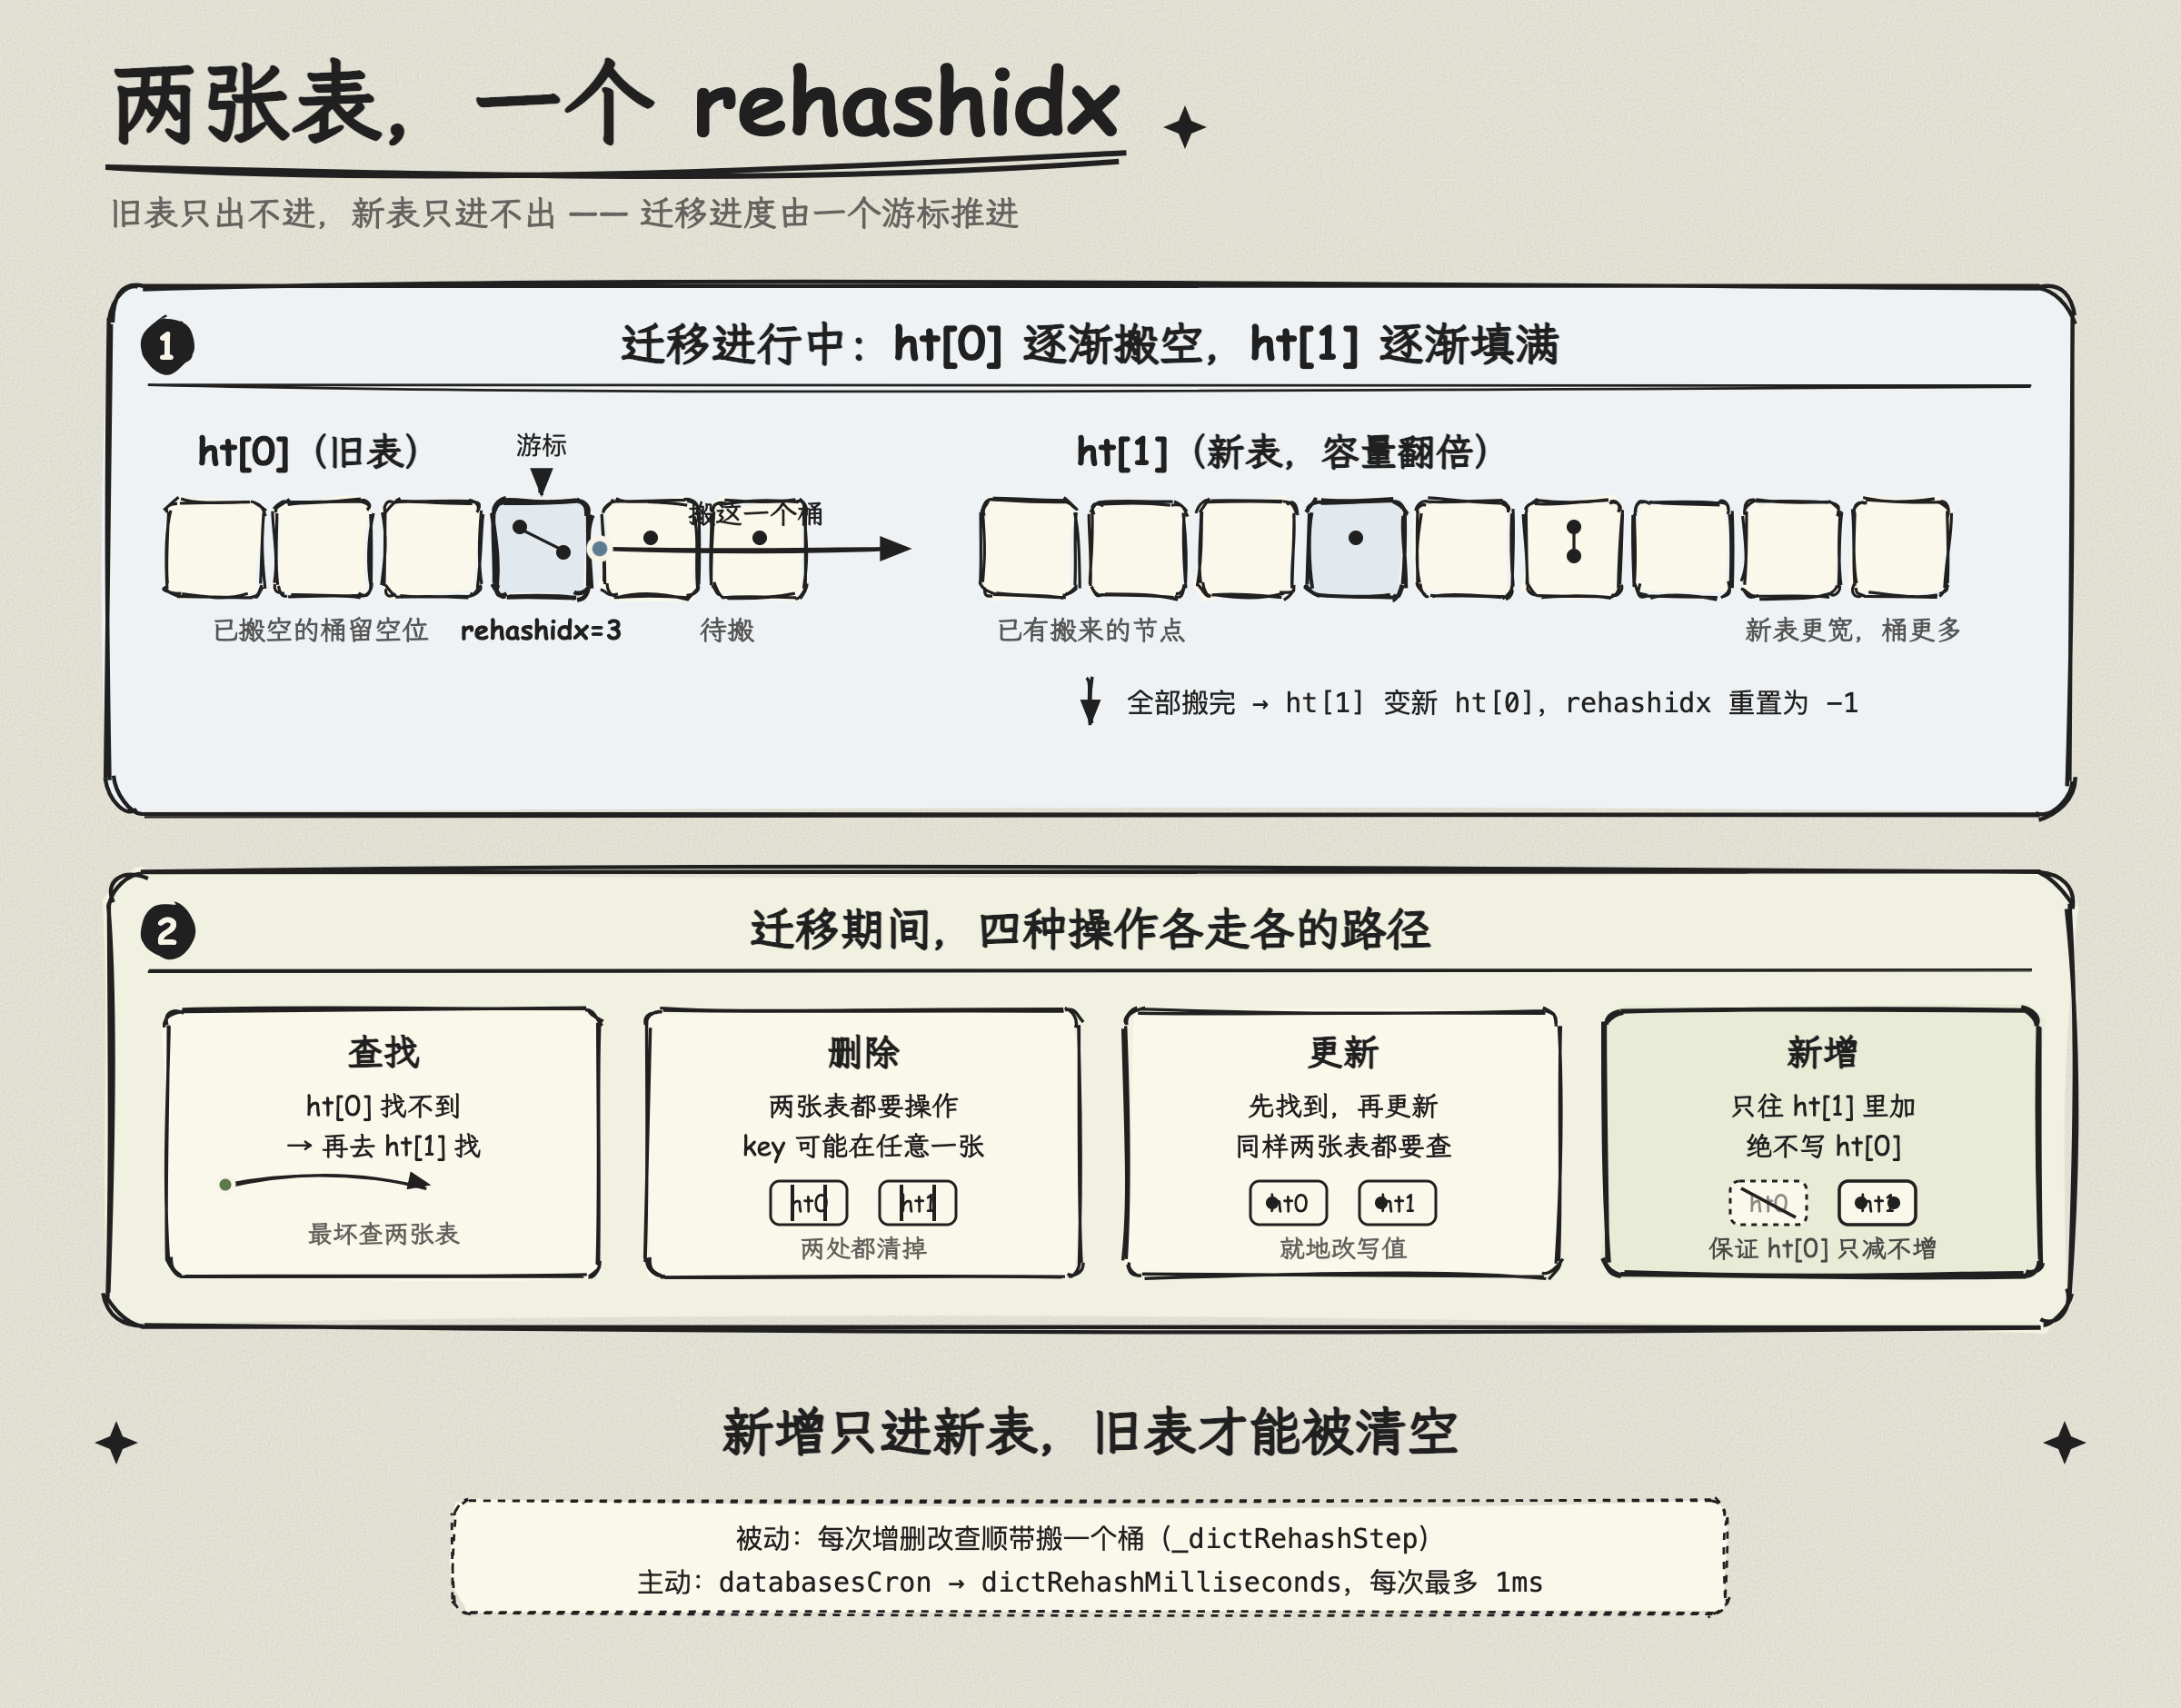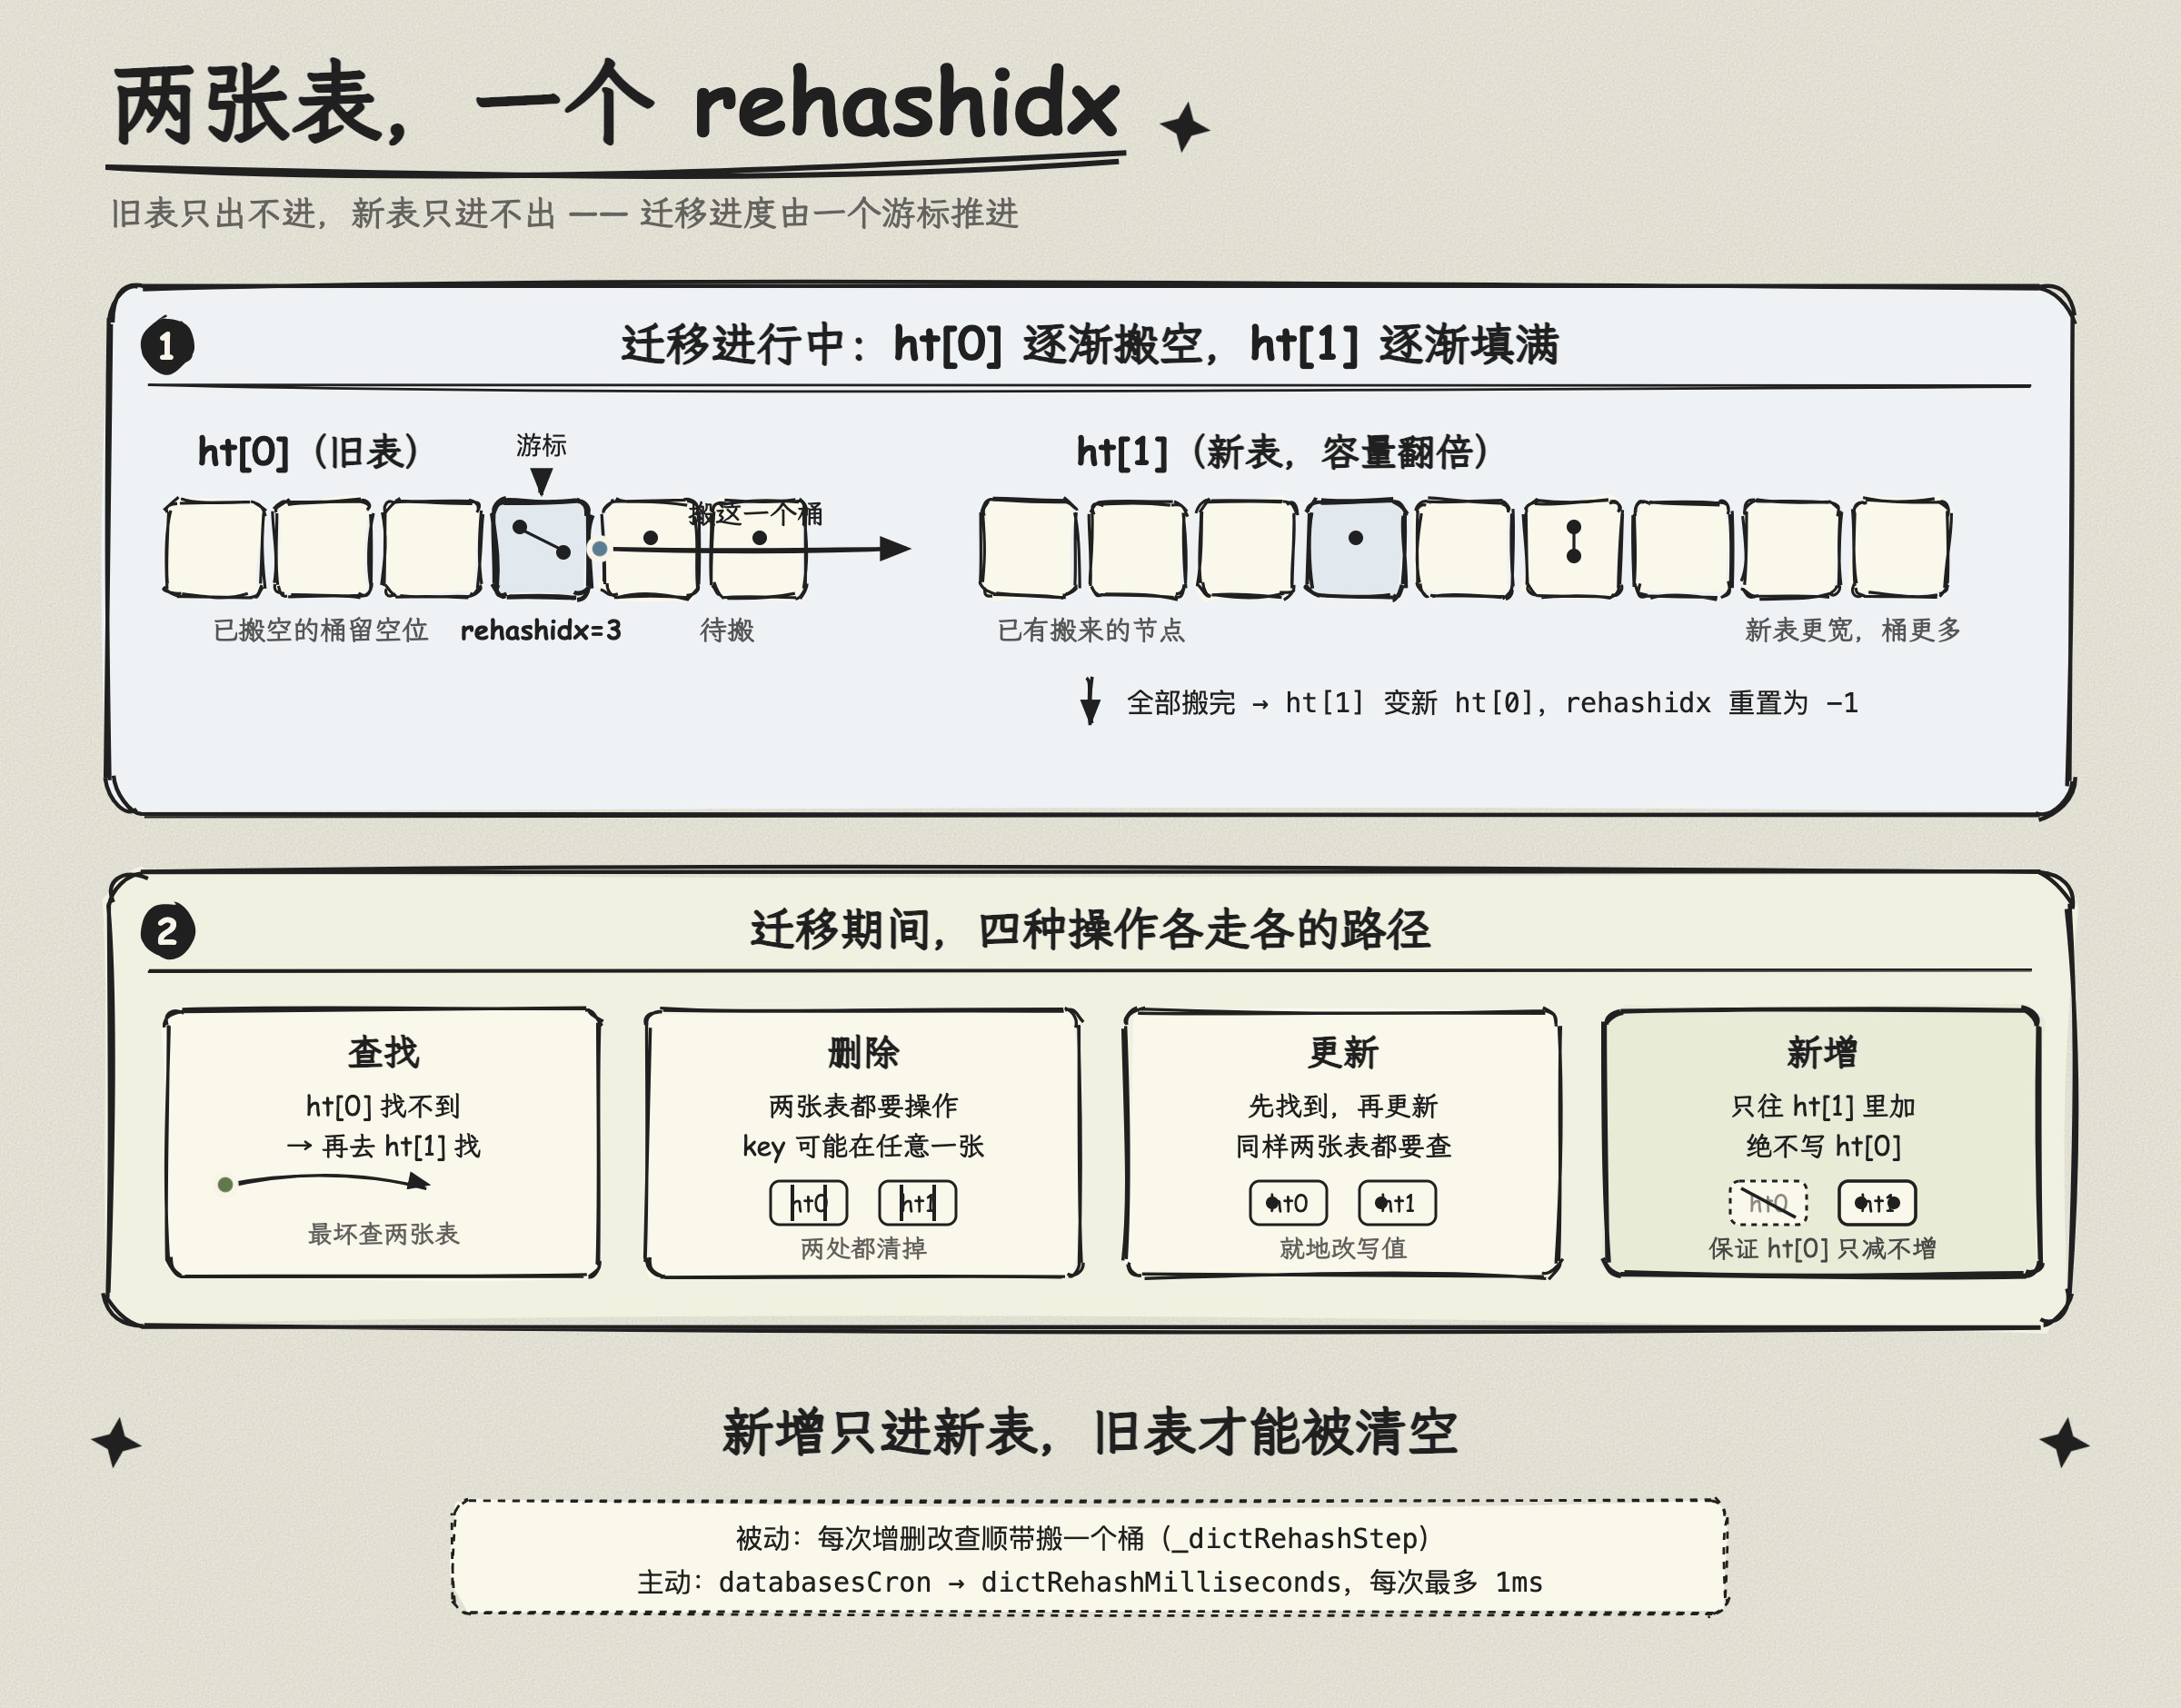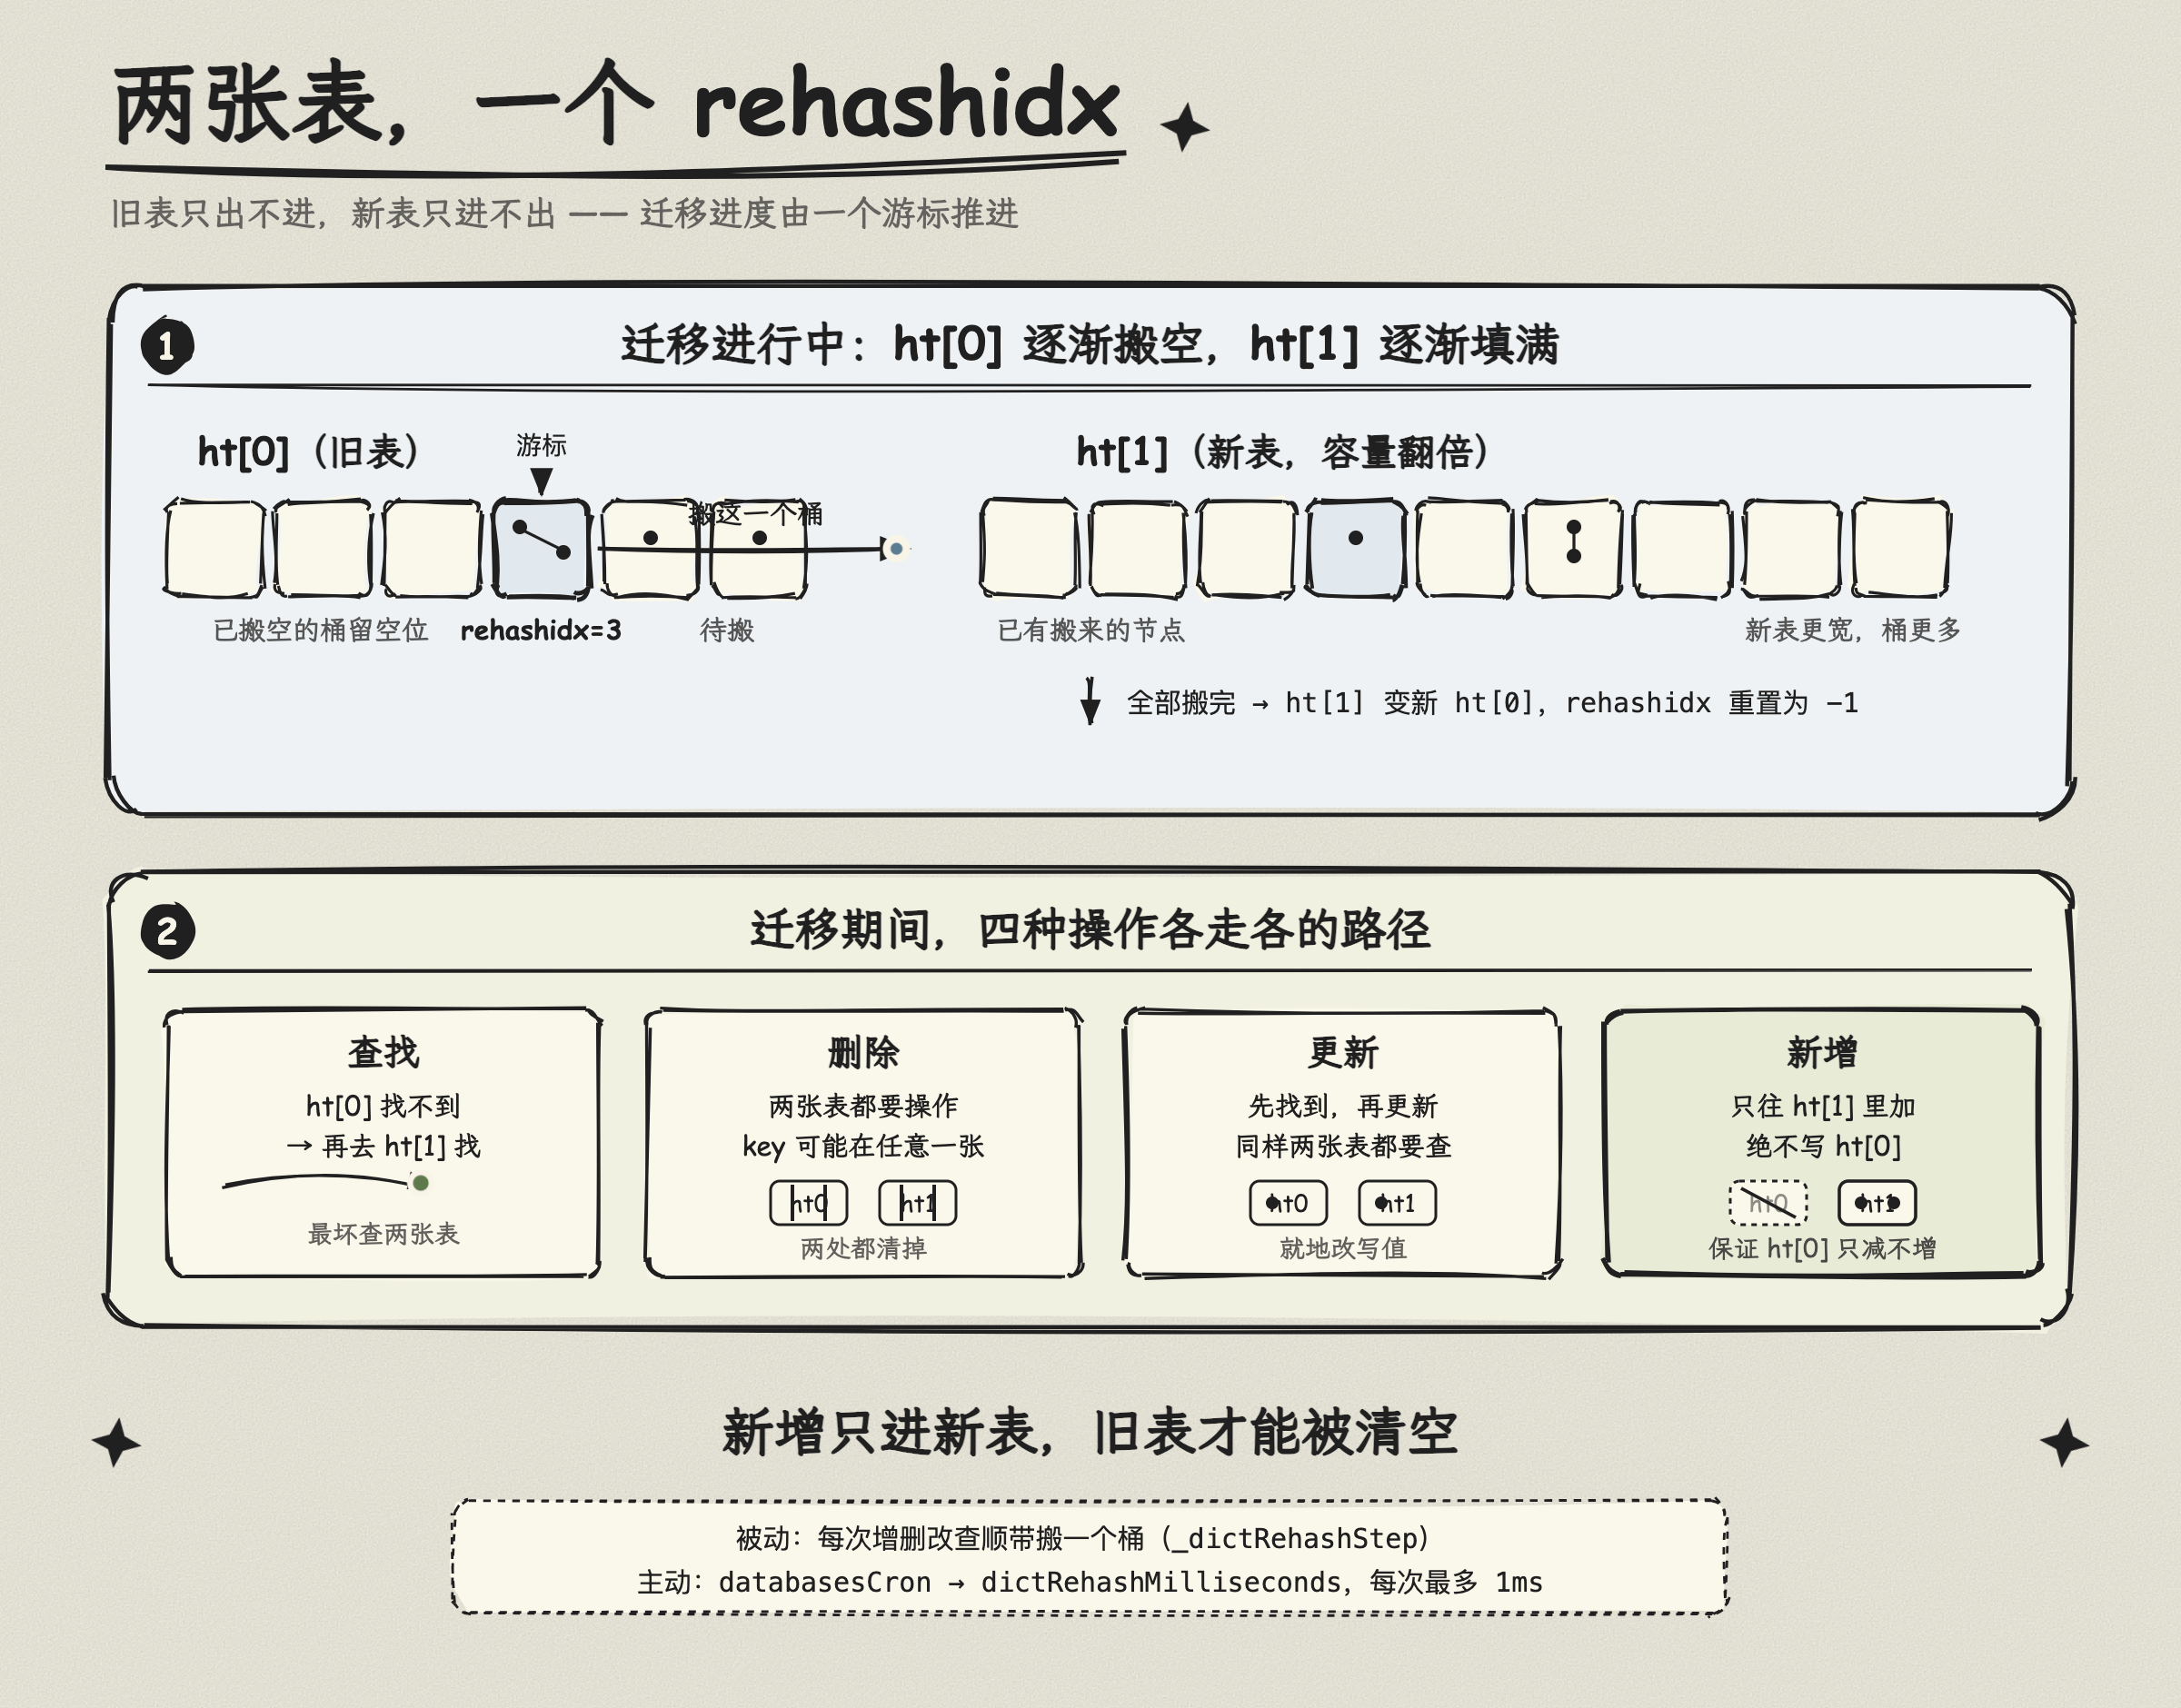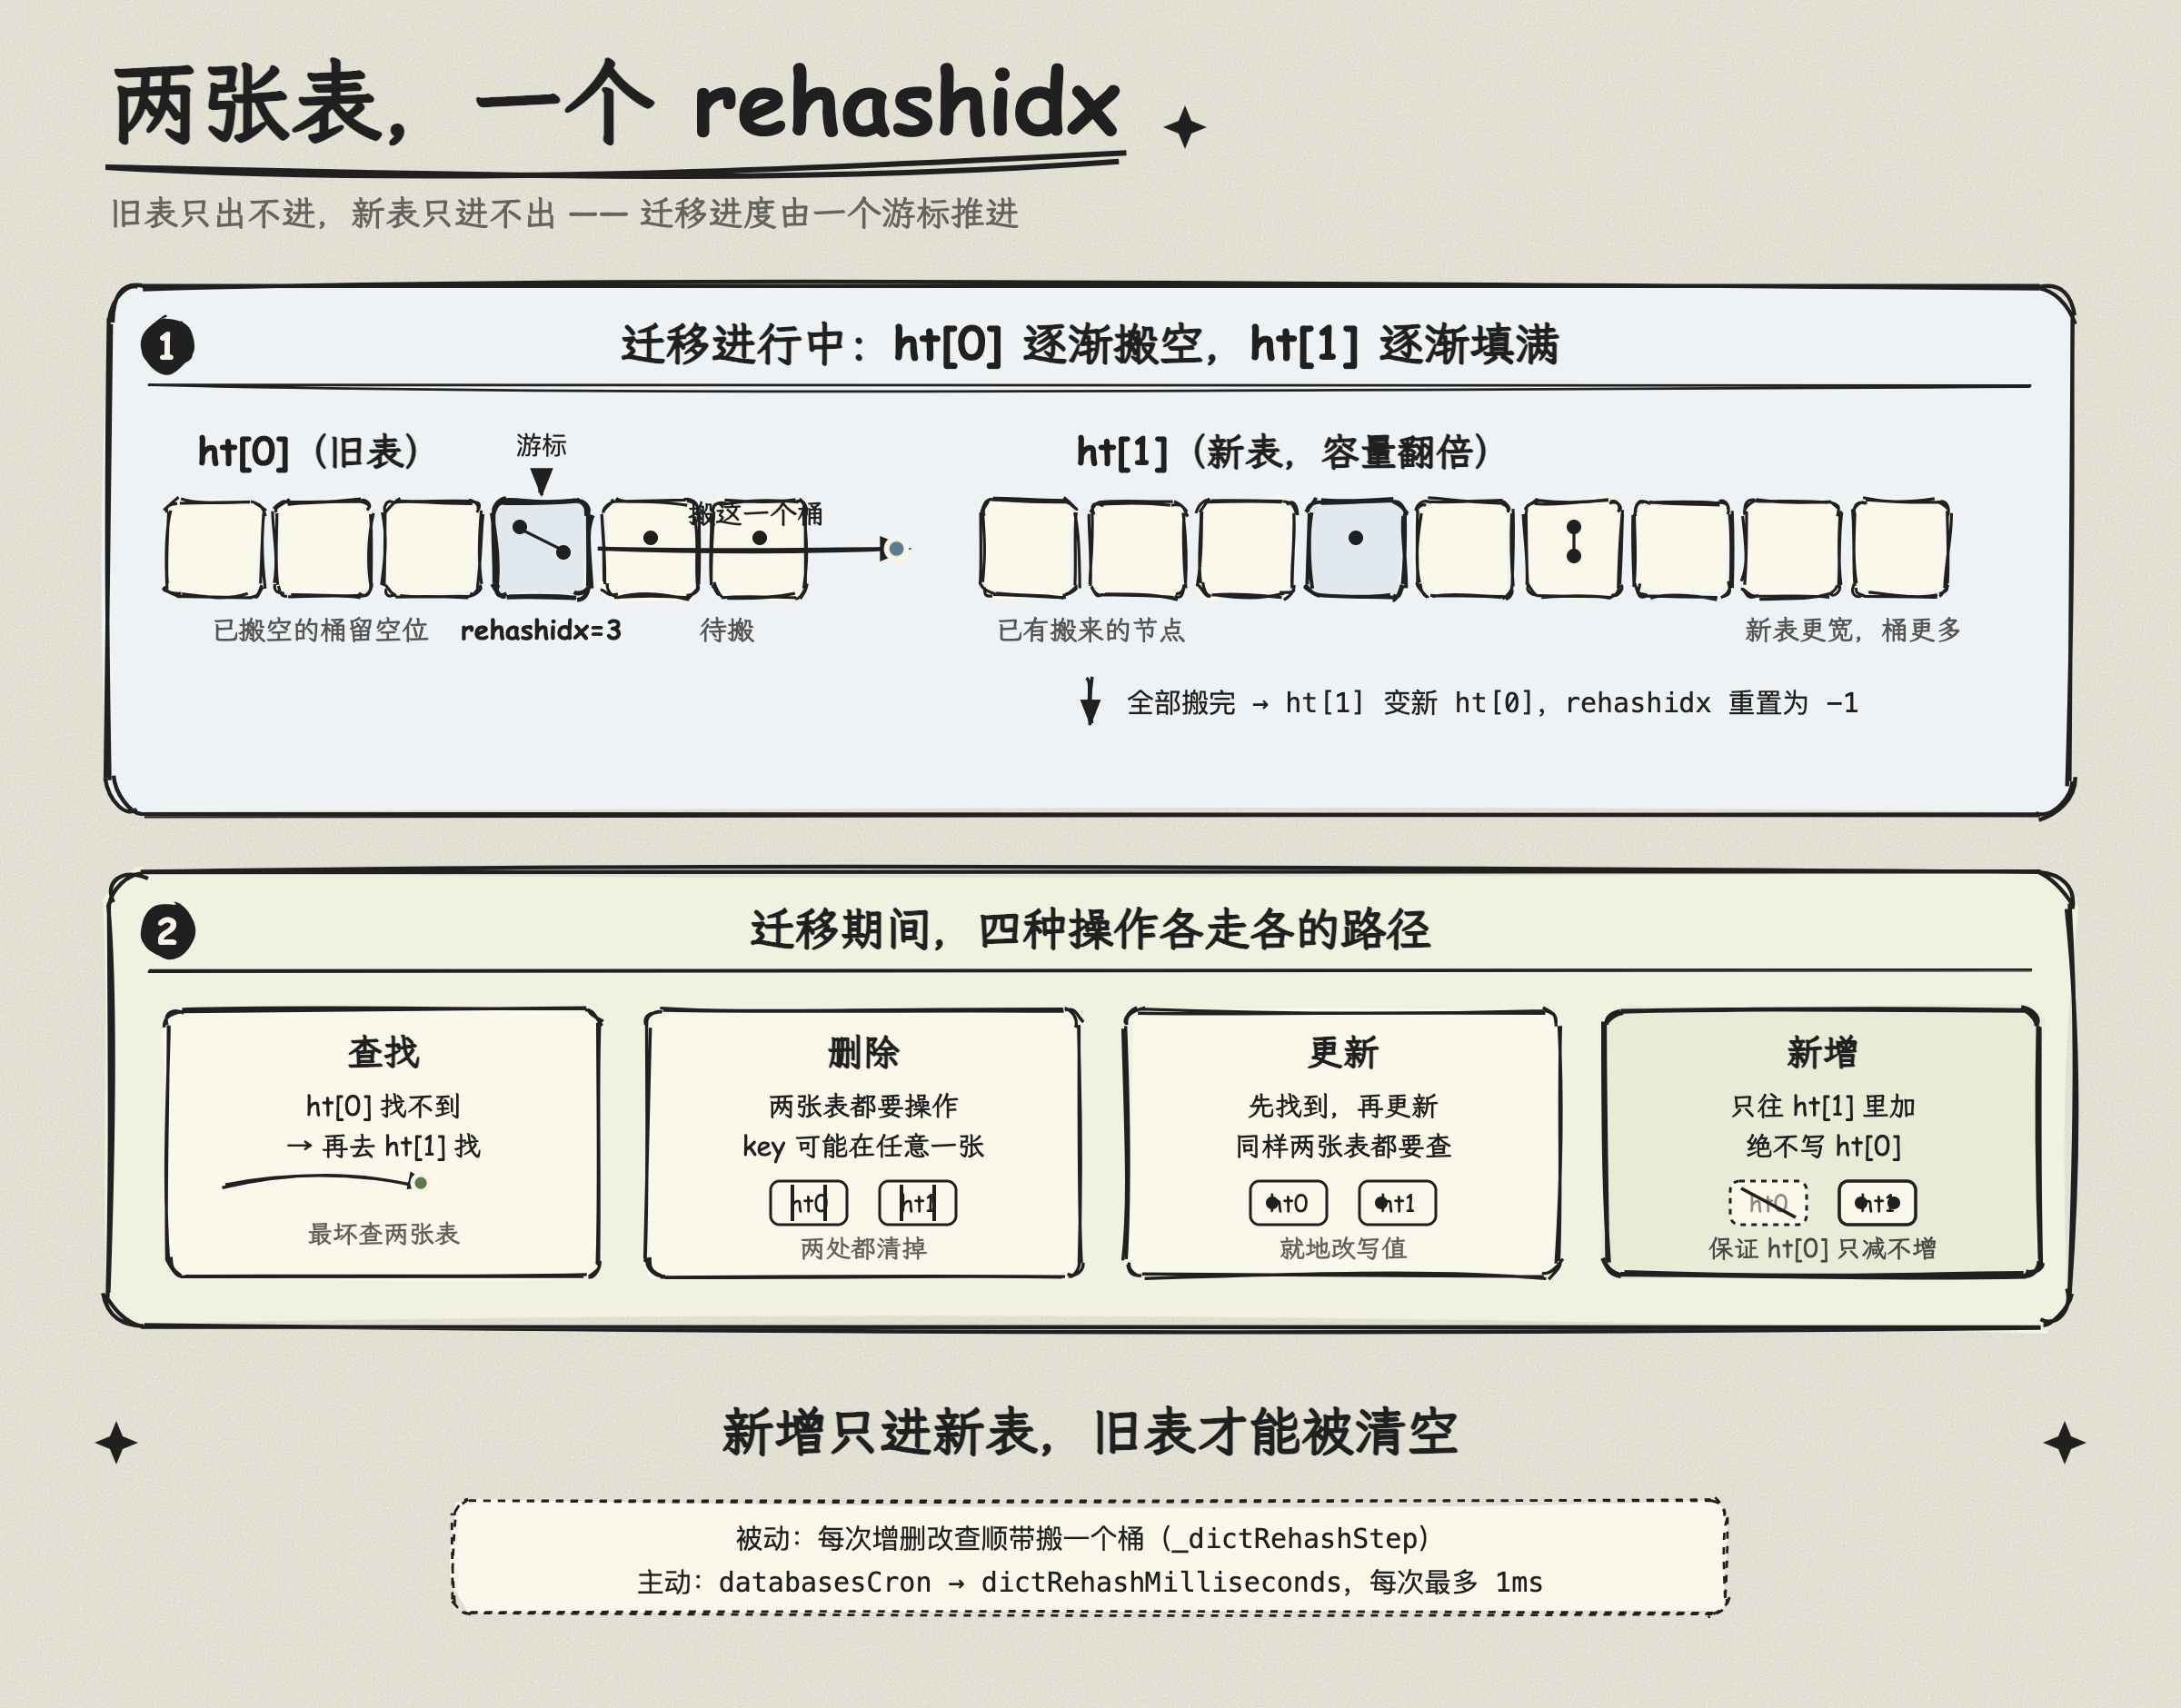
因为 Redis 是单线程的。如果只用一张表,扩容时你得原地把所有元素重新计算位置——这在单线程下意味着什么都干不了。两张表 + 一个 rehashidx 索引,让迁移可以“边干活边搬”。

每个哈希表底层是数组 + 链表,用链地址法解决冲突。dictEntry 就是链表节点,同一个桶里的元素用 next 指针串起来。

图 1:两张表怎么协作。上半部分画迁移进行中的状态——ht[0] 左侧几个桶已经搬空,游标 rehashidx 停在当前要处理的桶上,箭头表示这一次只搬这一个桶(桶内通常 1~5 个节点),搬完游标右移一格;ht[1] 是新分配的、容量翻倍的表,搬来的节点落在里面。下半部分把迁移期间四种操作的规则并排放:查找要先查 ht[0] 再查 ht[1],删除和更新两张表都要动,而新增只写 ht[1]——最后这条是关键,它保证 ht[0] 的节点数只减不增,否则旧表永远清不空。


二、一次性 rehash 到底会阻塞多久?

这是核心问题。要回答它,先看数据量。

假设:一个字典有 1 亿个键值对。

关键数字:Redis 迁移一个键值对的典型耗时,保守估计在 100 纳秒左右。

那么:

1
1 亿 × 100 ns = 10,000,000,000 ns = 10 秒

10 秒。 在这 10 秒里,Redis 的主线程完全被占住。所有客户端请求全部排队等待。 对于一个标榜 P99 延迟在毫秒级的服务来说,这是灾难性的。

更极端的场景:如果 value 是大 key(比如一个几百 MB 的 List),单次迁移的耗时可能以秒为单位。有测试数据显示,迁移一个 600MB 的 list 类型 key 需要 6.7 秒。这还只是一个 key。

所以答案很明确:一次性 rehash 的阻塞时间与数据量成正比,在百万级以上的字典中,阻塞时间会达到秒级甚至更长。 对 Redis 来说,这等于服务中断。

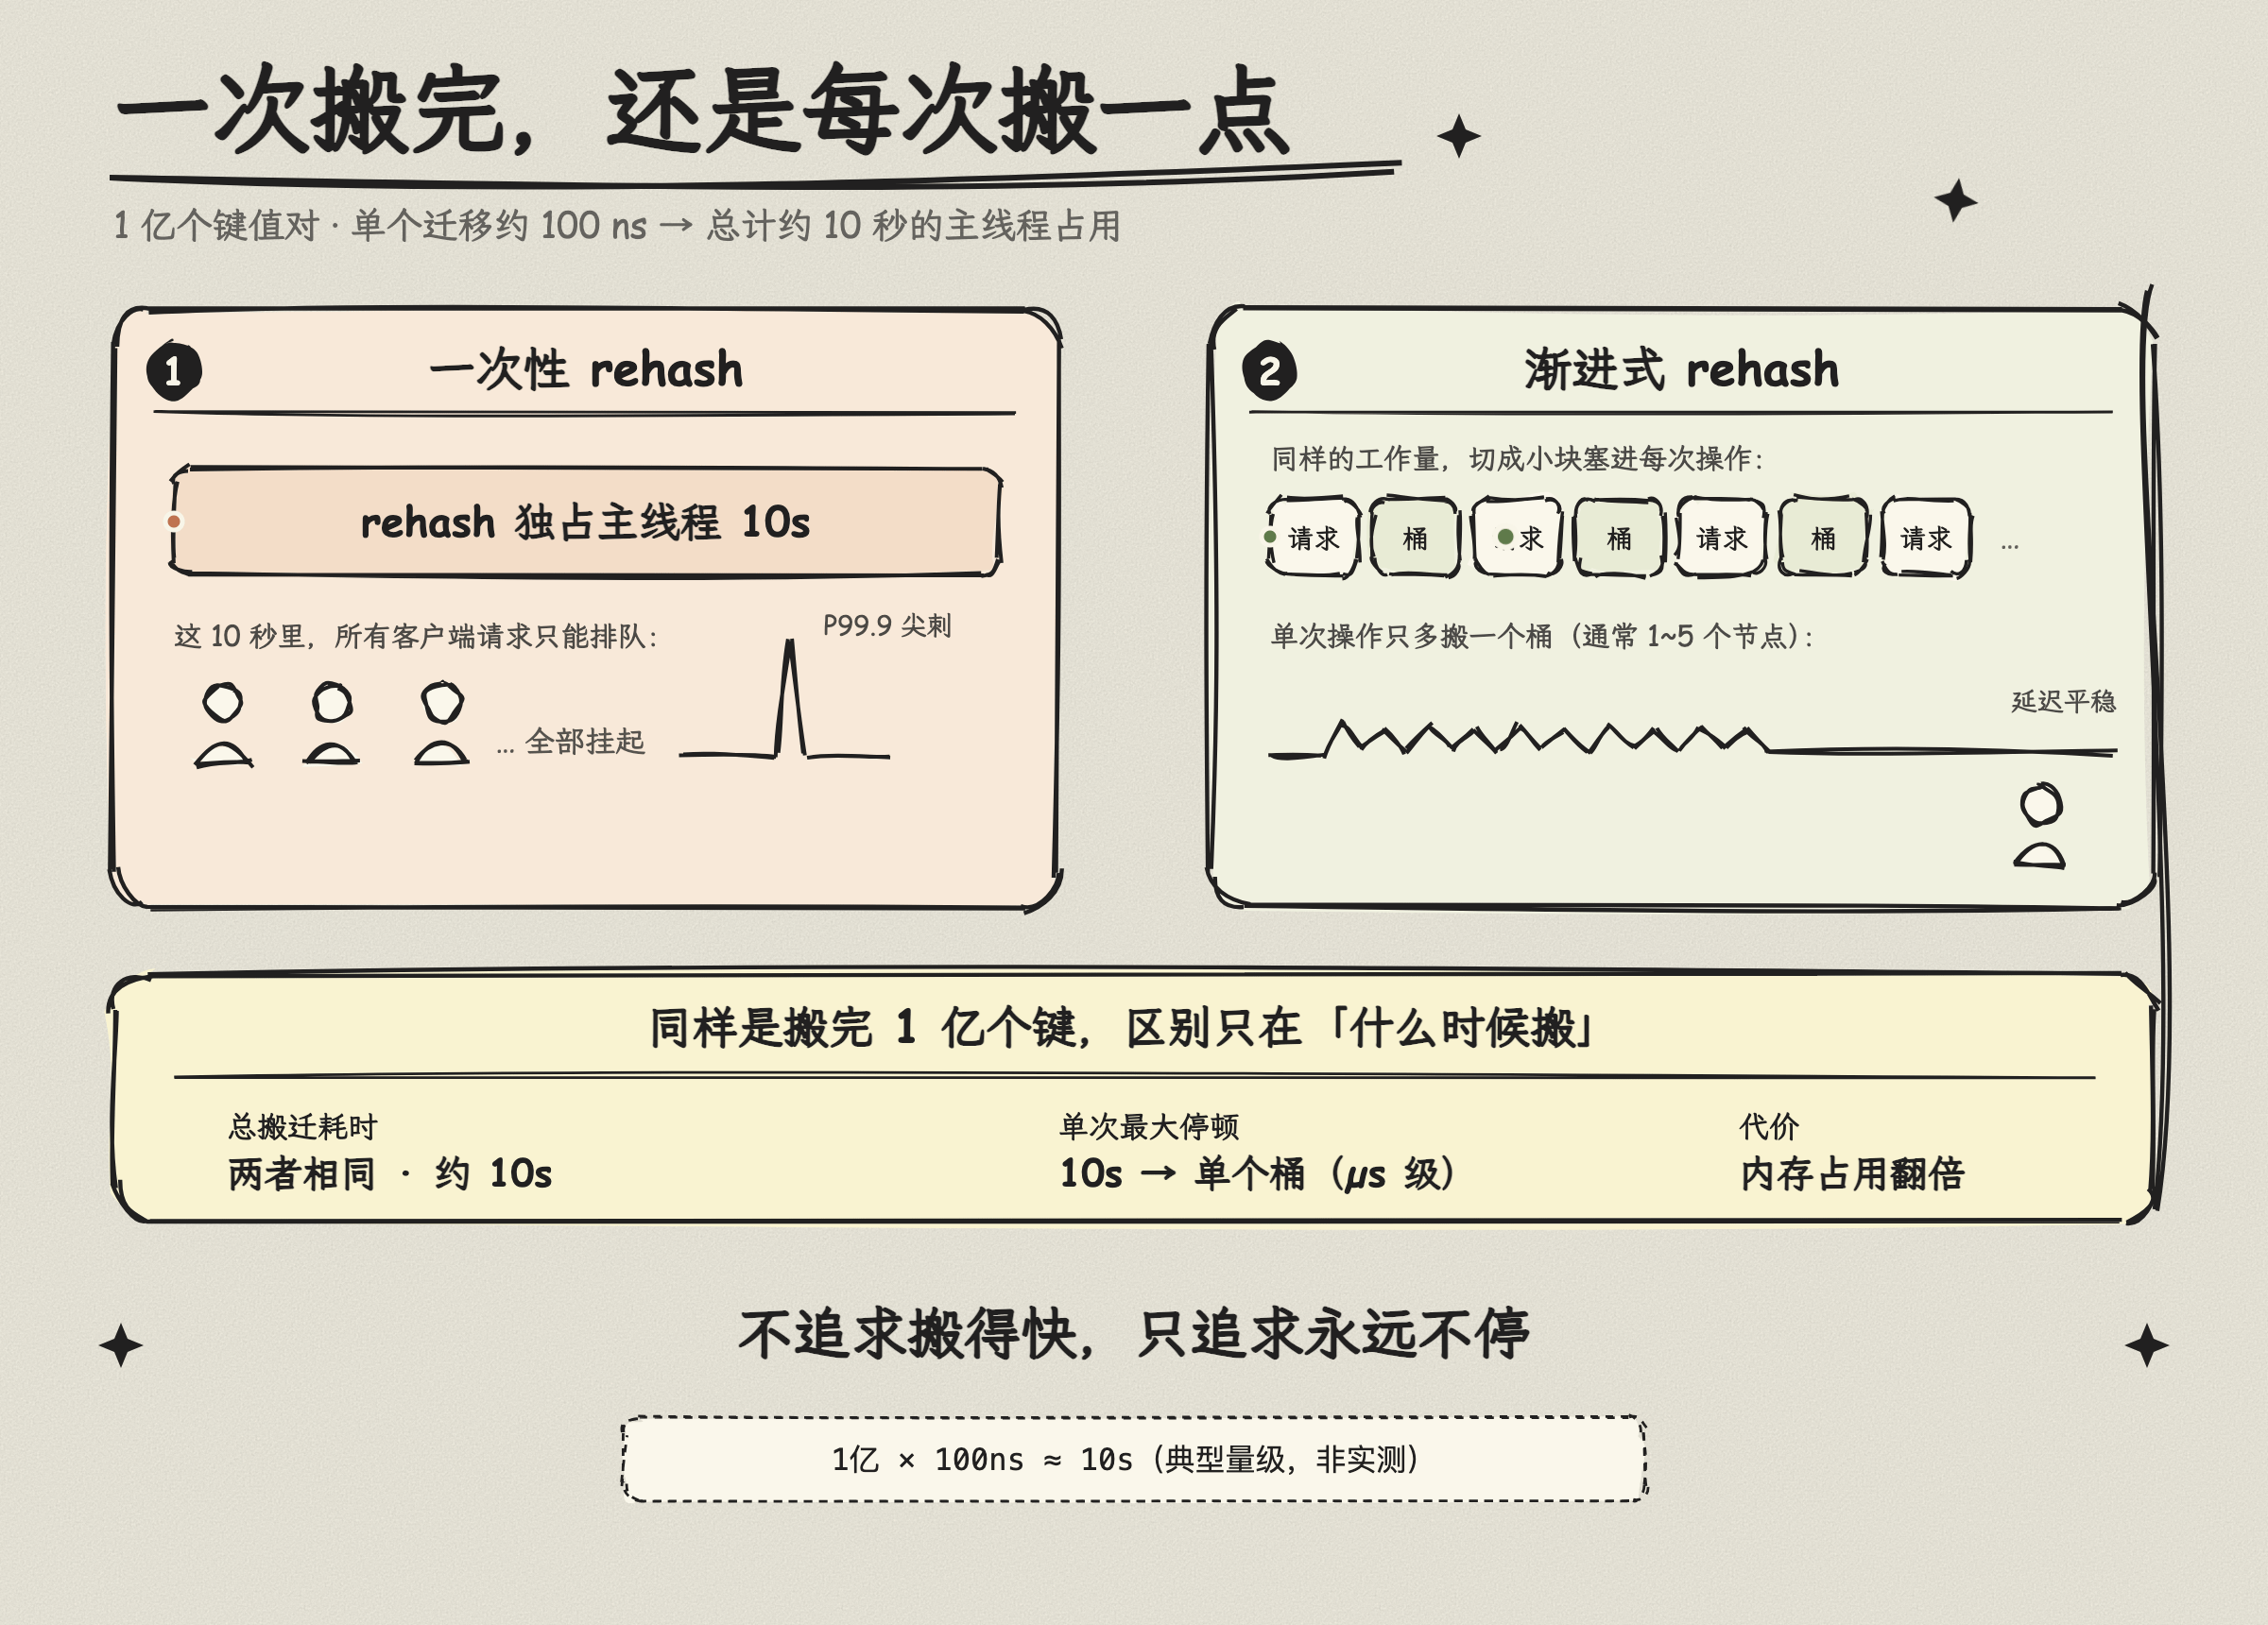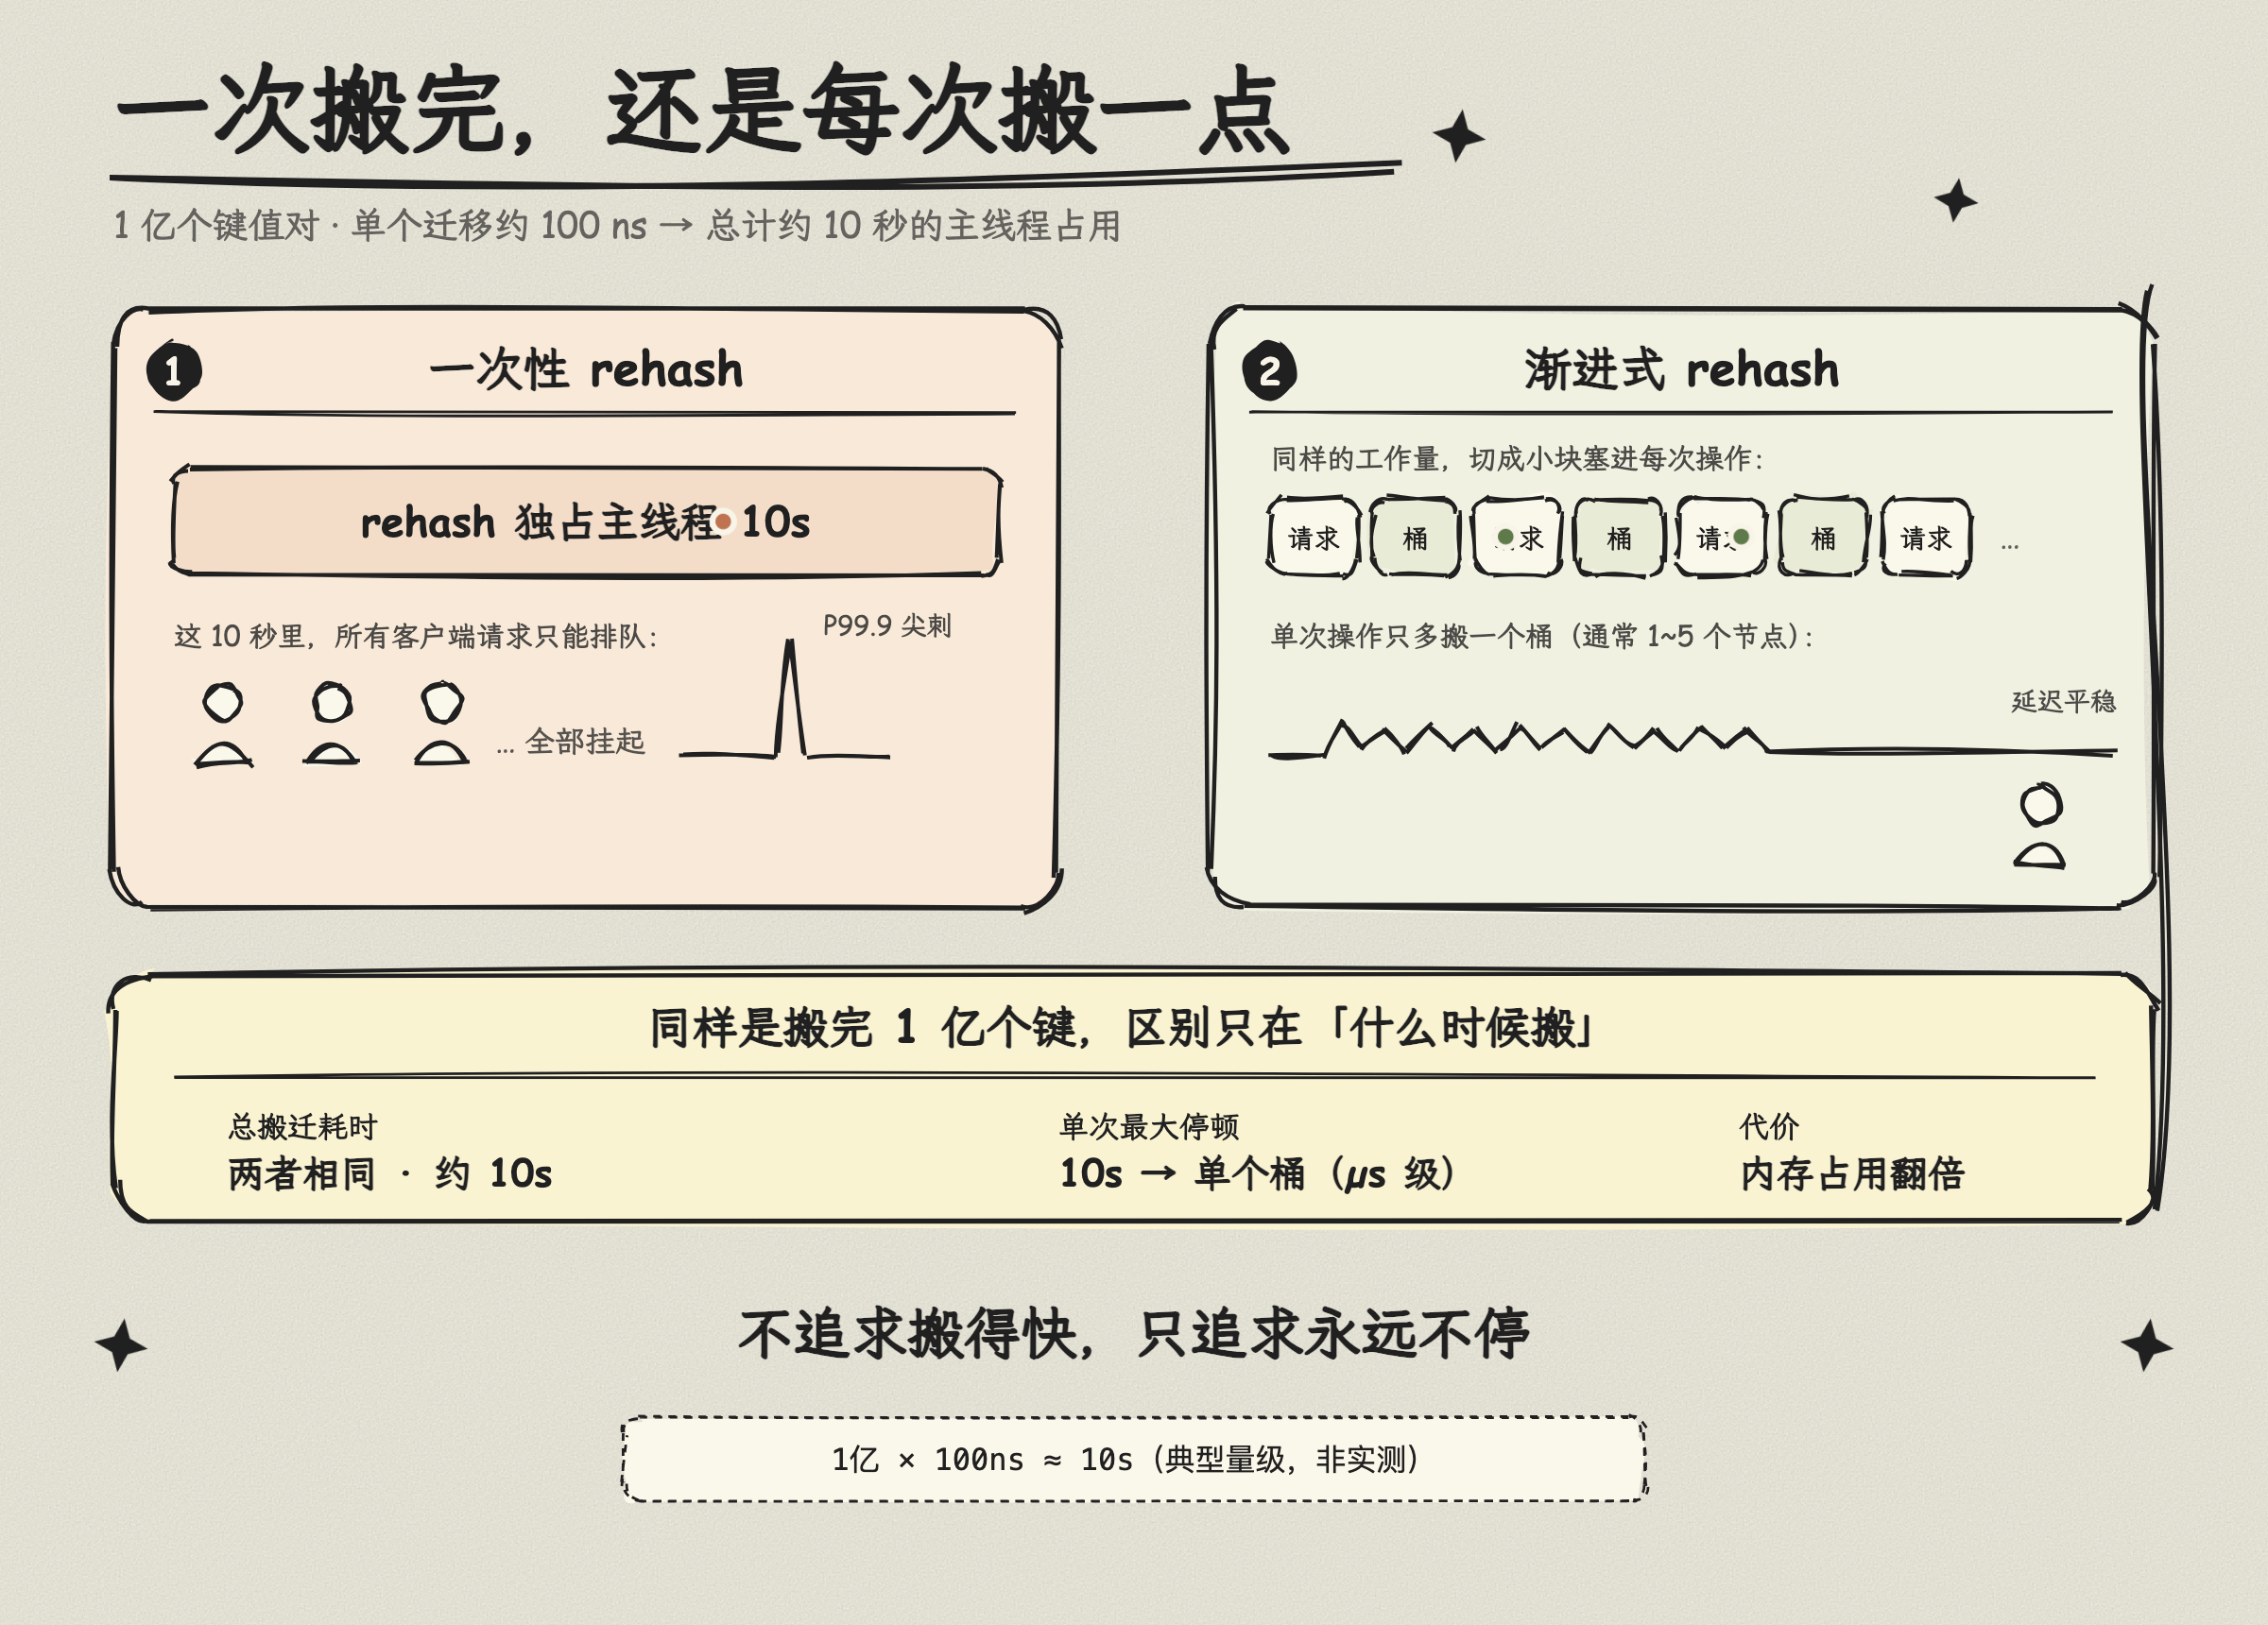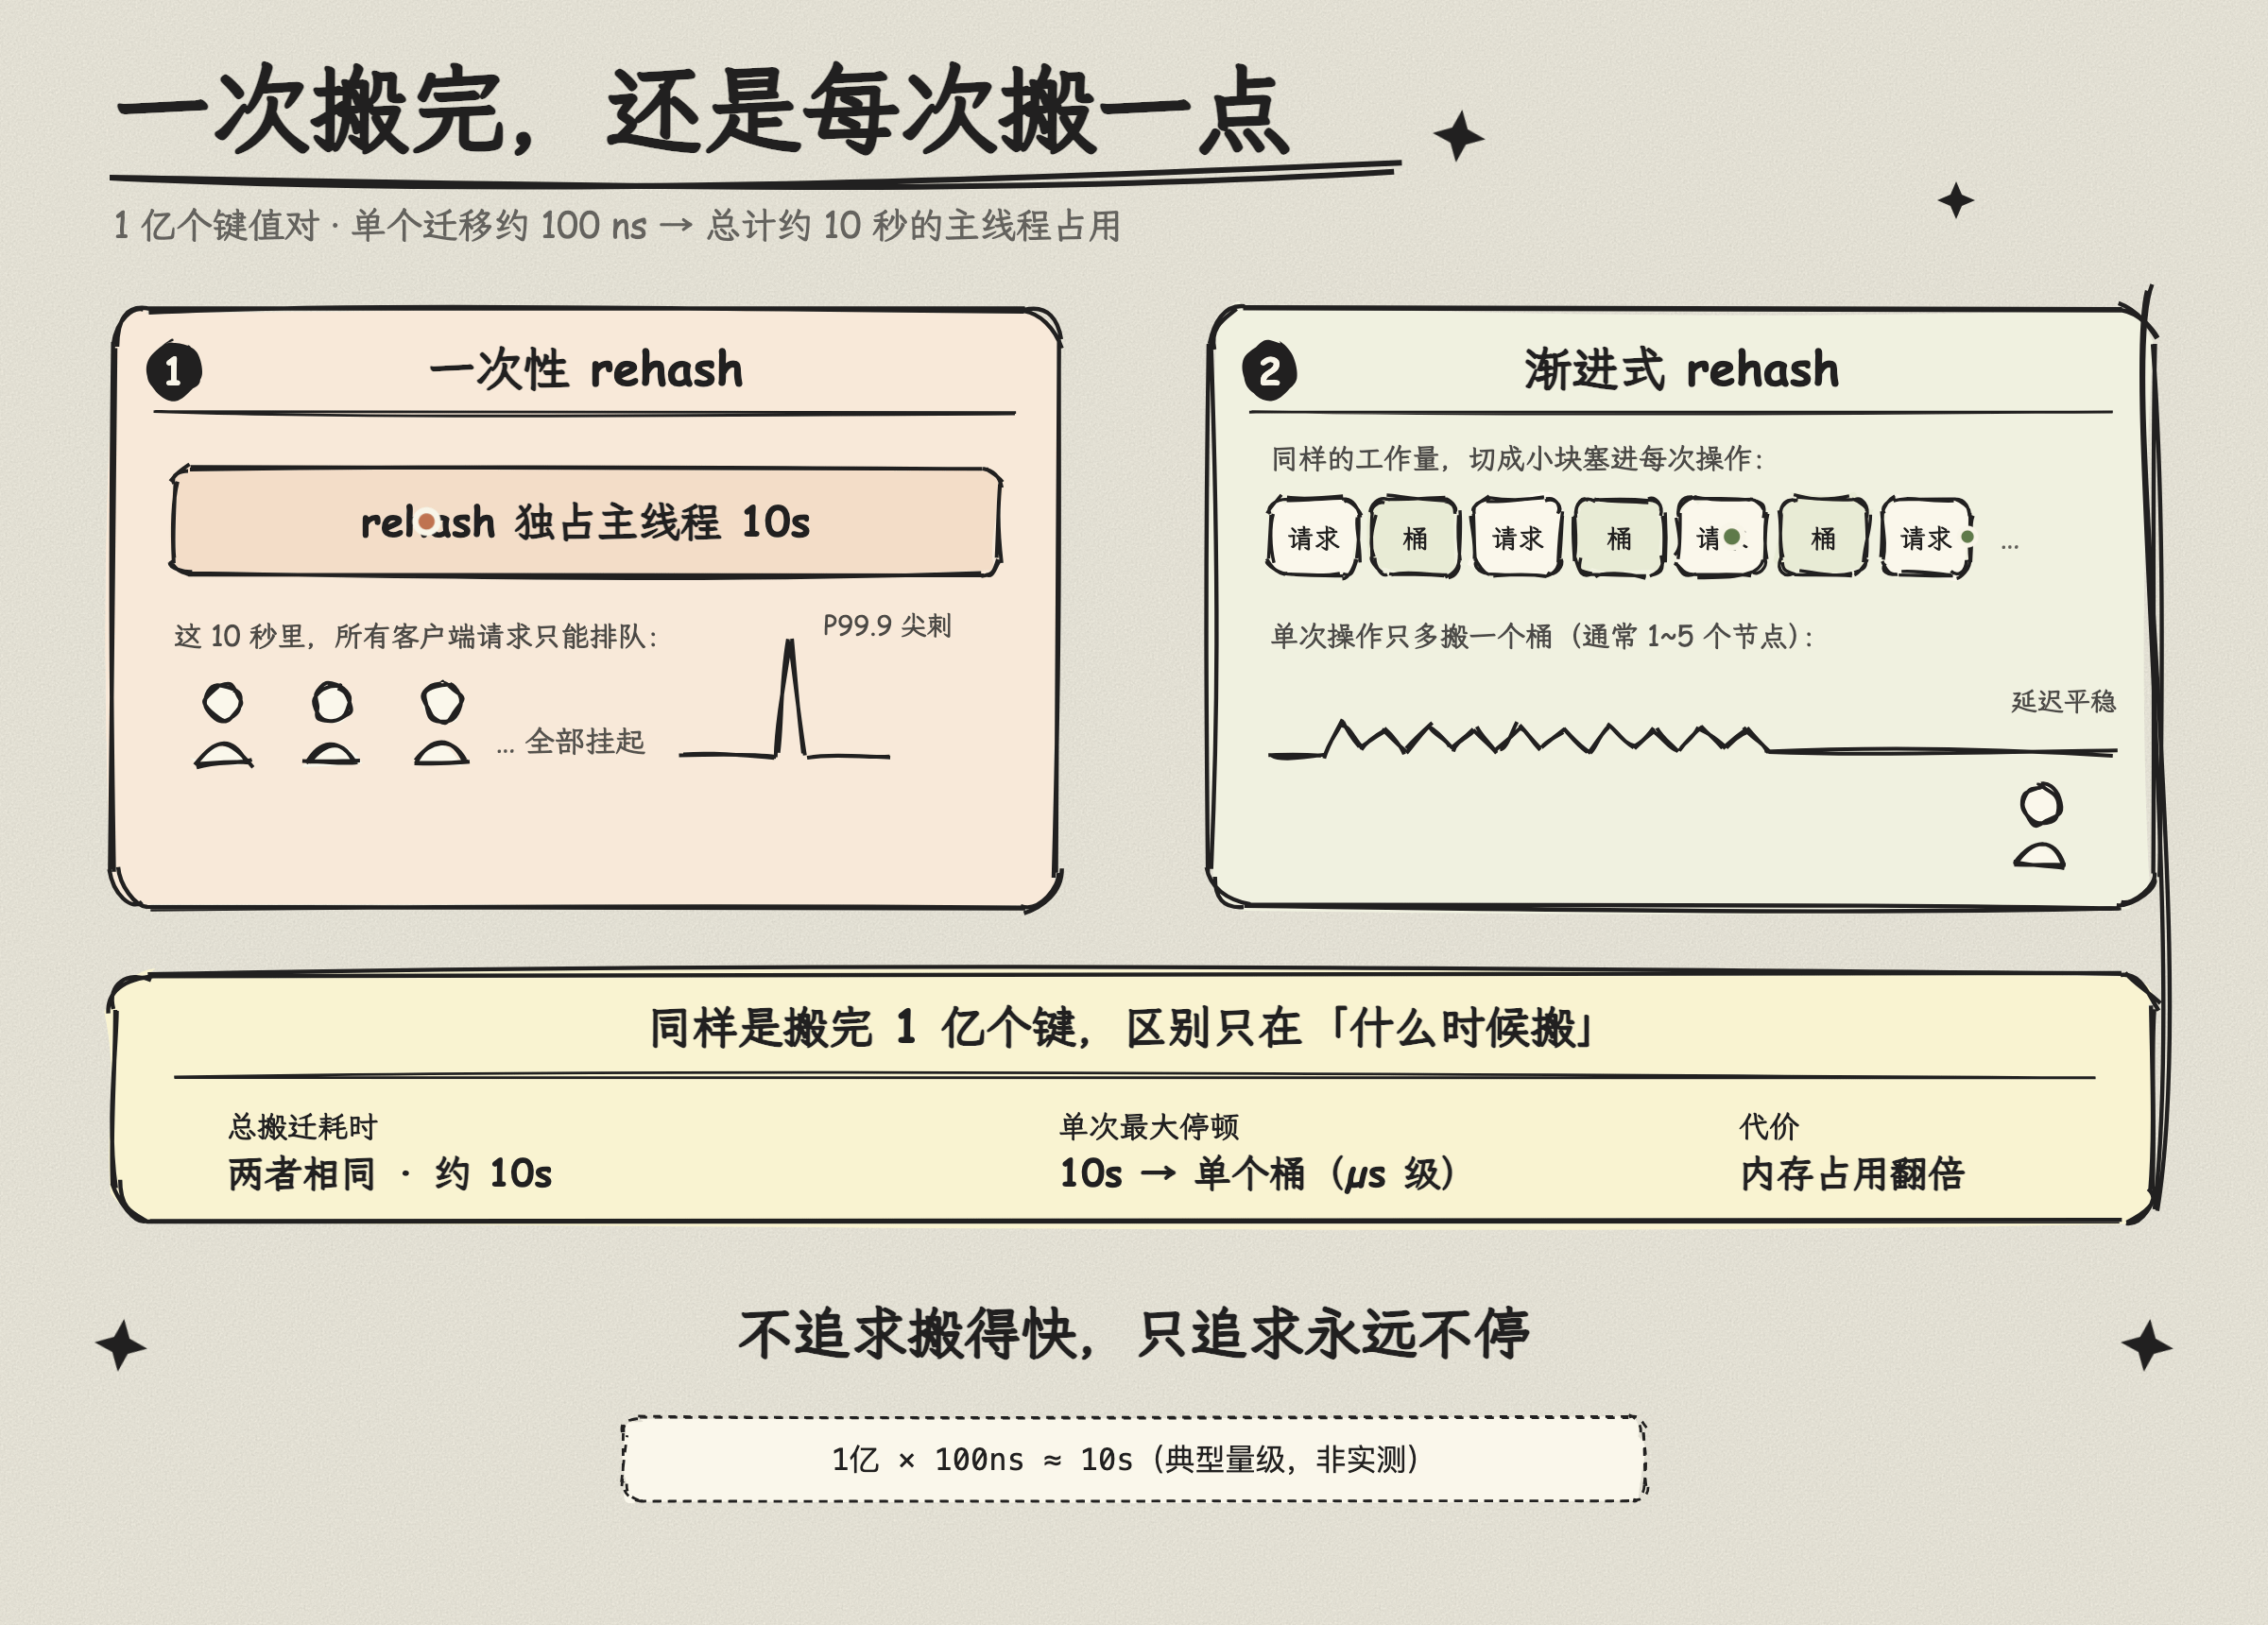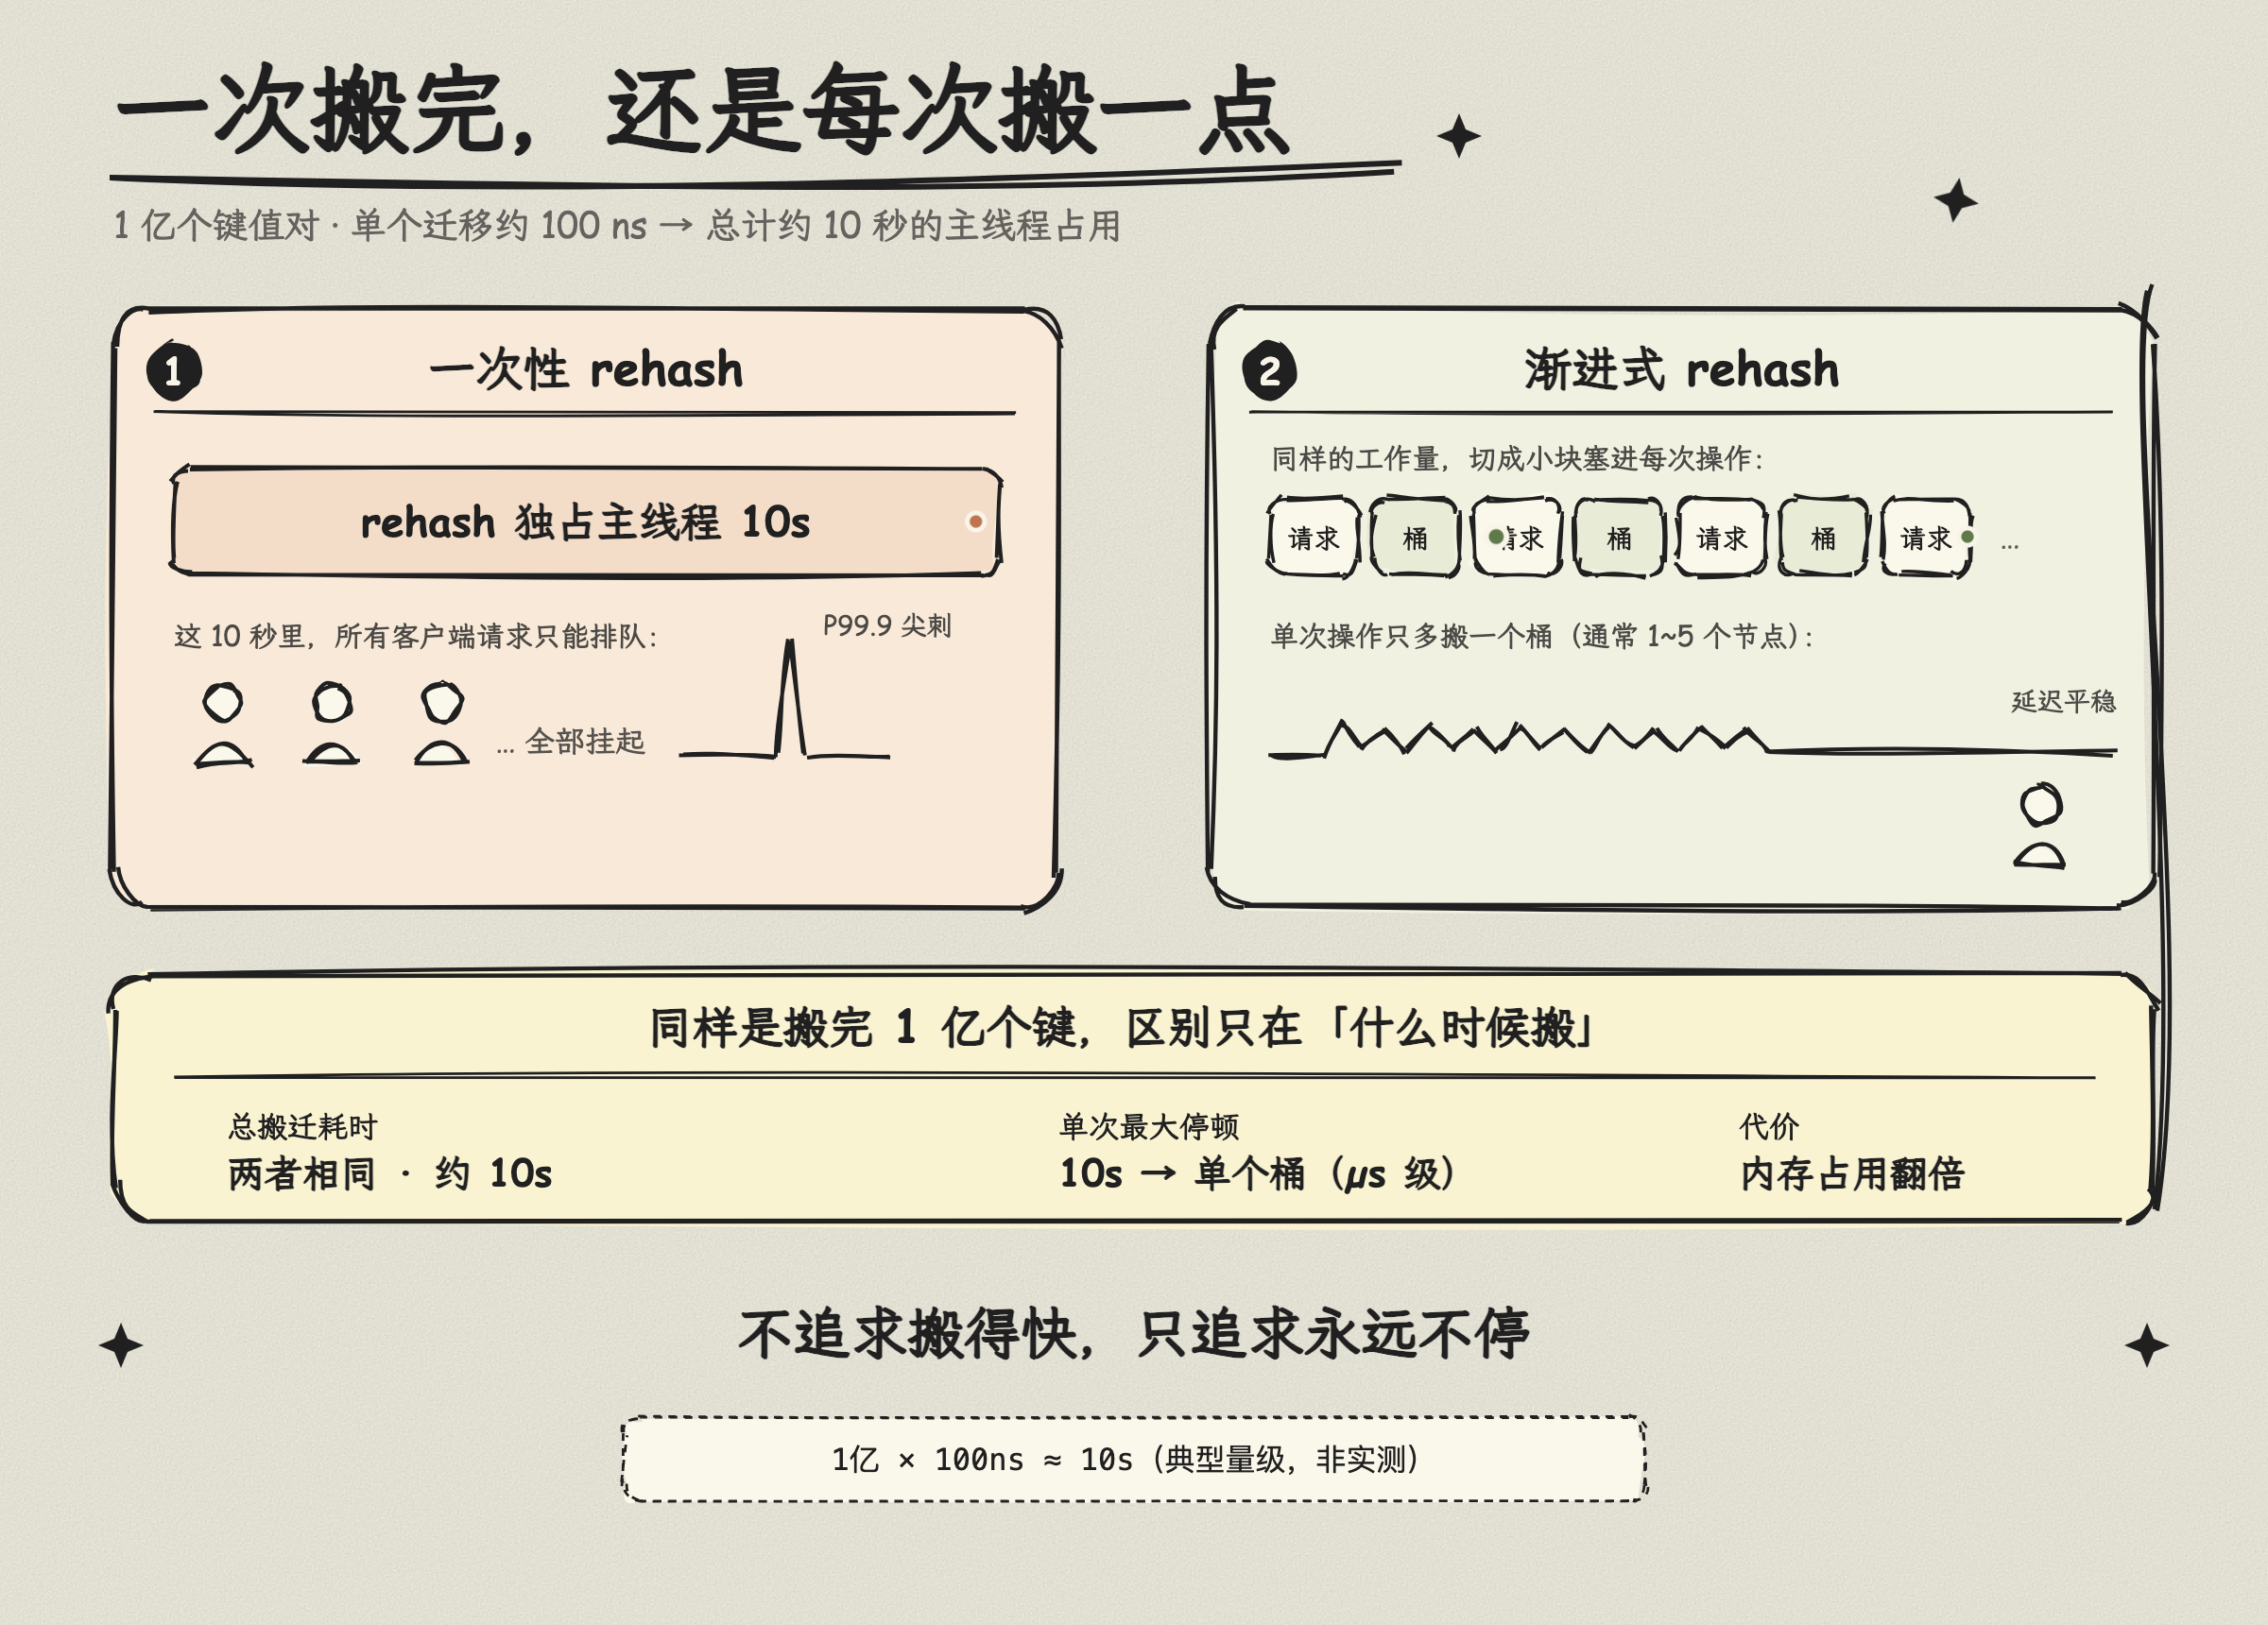
图 2:两种搬法的差别只在“什么时候搬”。左边一次性 rehash 把全部工作压成一根长条——这 10 秒里主线程被占满,客户端请求只能排队,延迟曲线上出现一根 P99.9 尖刺;右边渐进式 rehash 用同样的总工作量,但把它切成一个个小格,和请求交替执行,单次操作只多搬一个桶,延迟曲线保持平稳。底部一行是这张图的重点:两者*总搬迁耗时相同(都是约 10 秒的 CPU 工作量),差别只在单次最大停顿——从 10 秒降到微秒级的单桶开销,代价是迁移期间内存占用翻倍。*


三、渐进式 rehash 到底“渐进”在哪里?

Redis 的解法是:不一次性搬完,而是把搬迁工作分摊到每一次操作里。

具体机制:

  1. 扩容时,为 ht[1] 分配新空间(通常是 ht[0].used * 2 向上取最近的 2 的幂);
  2. 把 rehashidx 设为 0,表示 rehash 正式开始;
  3. 每次对字典执行增删改查时,顺带把 ht[0] 中 rehashidx 位置上的整个桶(链表上所有节点)迁移到 ht[1];
  4. 迁移完成后,rehashidx 加一,指向下一个桶;
  5. 当所有桶都迁移完毕,把 ht[1] 设为新的 ht[0],清空旧表,rehashidx 重置为 -1。

关键细节:一次迁移的是一个“桶”,不是“一个键值对”。因为一个桶可能是一个链表,上面挂着多个节点。但从实际数据看,由于负载因子控制在合理范围,平均每个桶通常只有 1 个节点,最多一般不超过 5 个。所以单次迁移的开销很小。


四、迁移过程中,增删改查怎么处理?

这是设计中最精妙的部分。两个表同时存在,但操作规则不同。

操作 规则
查找 先在 ht[0] 找,找不到再去 ht[1] 找
删除 两个表都要操作(因为 key 可能在任意一个表里)
更新 两个表都要操作(先找到,再更新)
新增 只往 ht[1] 里加,绝不往 ht[0] 加

新增只写 ht[1] 的原因很直接:保证 ht[0] 的节点数量只减不增。 如果新增还往旧表里写,那 ht[0] 永远清不空,rehash 永远结束不了。

这个规则带来的一个副作用是:迁移期间的查找可能比平时稍慢,因为最坏情况下要找两张表。但这是可接受的代价。


五、为什么是“每次操作顺带搬”,而不是“分批定时搬”?

Redis 其实两种都有。

  • 被动搬迁:每次增删改查时顺带迁移一个桶(_dictRehashStep);
  • 主动搬迁:服务器定时任务(databasesCron)中调用 dictRehashMilliseconds,在1 毫秒内尽可能多地迁移。

为什么以被动为主、主动为辅?

因为纯定时搬迁有一个问题:如果客户端一直不发请求,定时任务也不一定能保证及时搬完。 而且定时任务的执行时机依赖于 Redis 的事件循环,在高负载时可能被推迟。

被动搬迁的好处是:搬迁的开销天然地跟随负载分布。 请求越多,搬迁越快;请求越少,系统本身也不忙,晚一点搬完也无所谓。这是一种自适应的节奏。

主动搬迁则作为兜底:当客户端闲下来了,没有后续指令来触发被动搬迁时,Redis 不会“置之不理”,而是通过定时任务主动推进。dictRehashMilliseconds 每次只花 1ms 的 CPU 时间做搬迁,然后让出控制权。

所以准确地说:不是“不做定时”,而是“被动为主、定时为辅”。 两者结合,既保证了有请求时搬迁不拖后腿,也保证了没请求时不会永远卡在半途。


六、这个设计牺牲了什么,换来了什么?

牺牲的:

  1. 单次操作略慢。 迁移期间,每次增删改查都可能附带一次搬迁,或者需要查两张表。但开销被控制在单个桶的粒度,通常只有 1~5 个节点,对响应时间的影响很小。
  2. 内存占用翻倍。 rehash 期间两个哈希表同时存在,内存使用量会上升。这是“空间换时间”的典型体现。
  3. 实现复杂度上升。 所有字典操作都必须考虑“是否处于 rehash 状态”,代码路径分叉,更容易出 bug。

换来的:

  1. 不阻塞。 这是最核心的收益。无论字典多大,Redis 主线程永远不会因为 rehash 而停下来。
  2. 平滑的延迟曲线。 一次性 rehash 会导致 P99.9 和 max 延迟飙升;渐进式 rehash 把开销摊薄,让延迟保持稳定。
  3. 自适应节奏。 搬迁进度跟随负载,忙时搬得快,闲时搬得慢,不浪费 CPU。

引用与致谢

本文配图所用资源如下:

封面图

动图(图 1 ~ 图 2)

  • 生成工具:Animated Sketch Diagram —— 一个把技术概念画成「黑墨手绘涂鸦 + 米色纸面」风格动画图的 Claude Code 插件。
  • 项目地址:https://github.com/OLDyade/animated-sketch-diagram
  • 作者:OLDyade
  • 许可:见项目仓库中的 LICENSE 文件。
  • 说明:两张动图均由该工具生成 SVG + CSS 动画后导出为无缝循环 GIF,文字内容依据本文正文整理。图中数据为示意值(1 亿键、单次 100 ns、约 10 秒总耗时、桶内 1~5 个节点等,取的是文中给出的典型量级),不是某次真实压测的结果。

感谢阅读。

选择哈希表、跳表还是 B+ 树,本质上不是在选“哪个数据结构更好”,而是在回答一个问题:你的数据放在哪里,以及你打算怎么查它。

如果数据全在内存里、只按 key 精确找,哈希表是首选;如果数据在内存里、既要按 key 找又要按顺序取一段,跳表是那个“刚刚好”的答案;如果数据在磁盘上、既要等值查又要范围扫还要排序,B+ 树是几十年工程实践筛选出来的默认选项——但“磁盘”本身还要再拆一层:机械硬盘(HDD)和固态硬盘(SSD)的瓶颈不同,选型结论也会随之松动。

下面按场景拆开讲。


一、哈希表:只解决“这一个 key 在哪”

哈希表的核心优势只有一个:等值查询期望 O(1)。给定一个 key,算个哈希,直接跳到数组对应位置。没有树高,没有指针跳转,没有页分裂。

但它的问题也同样明确:数据是无序的。哈希函数打散了顺序,你无法高效地回答“比这个 key 大的下一个是谁”或者“把 100 到 200 之间的都取出来”。

所以哈希表的适用边界很清晰:

  • 纯内存场景。哈希表依赖连续数组和指针跳转,放到磁盘上,一次查询可能对应多次随机 I/O;更关键的是它无法把多个 key 打包进一个页,扩容和冲突处理在磁盘上代价极高。磁盘哈希并非完全不存在(如某些 KV 引擎的哈希索引),但在需要范围/排序的场景下劣势明显,工程复杂度也高。
  • 只有等值查询。Memcached、Redis 的键值对空间、以及各种内存字典,都是这个场景。一旦业务需要 WHERE id > 100 或者 ORDER BY,哈希表直接出局。

一句话:如果你确定永远不需要范围查询和排序,哈希表是最快的。但真实业务里,“永远确定”往往不成立。


二、跳表:内存里的有序结构,用简单换确定性

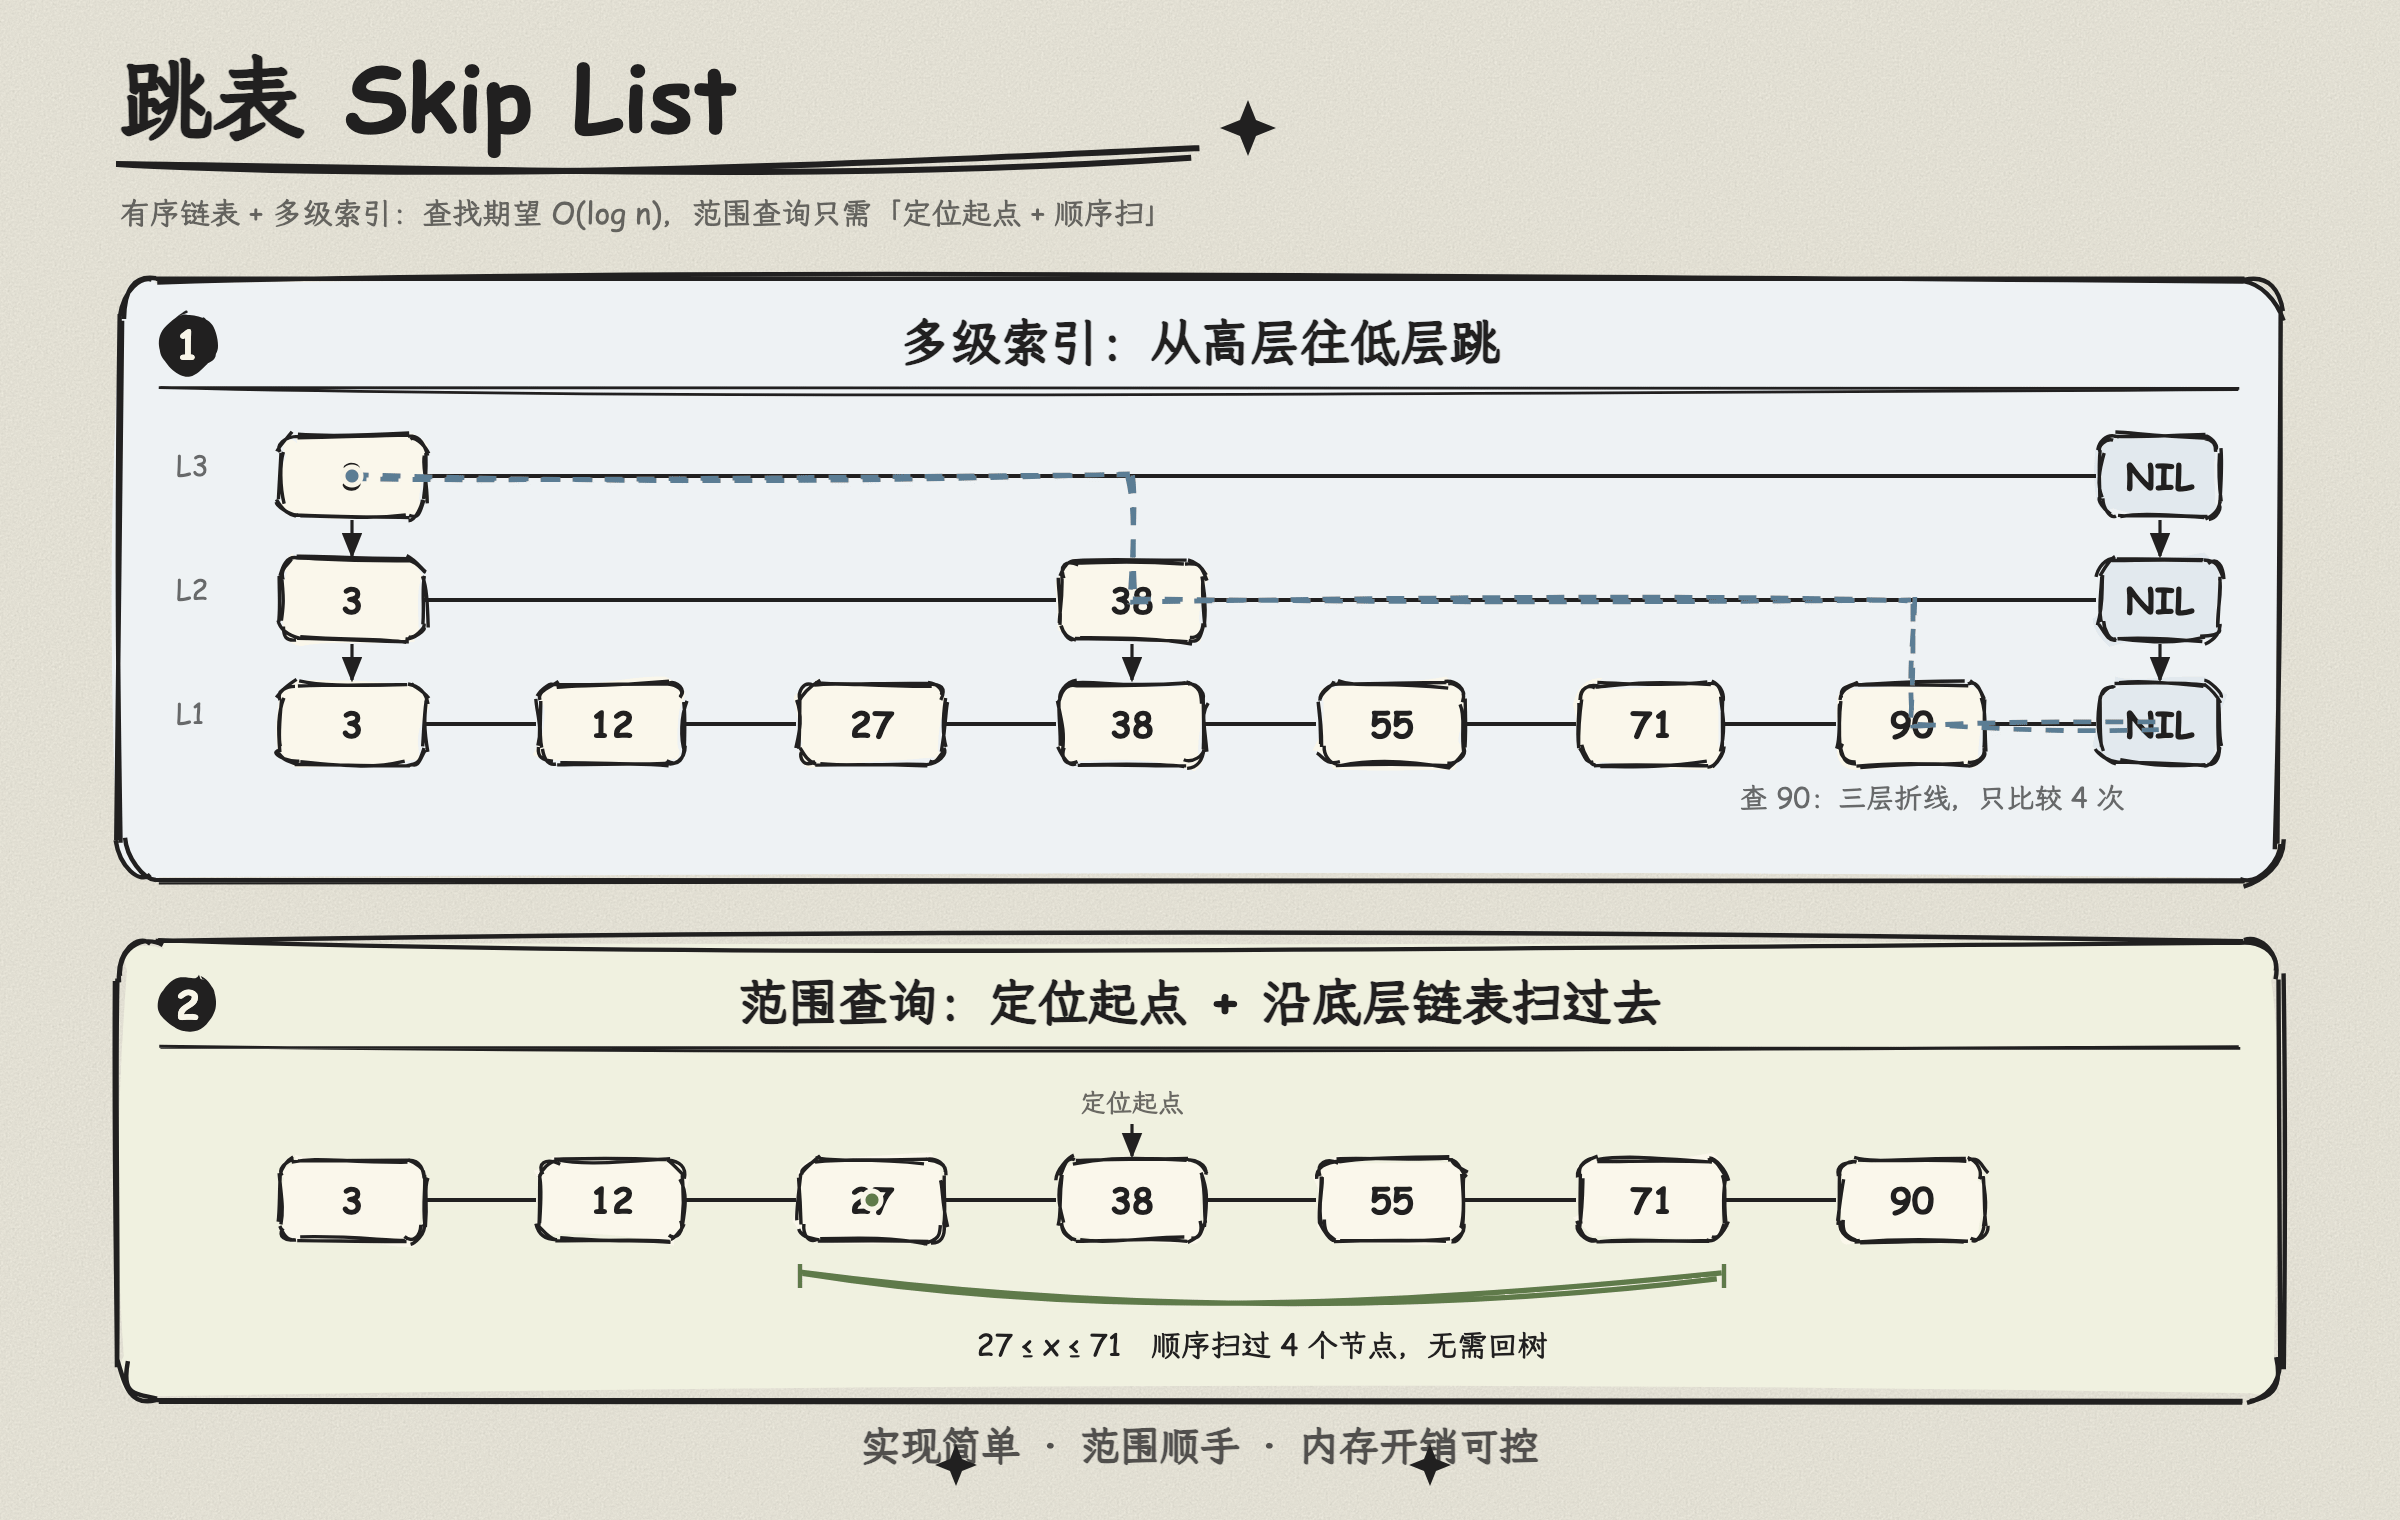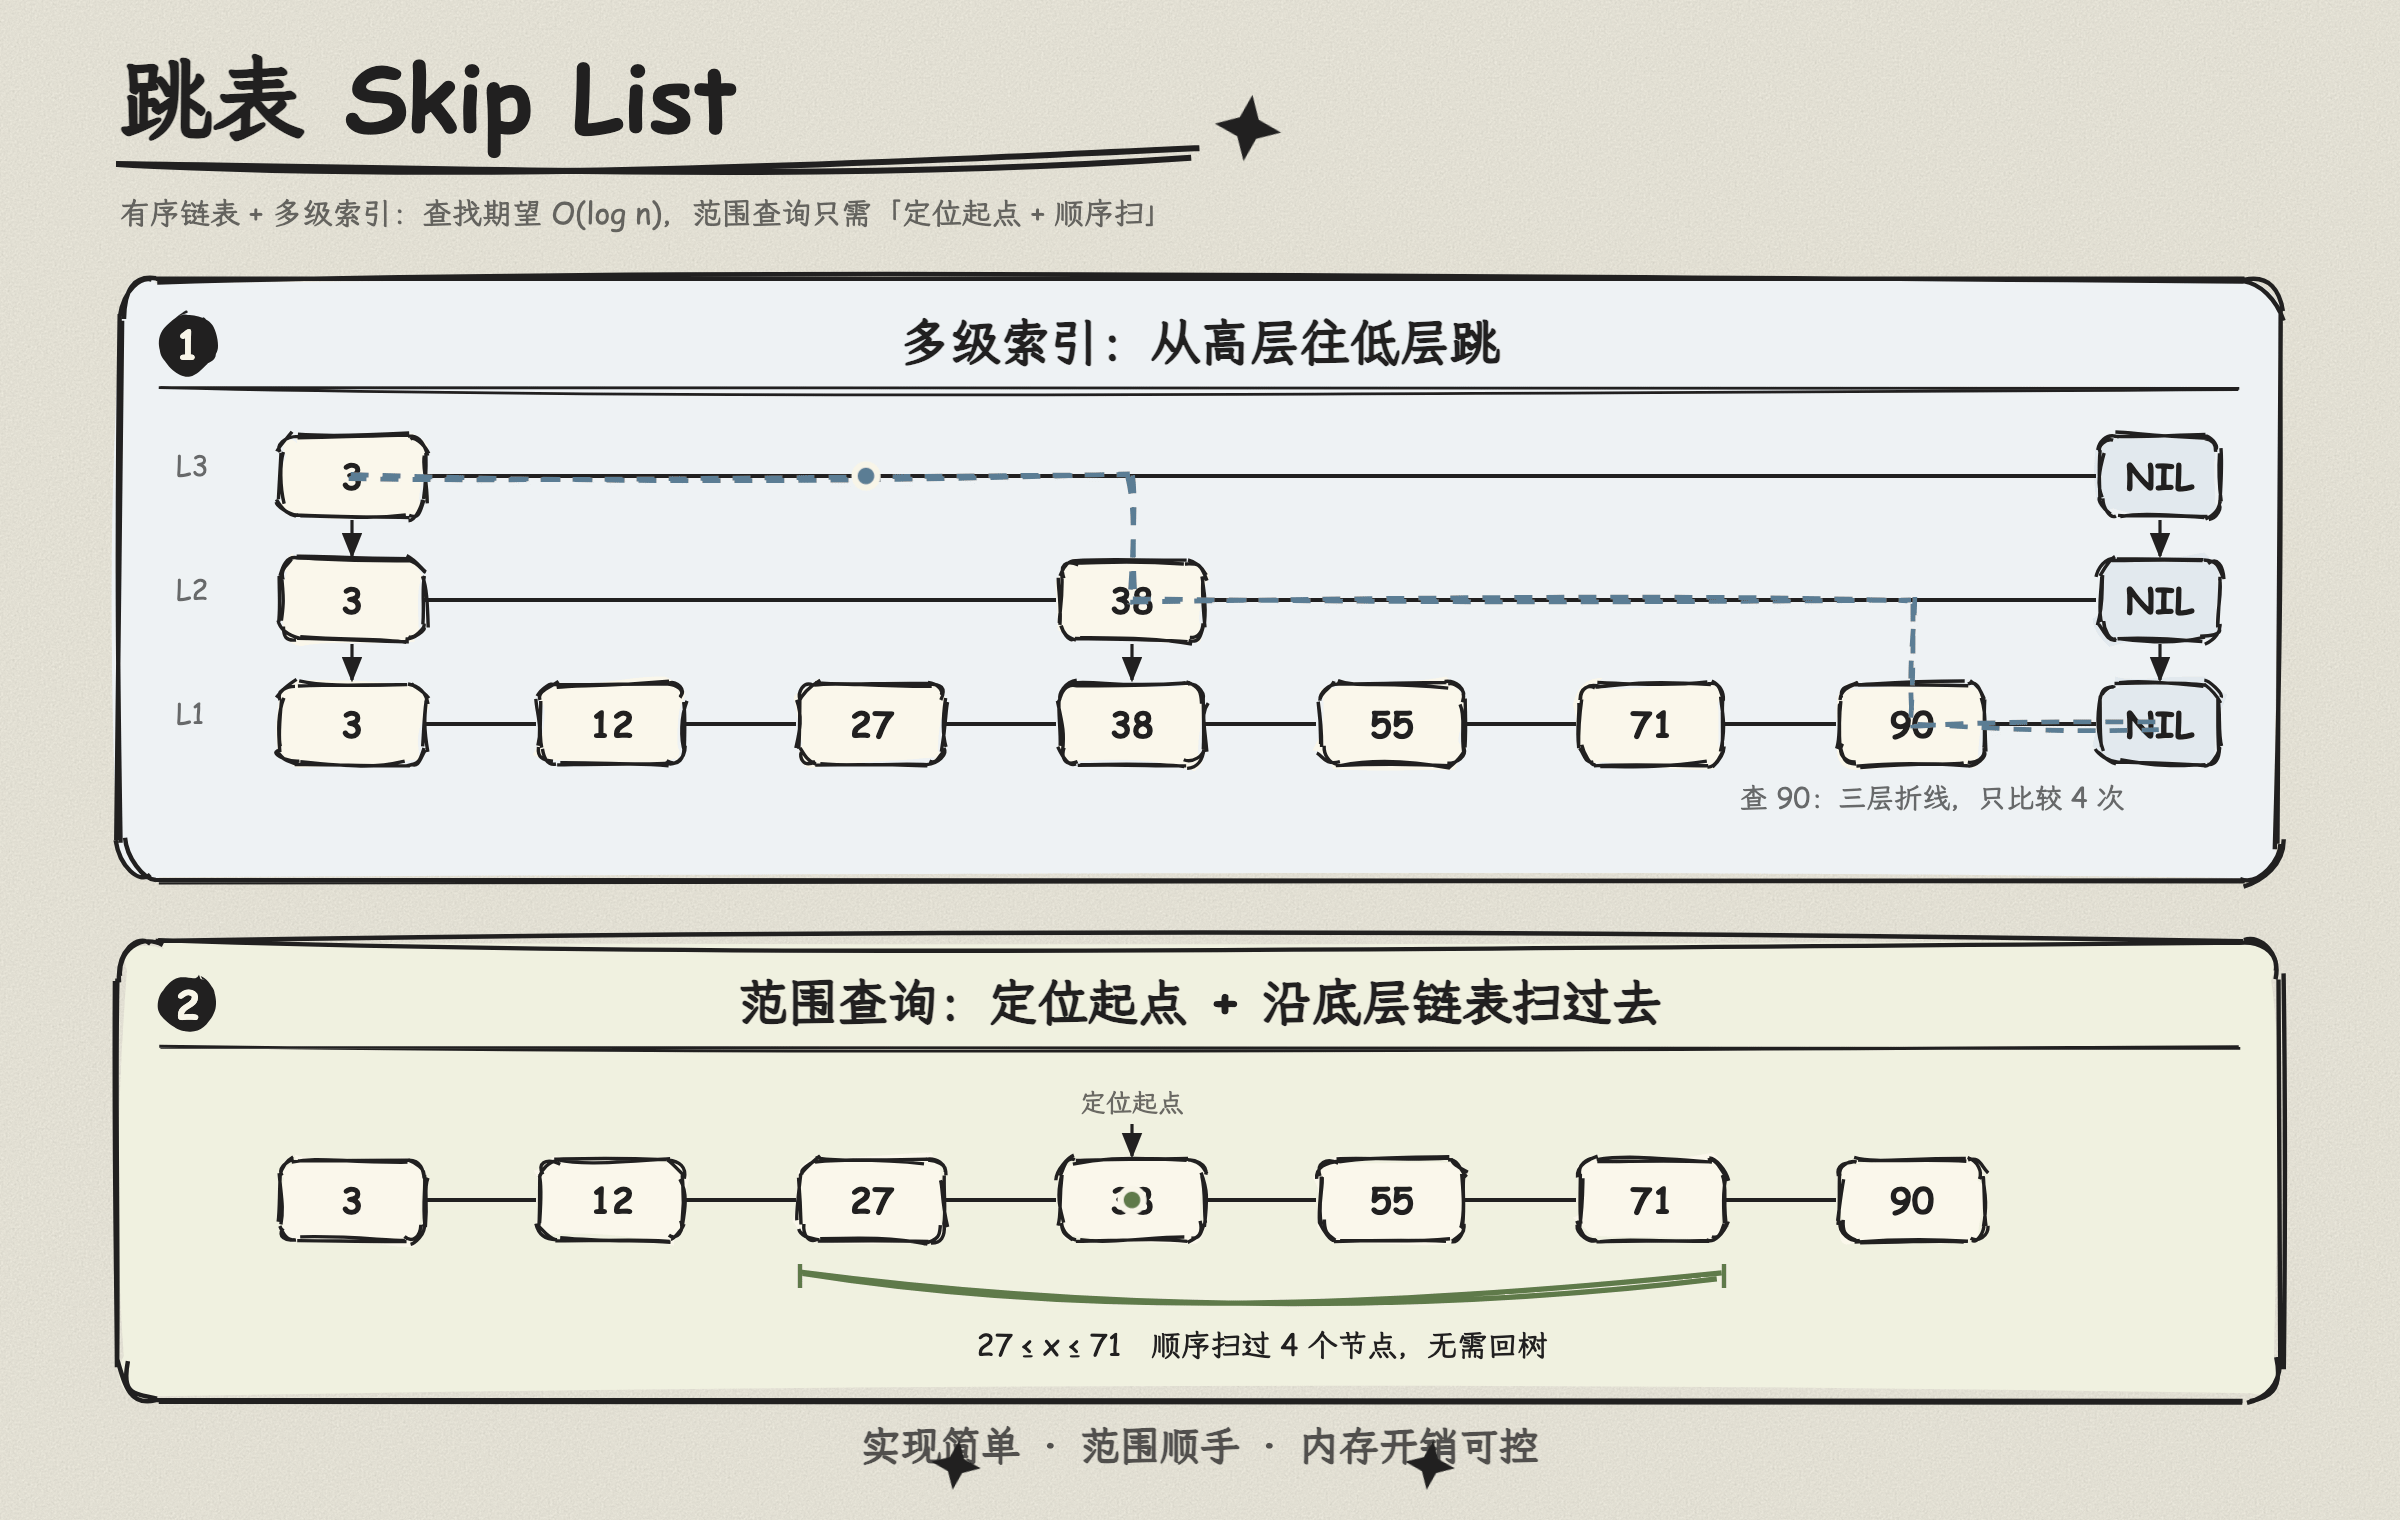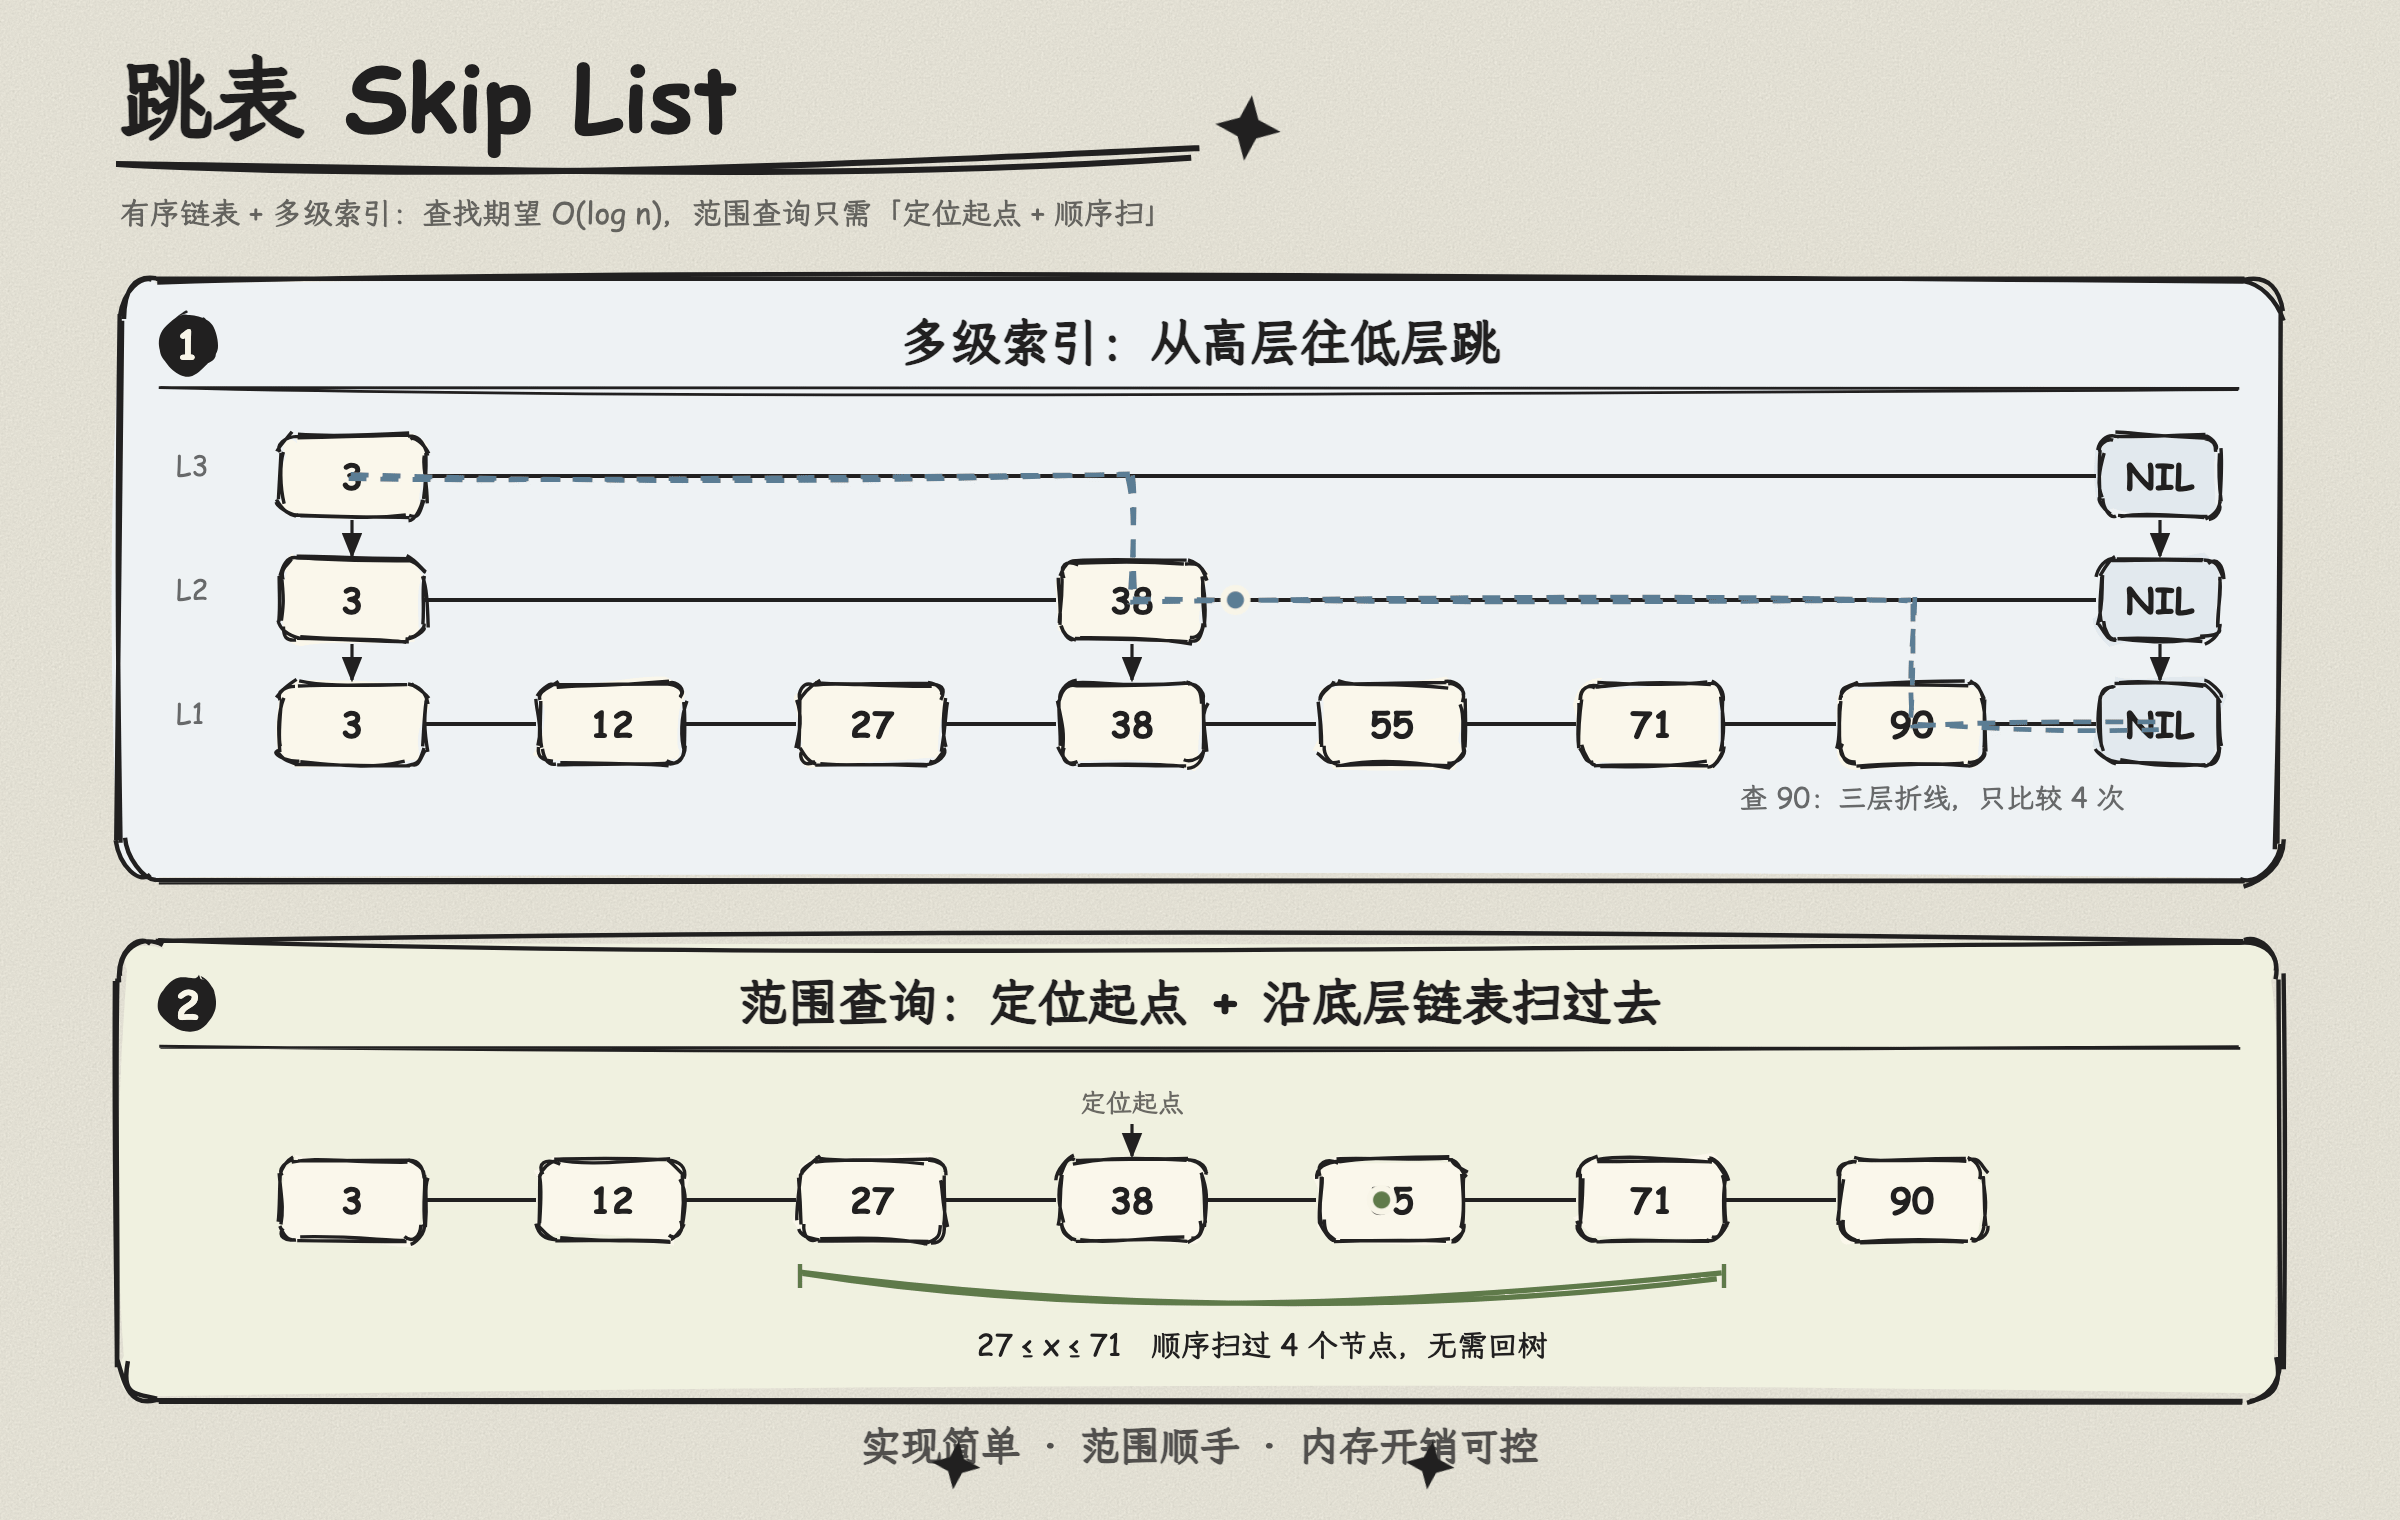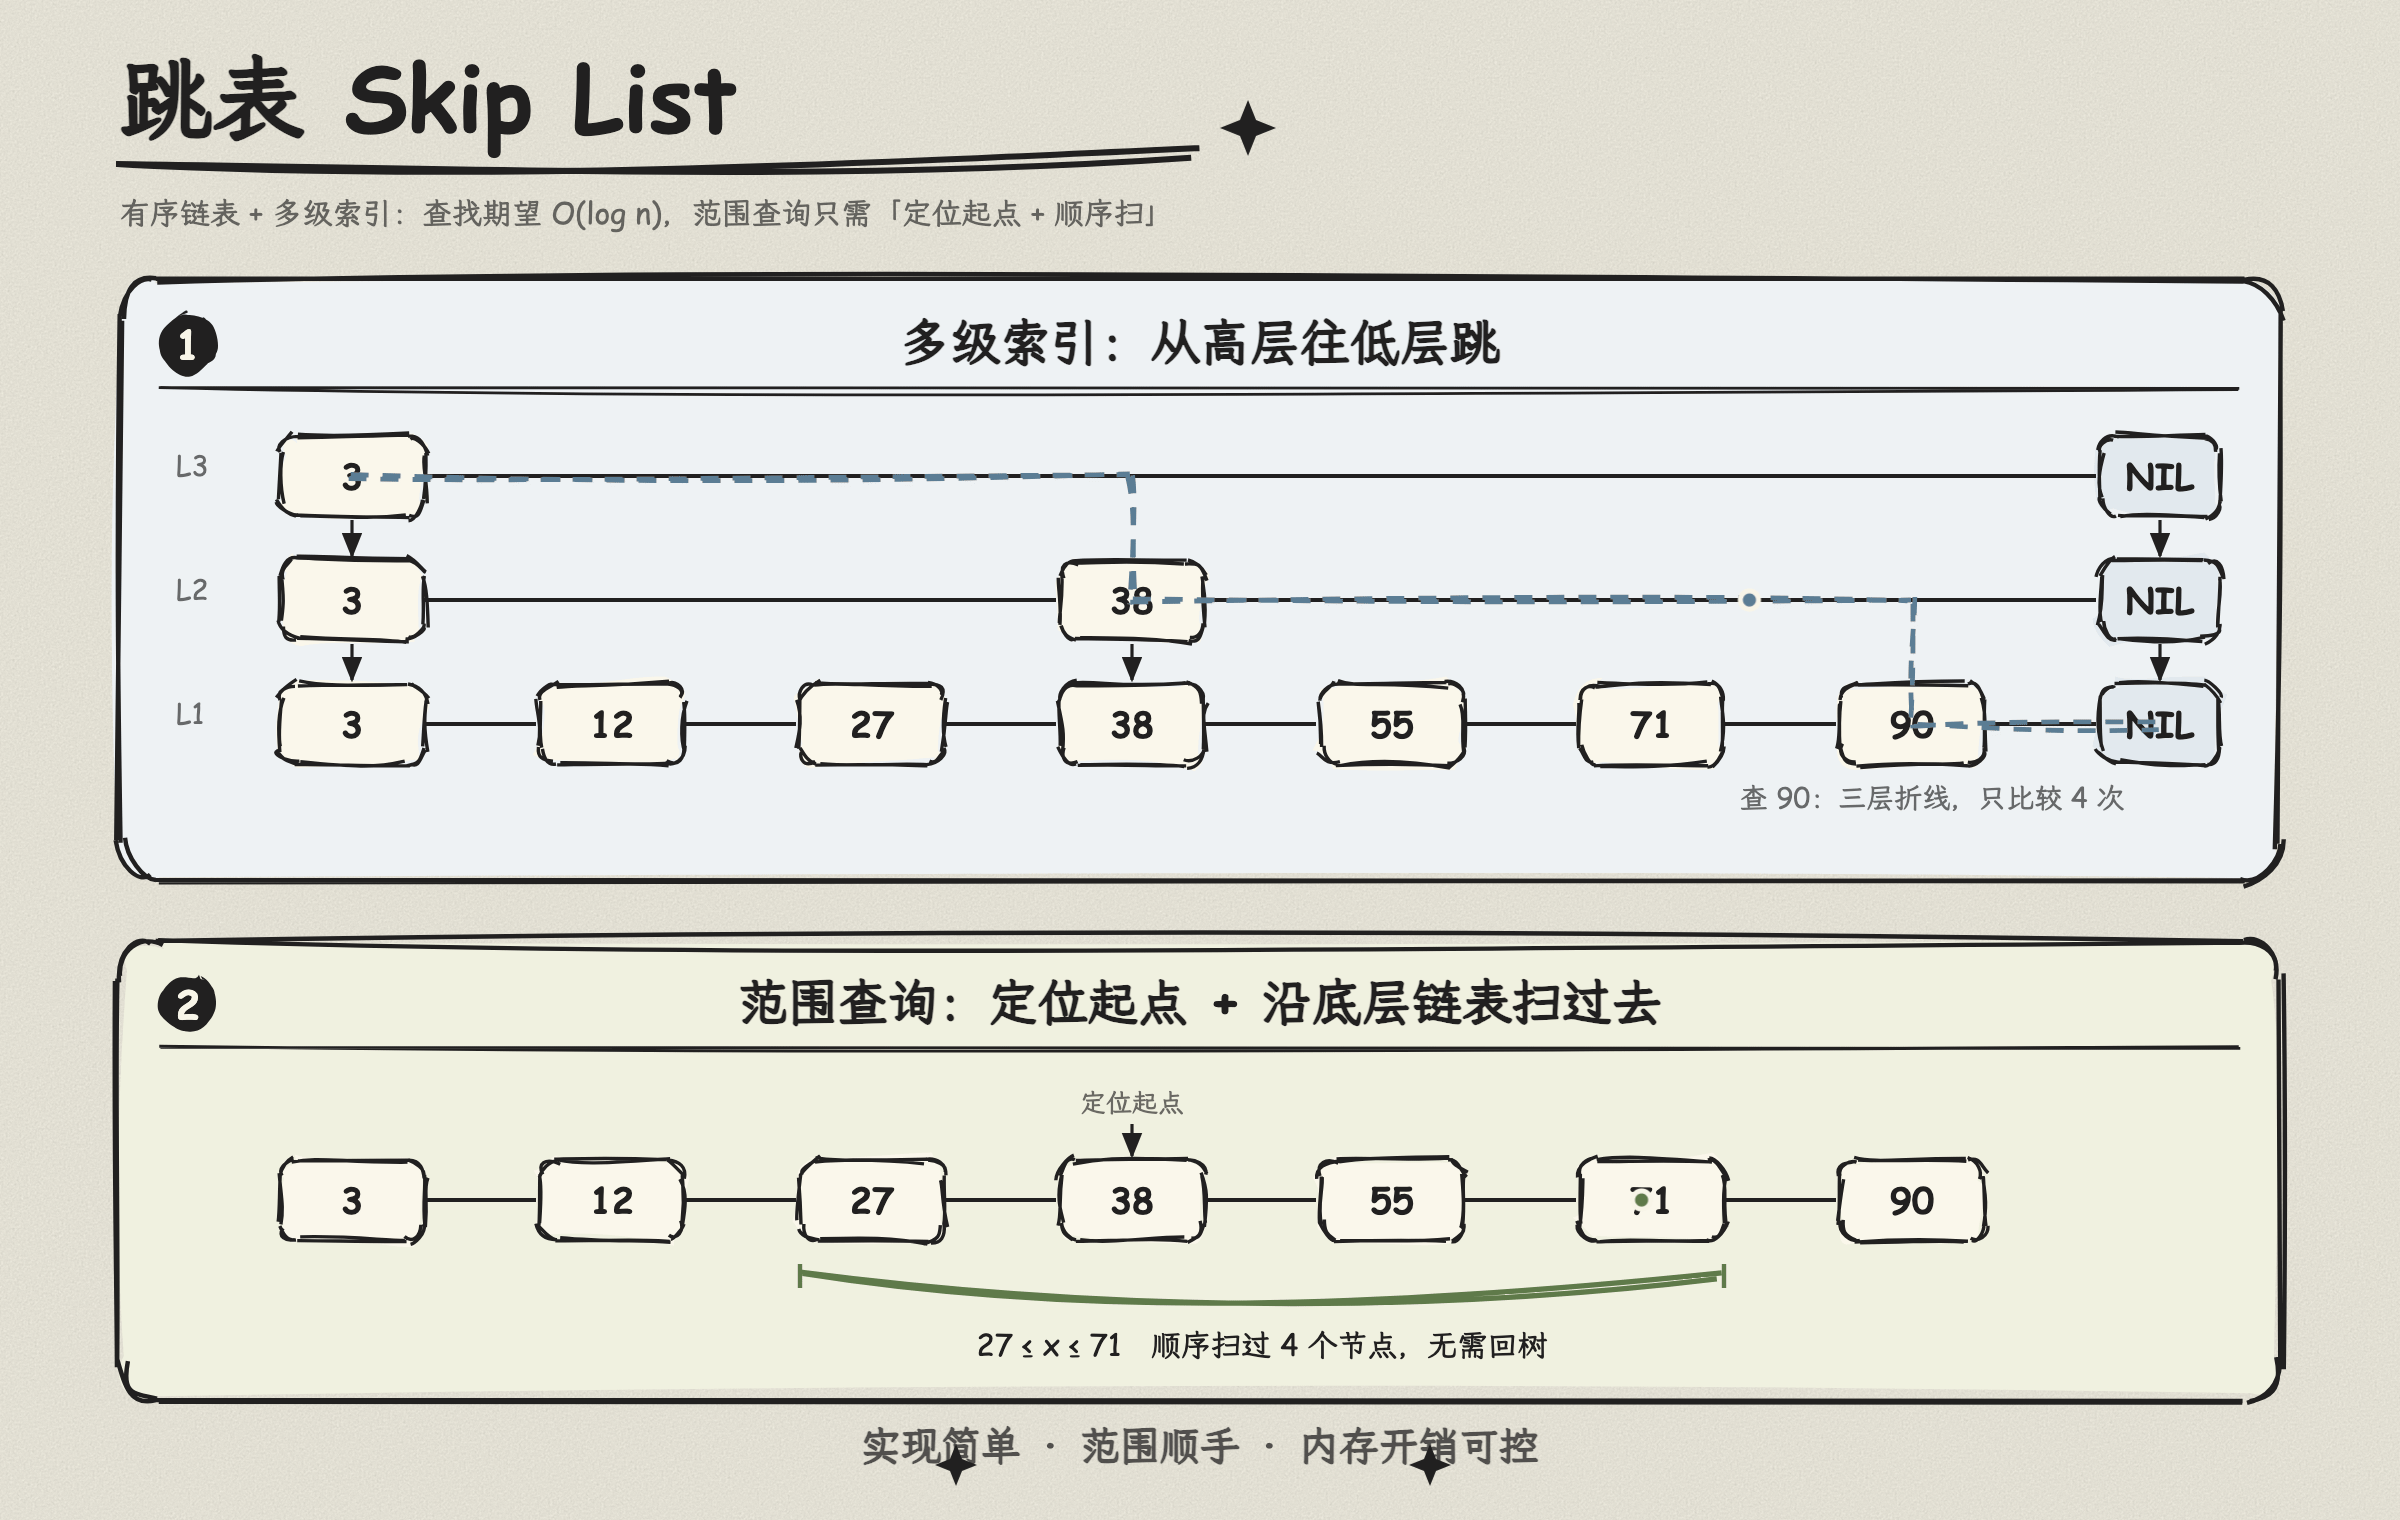
跳表解决的是哈希表解决不了的问题:在保持期望 O(log n) 查找的同时,支持范围查询和有序遍历。

它的结构是在有序链表上建多级索引,查找时从高层往低层跳,最终落到目标区间,然后沿底层链表顺序扫过去。范围查询的代价是“定位起点 + 顺序遍历”,非常自然。

图 1:跳表的两件事。上半部分是一条三层索引链,查找 90 时从 L3 一路往右下跳,折线只比较 4 次就命中;下半部分是范围查询,先用索引定位到区间起点,再沿底层有序链表一路扫过去。

跳表真正的竞争力,不在理论复杂度,而在工程上的“刚刚好”:

  • 实现比平衡树简单得多。红黑树插入删除要旋转、变色,跳表只改指针加概率建层;范围查询上,跳表沿底层链表直接扫,平衡树要走中序遍历(递归或显式栈)。对于需要自己实现或维护数据结构的系统来说,这是一个被低估的优势。
  • 局部修改、读路径易无锁化。这在 ConcurrentSkipListMap 这类并发容器里是实打实的优势。不过要注意,Redis ZSet 和 LevelDB MemTable 选跳表的主因并不是并发——Redis 命令执行本身是单线程,LevelDB 的写入也由 mutex 保护——而是实现简单 + 范围遍历顺手 + 内存开销可控。
  • 内存场景下 B+ 树的优势用不上。B+ 树为磁盘 I/O 做的所有优化(大扇出、页对齐、减少树高)在内存里都失去了意义。内存里一次指针跳转和一次数组访问的差距,远小于磁盘寻道和顺序读的差距。

Redis 的 ZSet 选跳表而不是 B+ 树或红黑树,逻辑就在这里:数据在内存,需要按 score 排序和范围取,跳表实现简单、范围查询顺手、内存开销可控。

一句话:内存 + 有序 + 范围查询,跳表是那个“没有明显短板”的选择。


三、B+ 树:为磁盘 I/O 而生,但有前提

B+ 树的所有设计,都指向同一个目标:把磁盘 I/O 次数压到最低。

它的关键特征:

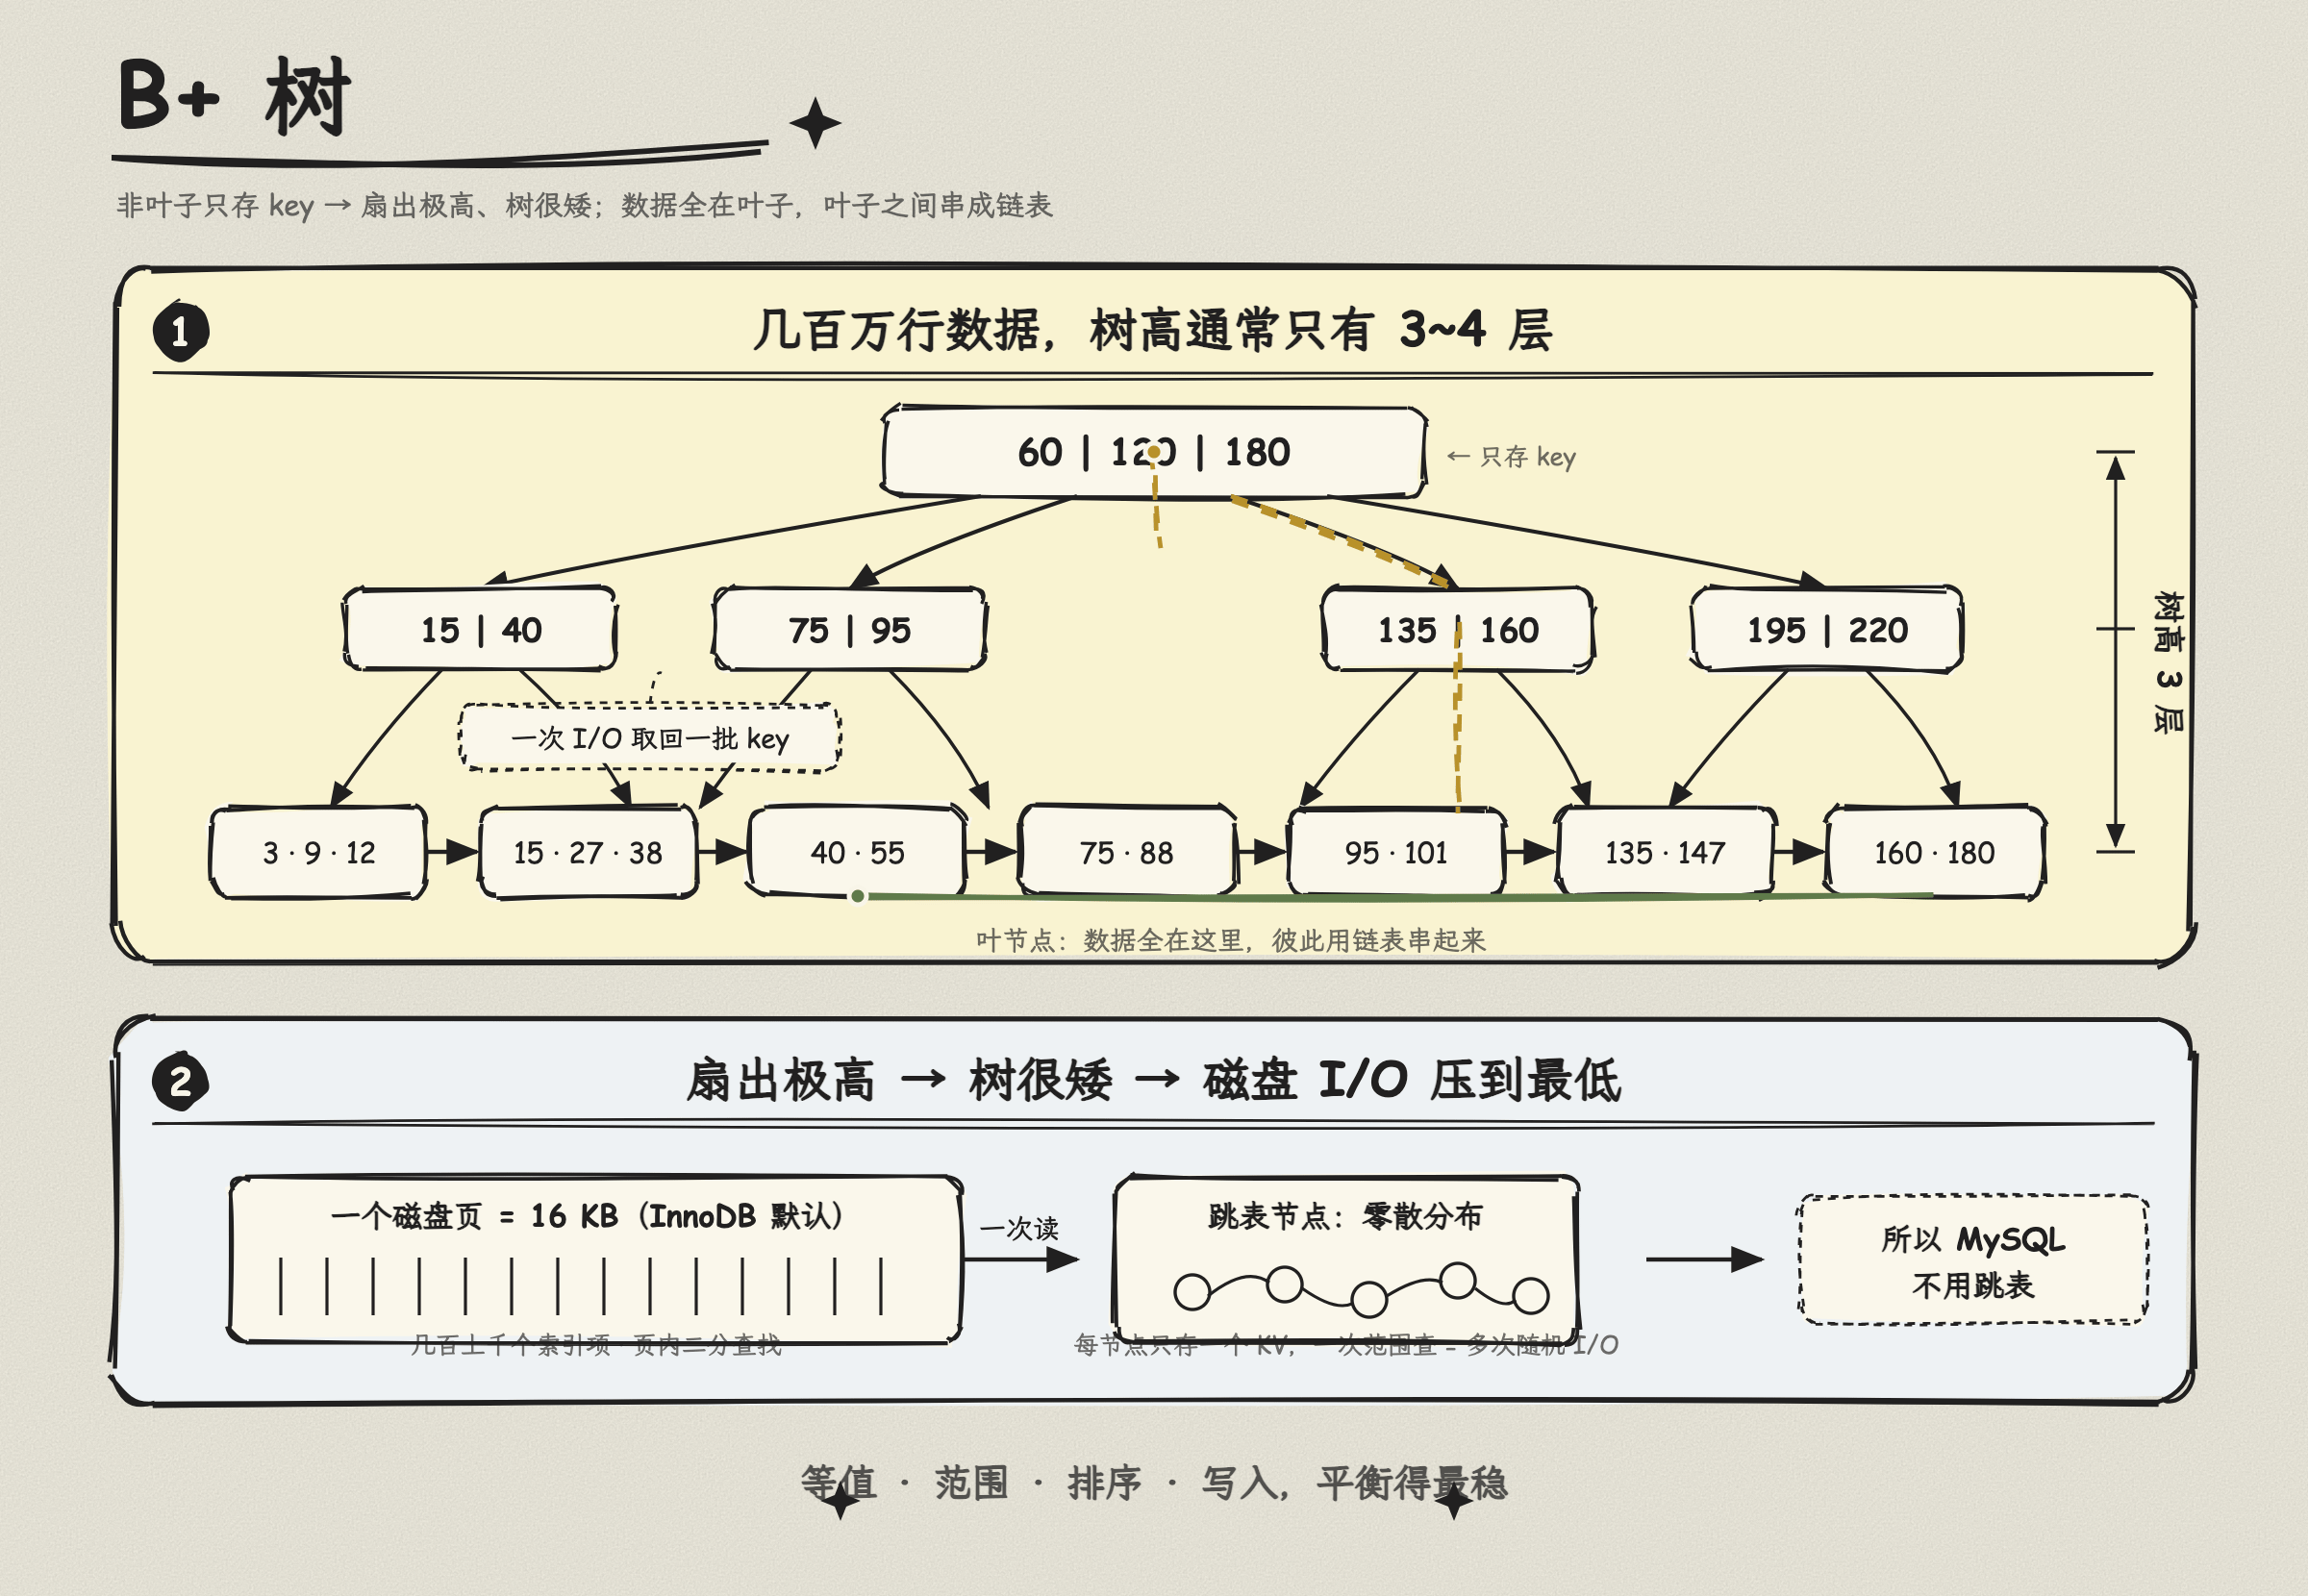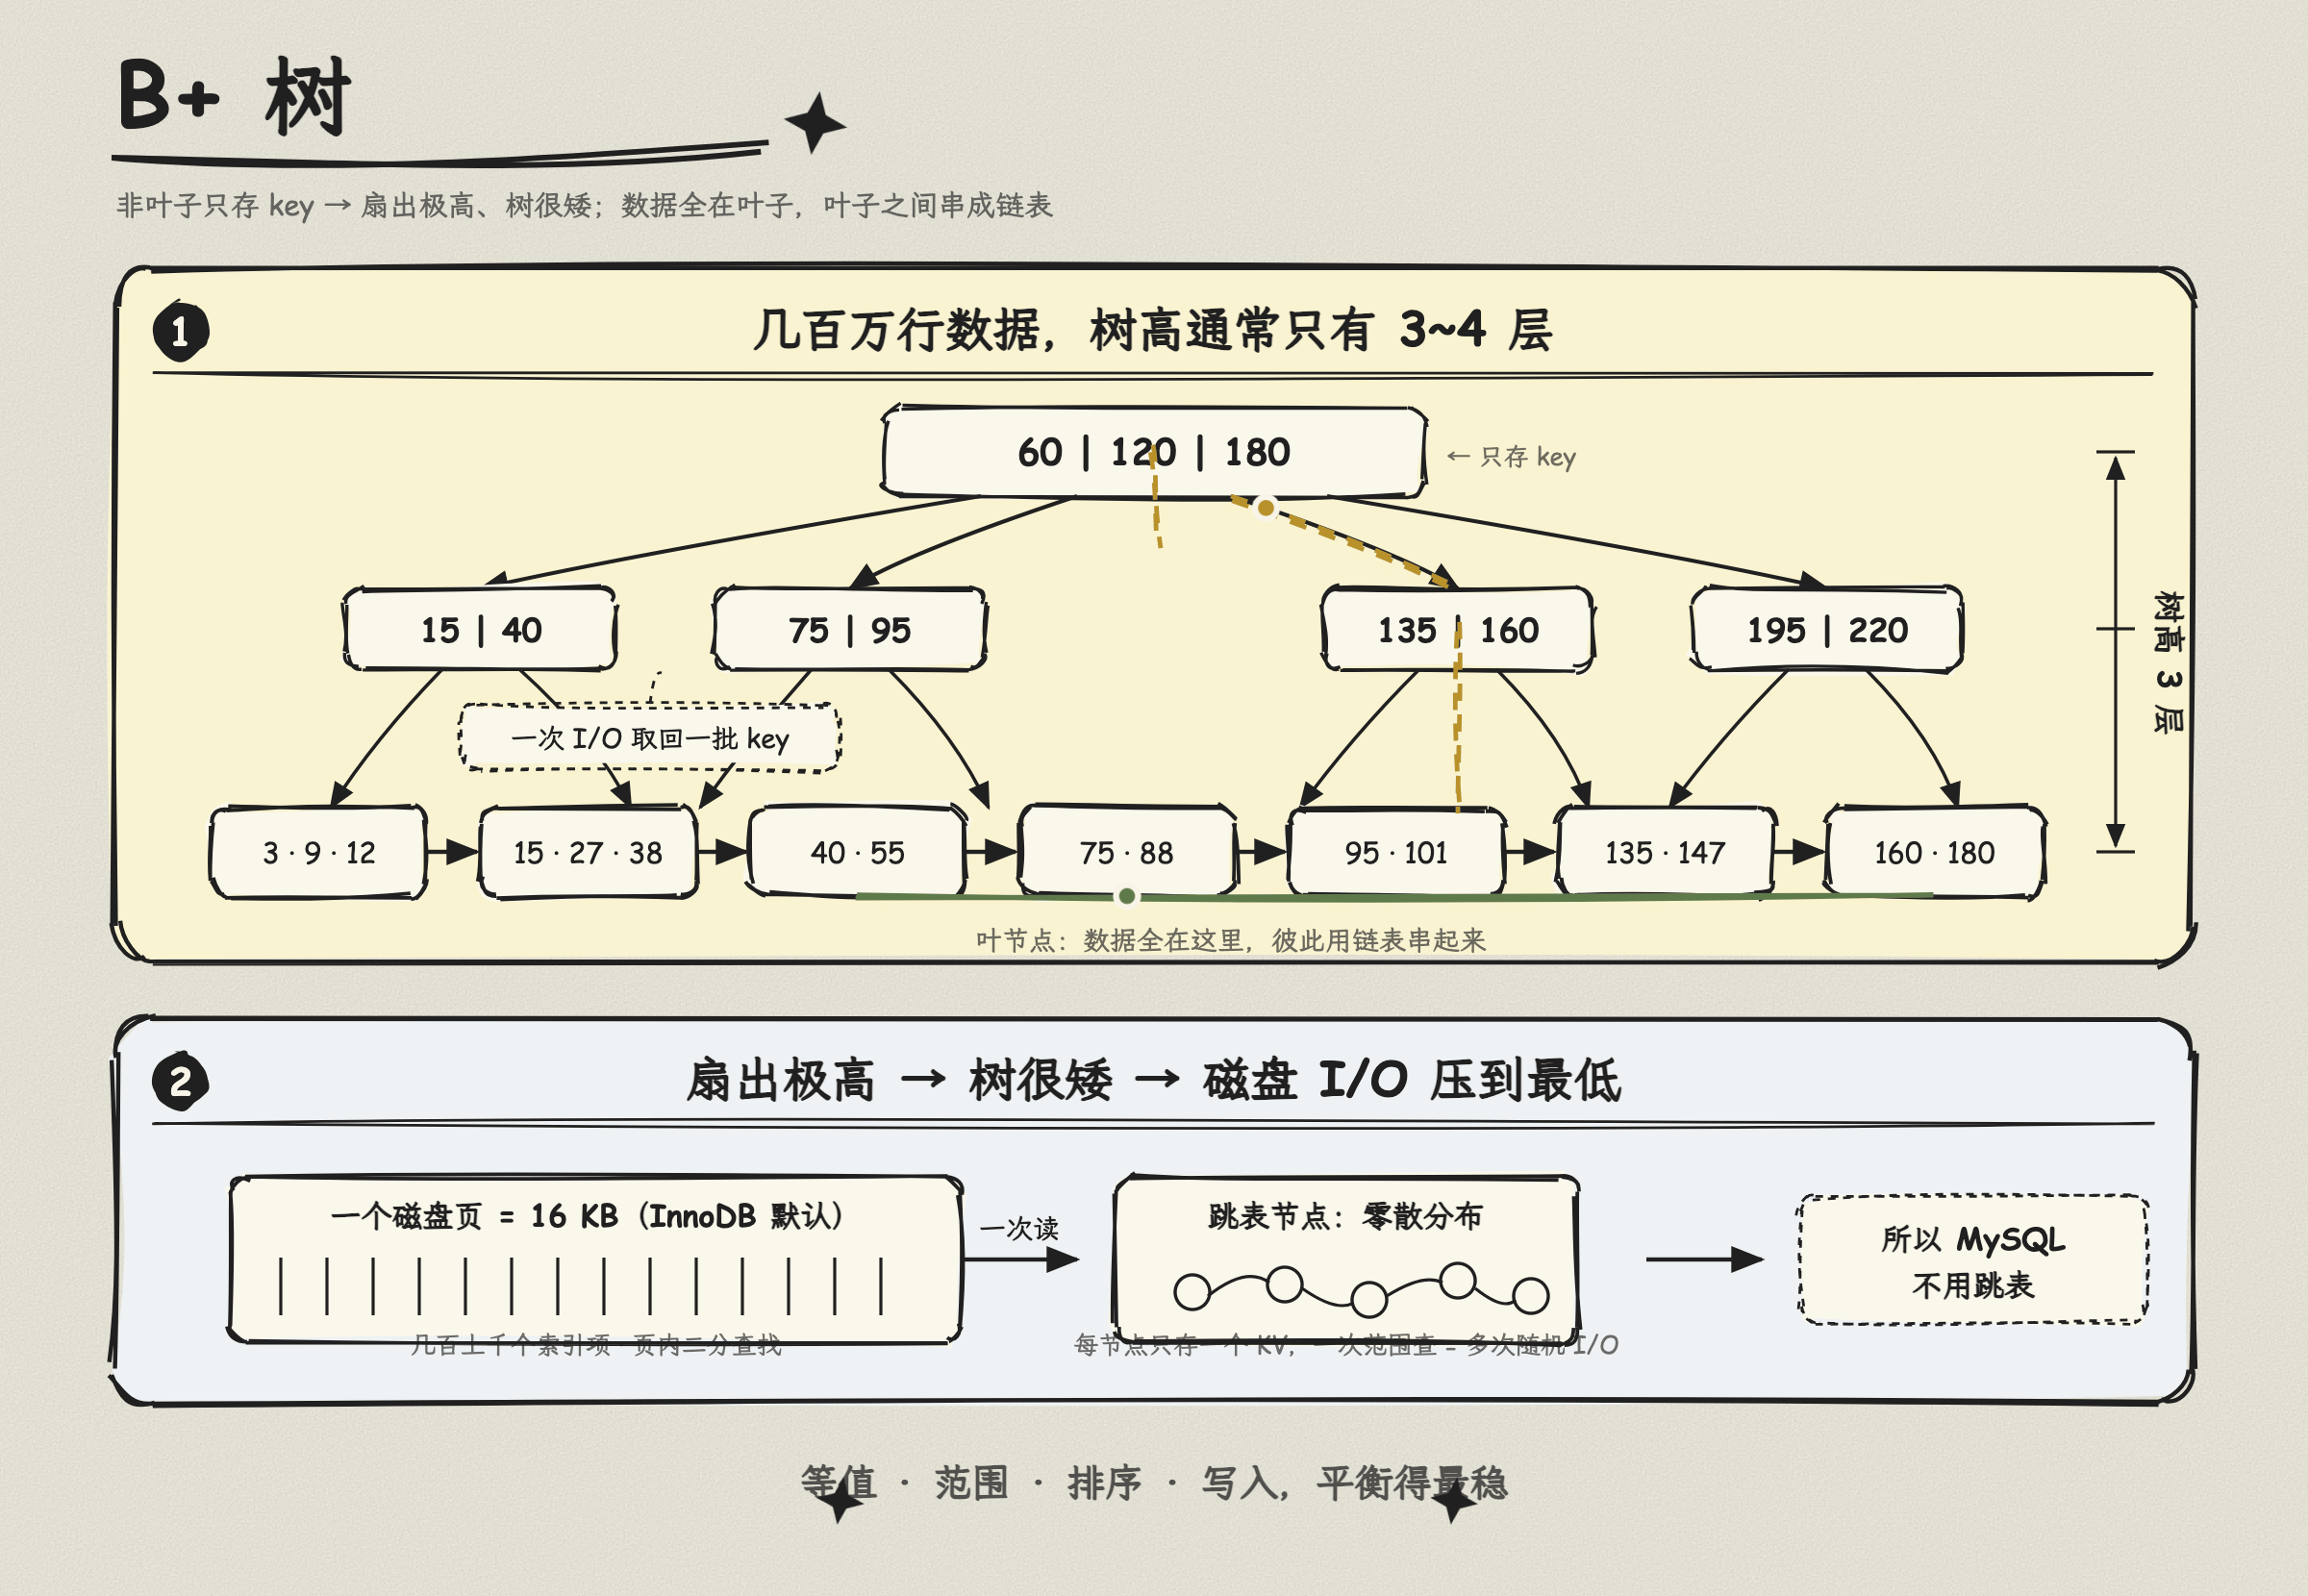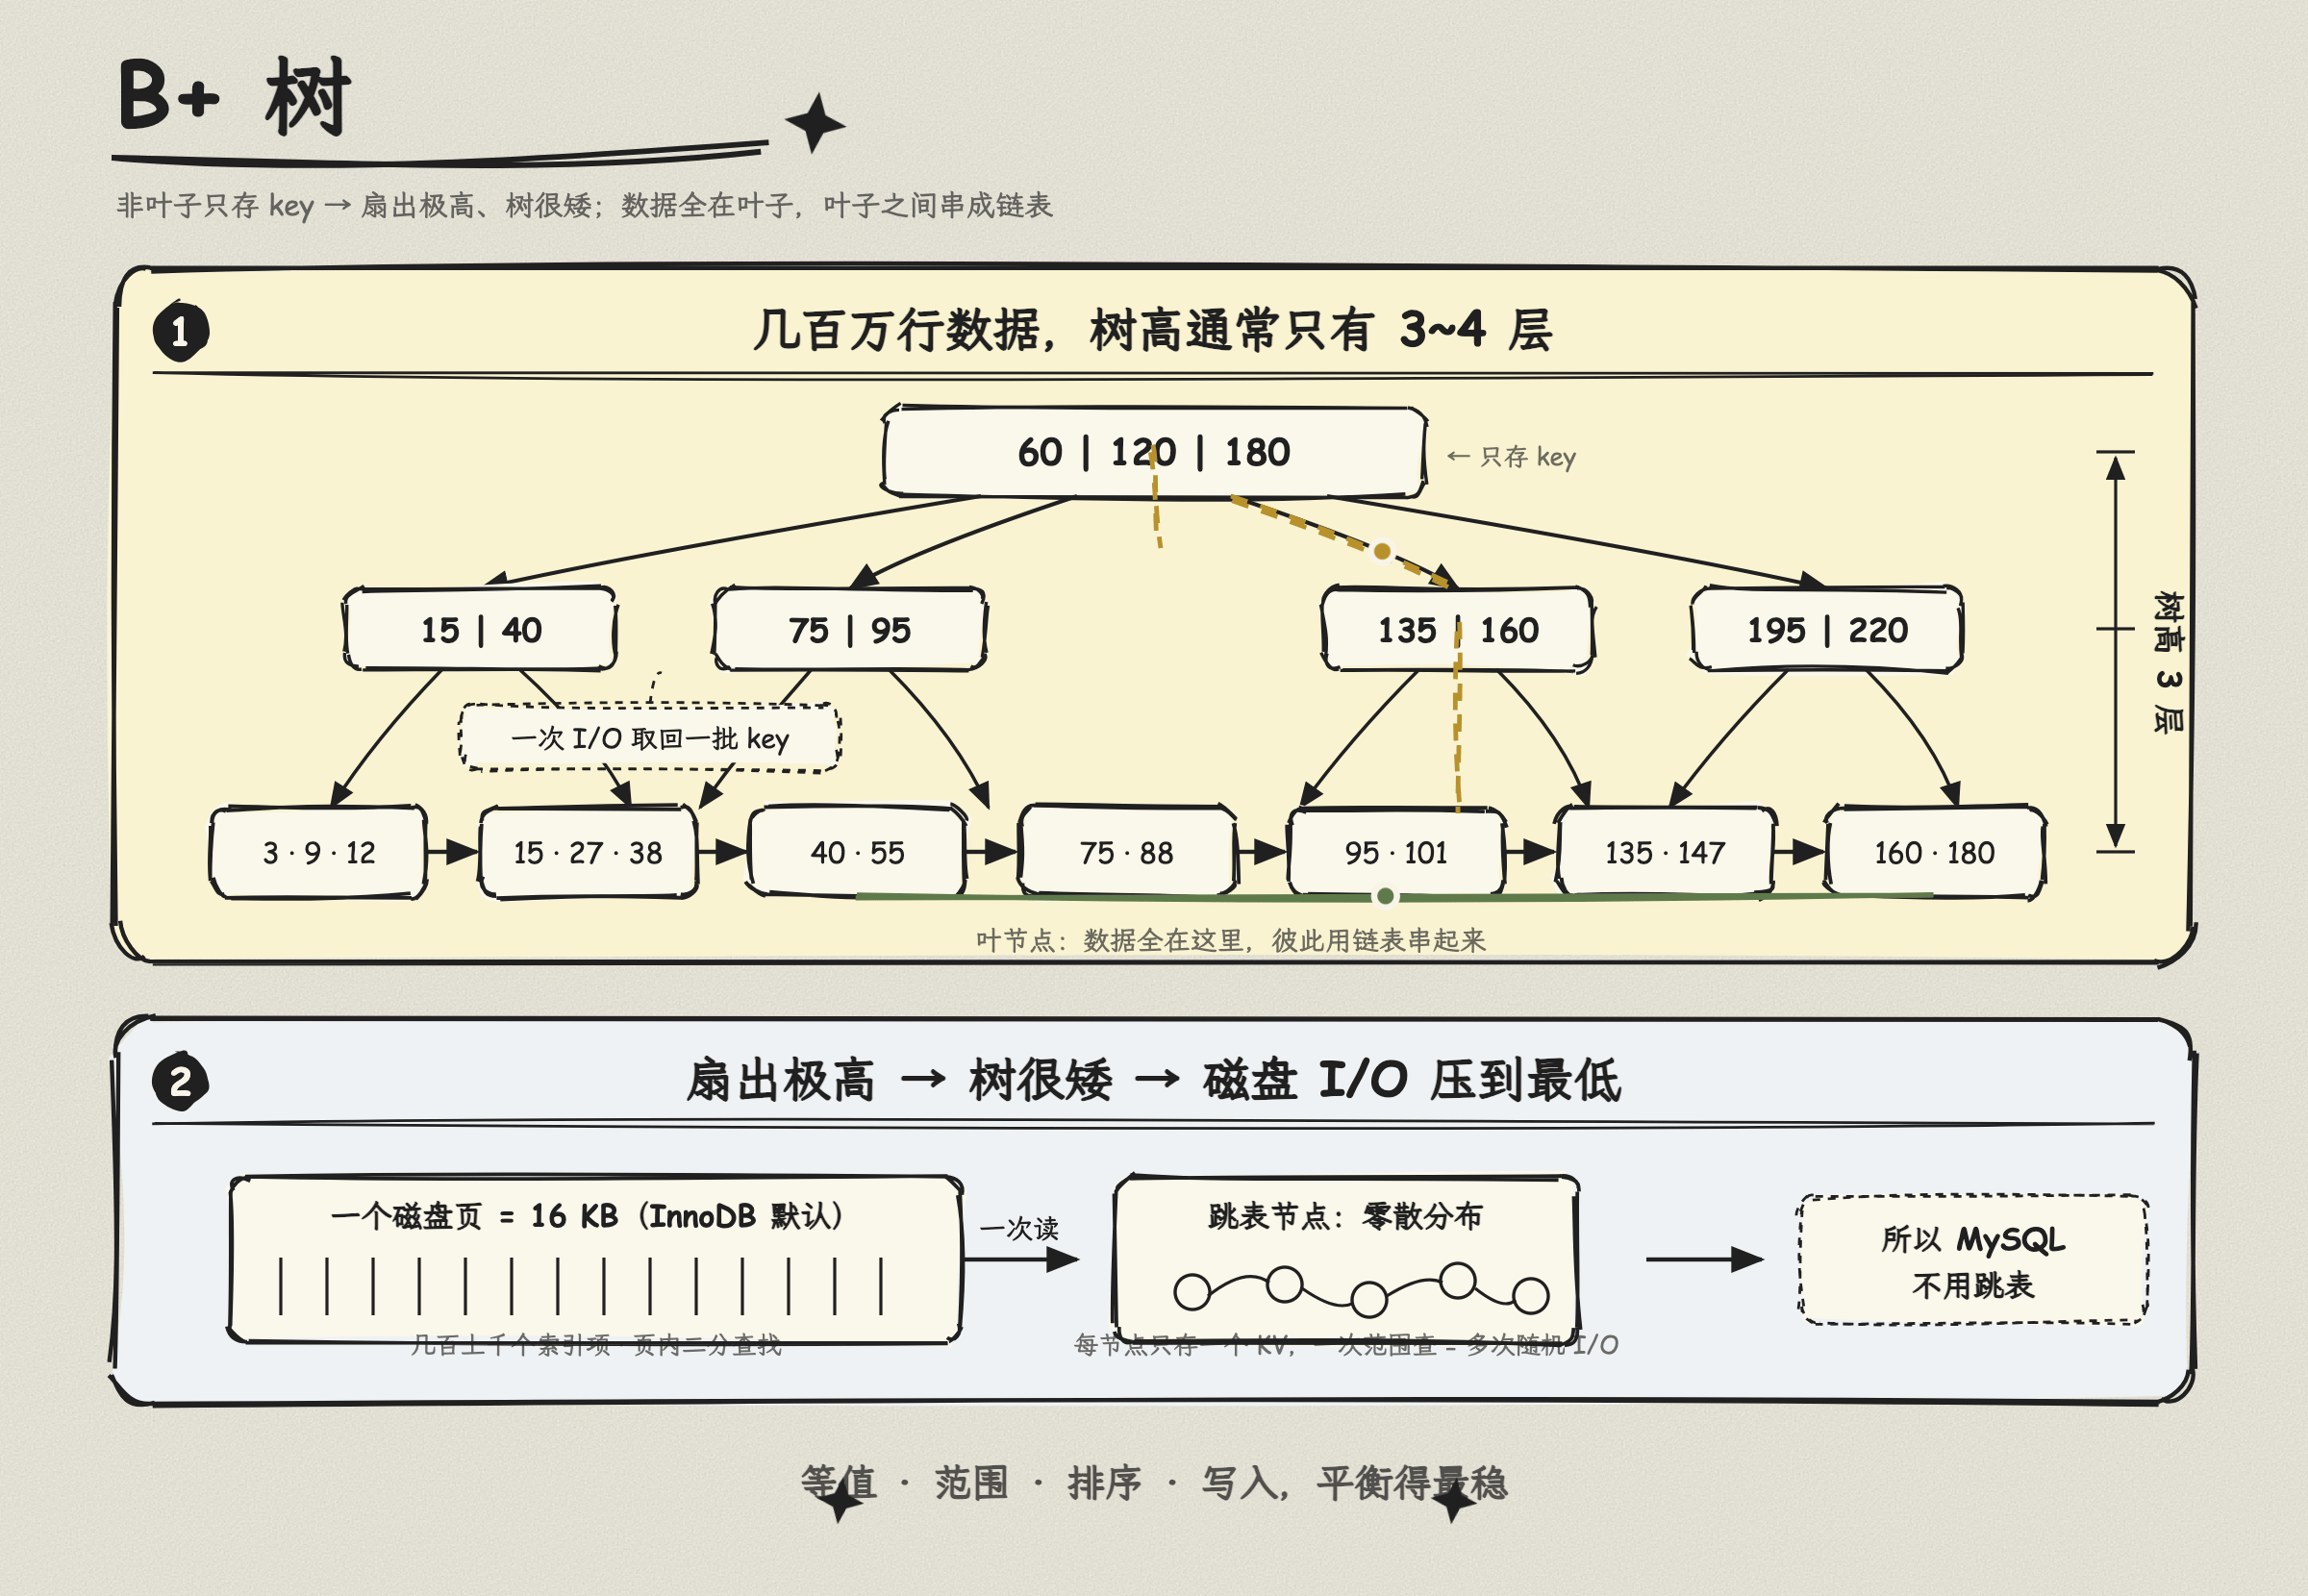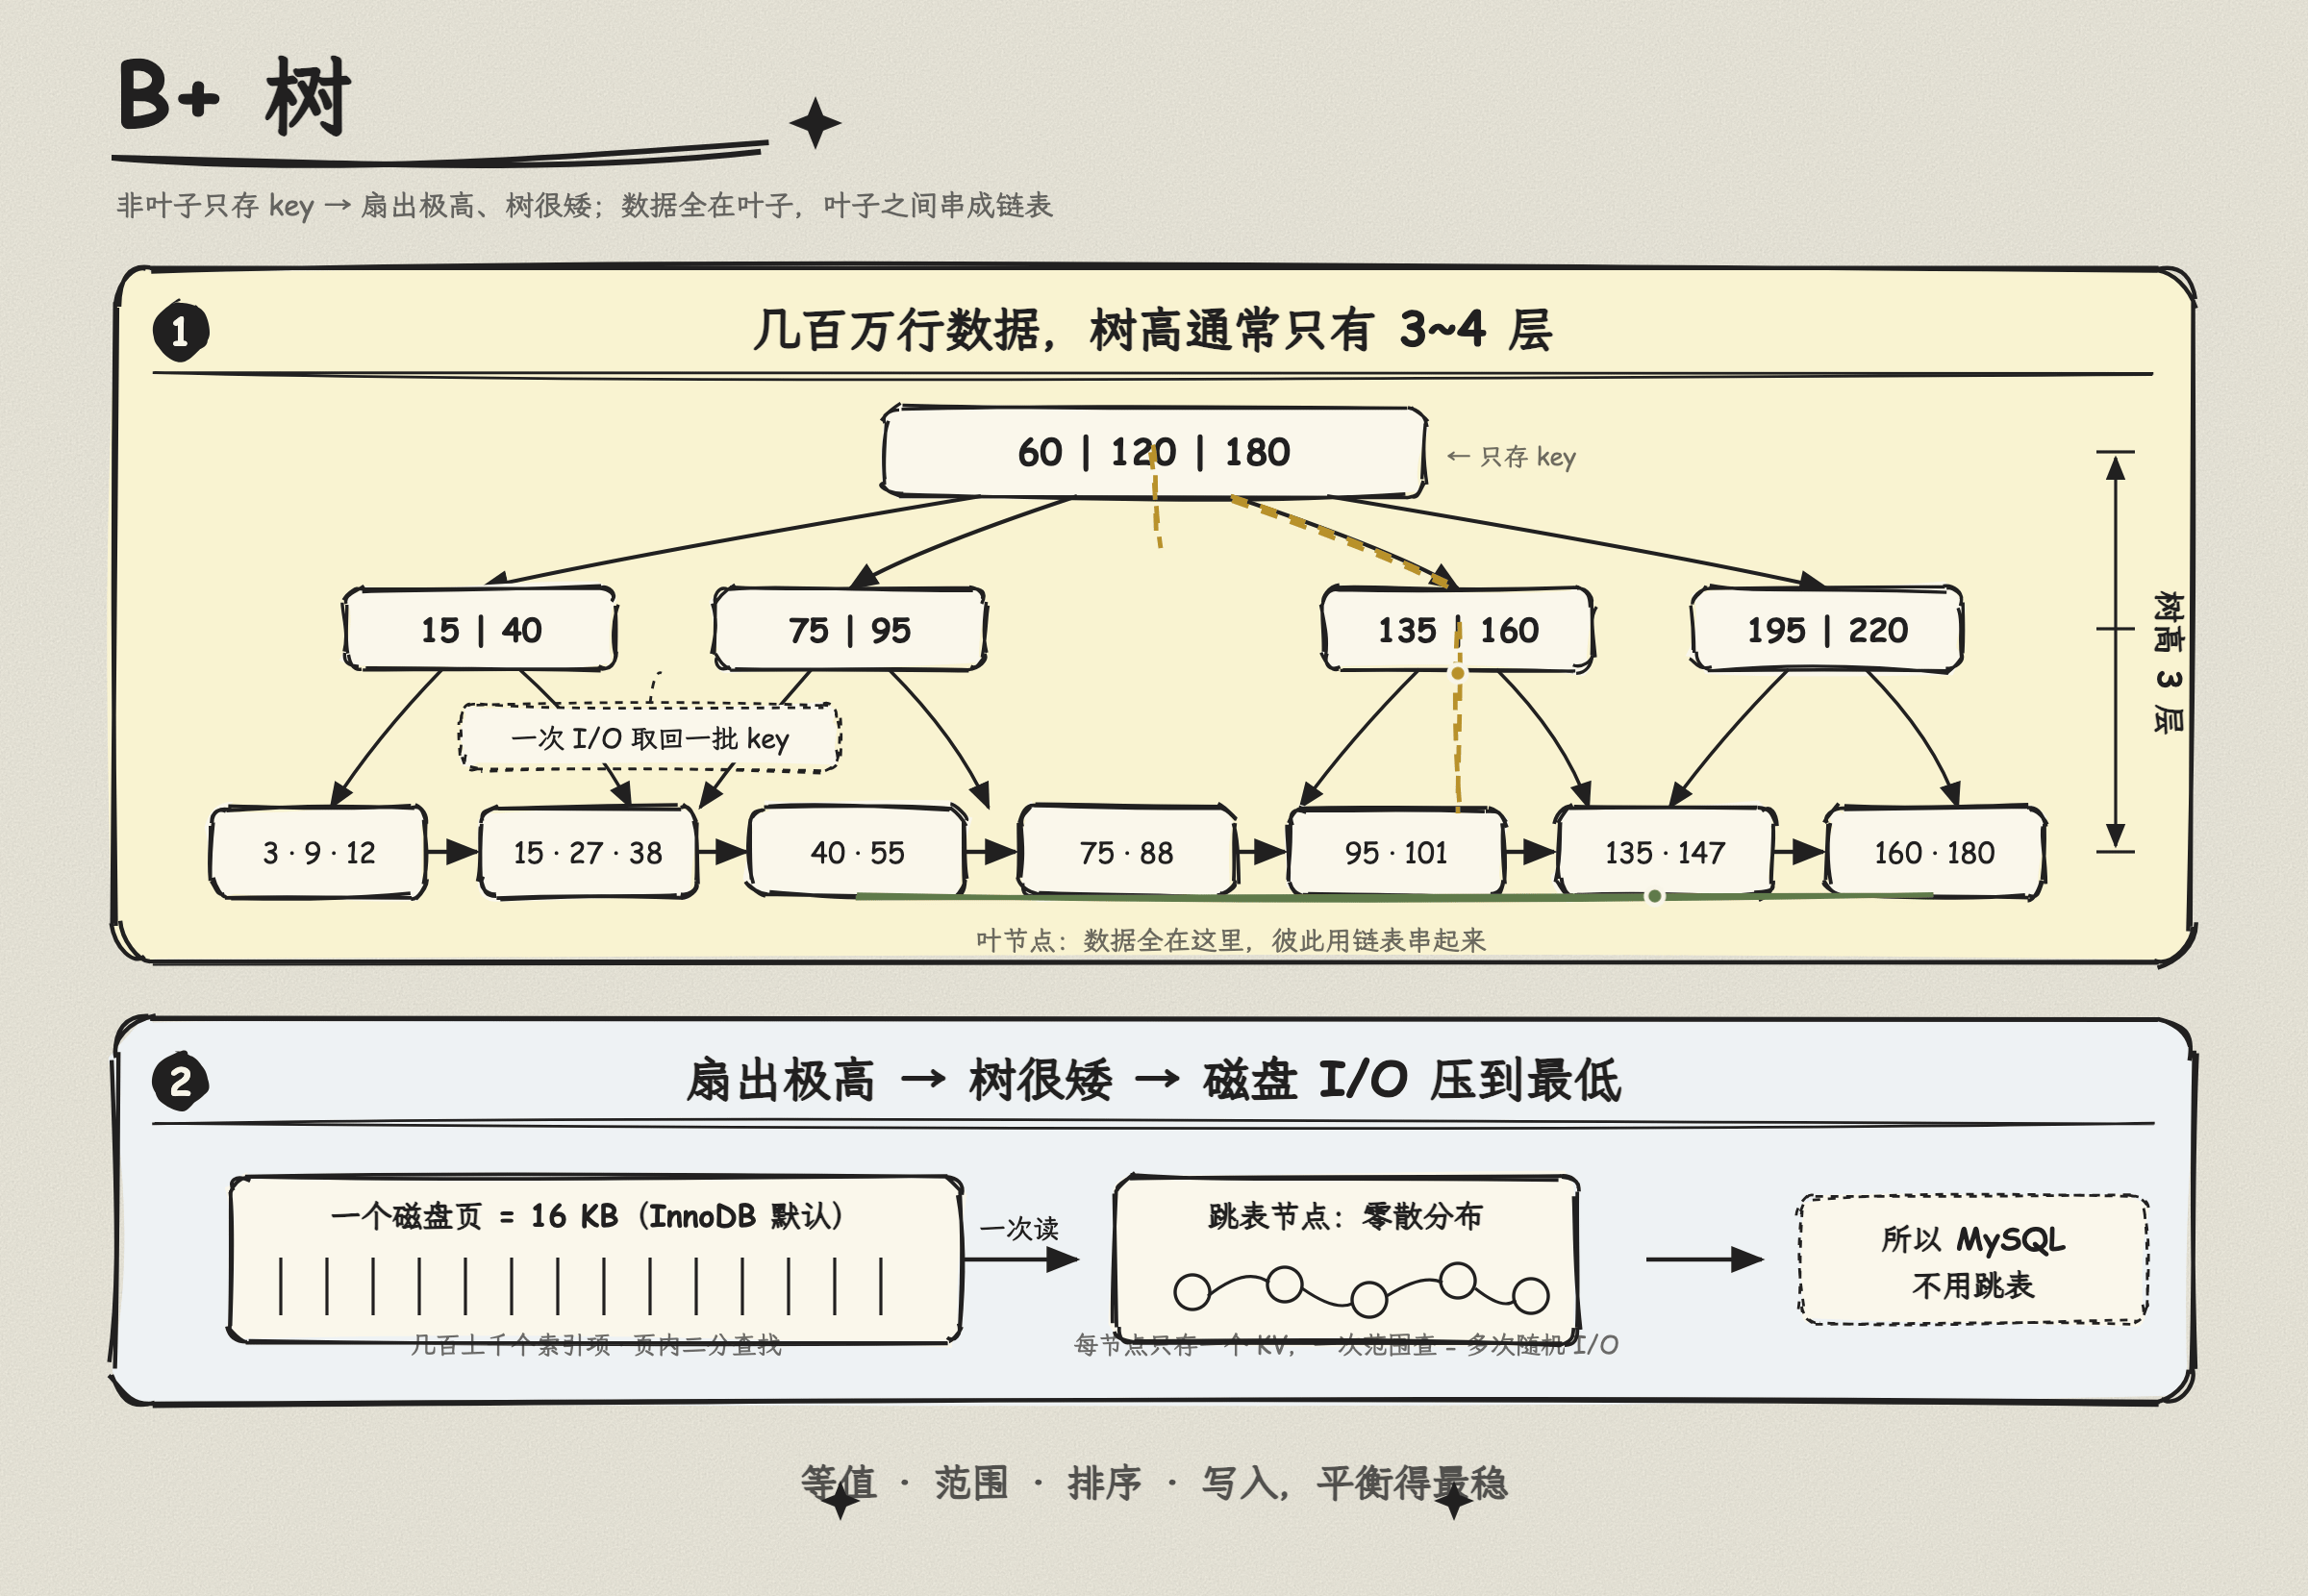
  1. 非叶子节点只存 key,不存数据。这让每个磁盘页(InnoDB 默认 16KB)能塞下几百上千个索引项,扇出极高,树很矮。几百万行数据,树高通常只有 3~4 层。
  2. 数据全在叶子节点,叶子之间用链表串起来。范围查询和全表扫描变成沿着叶子链表顺序读,磁盘顺序读的性能远高于随机读。
  3. 节点大小对齐磁盘页。每次读一个节点就是读一个页,不浪费,也不多读。

图 2:B+ 树为什么磁盘友好。非叶子节点只存 key,所以一个 16KB 的页能塞下几百上千个索引项,扇出极高、树只有三层。数据全部落在叶子层,叶子之间用链表串起来——等值查询沿左侧虚线走「根 → 内部节点 → 叶子」,范围查询则沿底部绿色箭头在叶子链表上顺序扫。右下角对比了跳表:节点零散分布、每节点只存一个 KV,放到磁盘上一次范围查询就是多次随机 I/O。

关于 I/O 次数还要补一句:B+ 树的根节点和上层节点通常常驻 buffer pool,实际查询的磁盘 I/O 往往只有 1 到 2 次,比“树高 3 到 4 层”更乐观——树高是上界,不是每次查询都要走满。

代价同样明确:随机写、页分裂、写放大。这正是 LSM-Tree 用“顺序写 + 后台合并”换“读放大”的动机——那是另一个话题,但说明 B+ 树不是没有代价的“最优解”,而是在读写之间平衡得最稳的默认选项。

为什么 MySQL 不用跳表?因为跳表是为内存设计的。它的节点零散分布,每个节点只存一个 KV,放到磁盘上,一次范围查询可能触发大量随机 I/O。B+ 树把多个 key 打包进一个页,一次 I/O 取回一批,这才是磁盘友好的做法。

一句话:B+ 树不是“最好的”,但它是在等值、范围、排序、写入之间平衡得最稳的那个——前提是瓶颈在机械寻道或页级读取代价,而这一点在 HDD 和 SSD 上并不完全相同。


四、磁盘要分 HDD 和 SSD:瓶颈变了,结论要微调

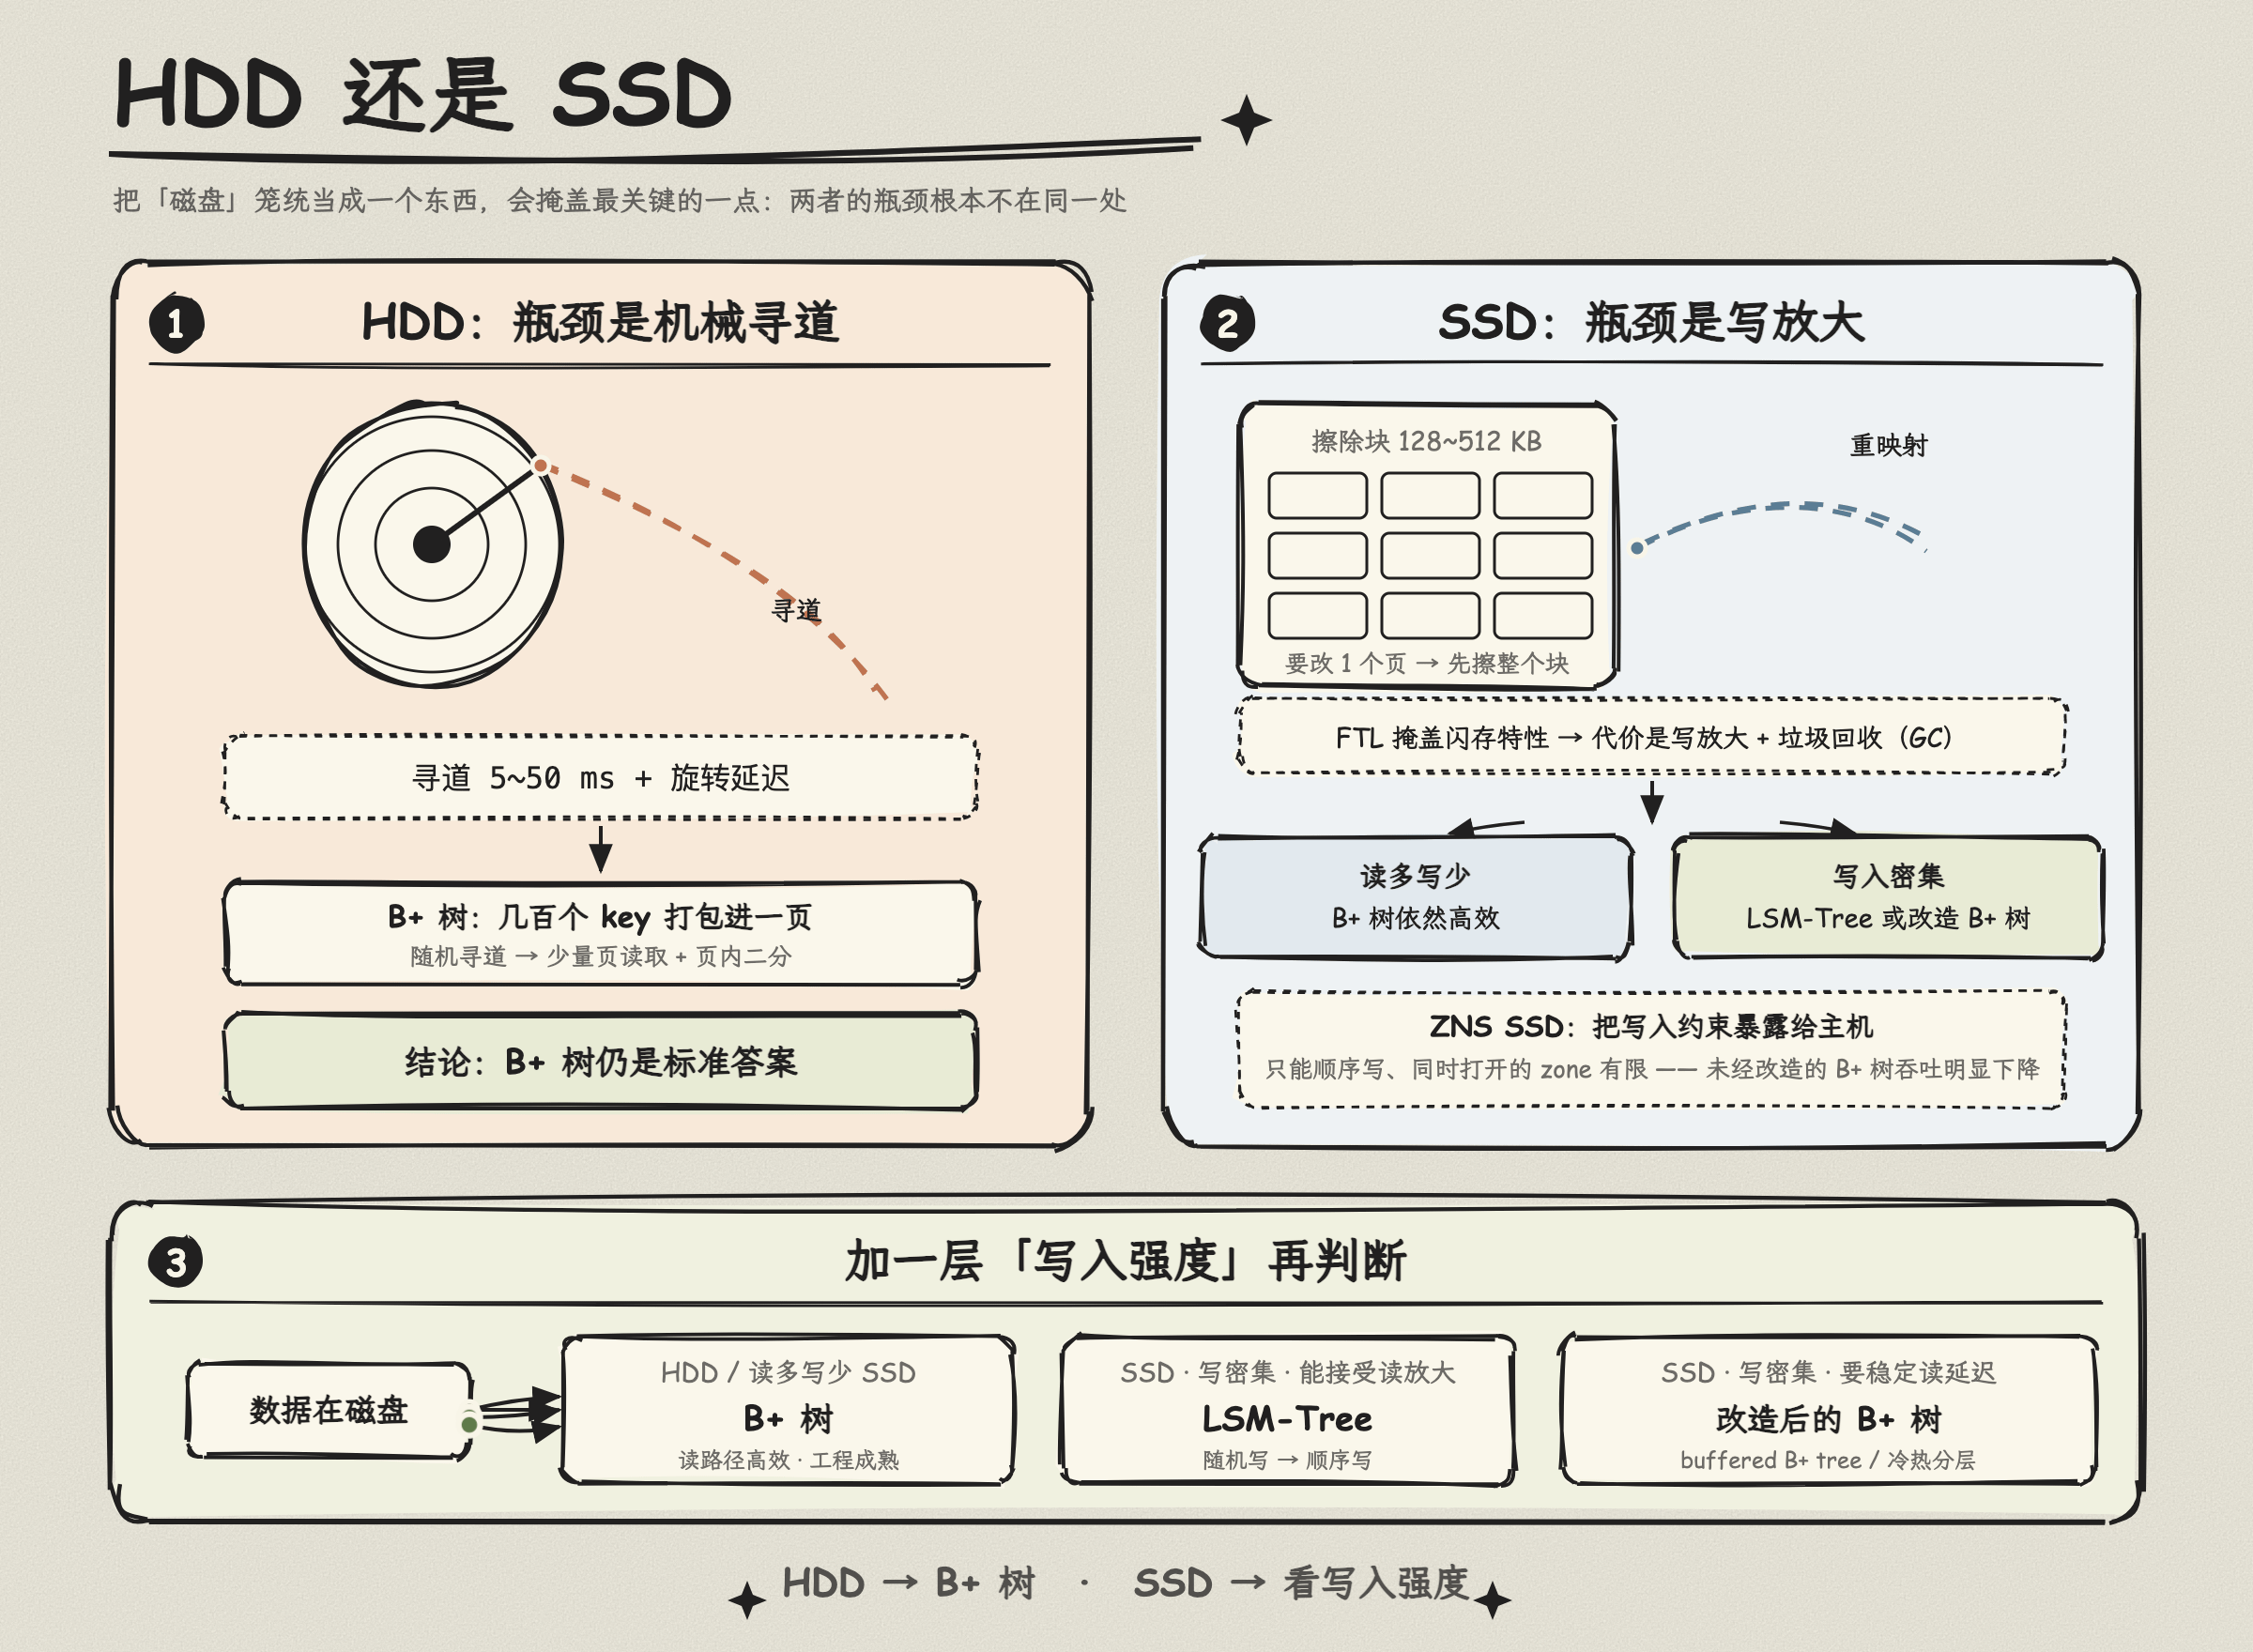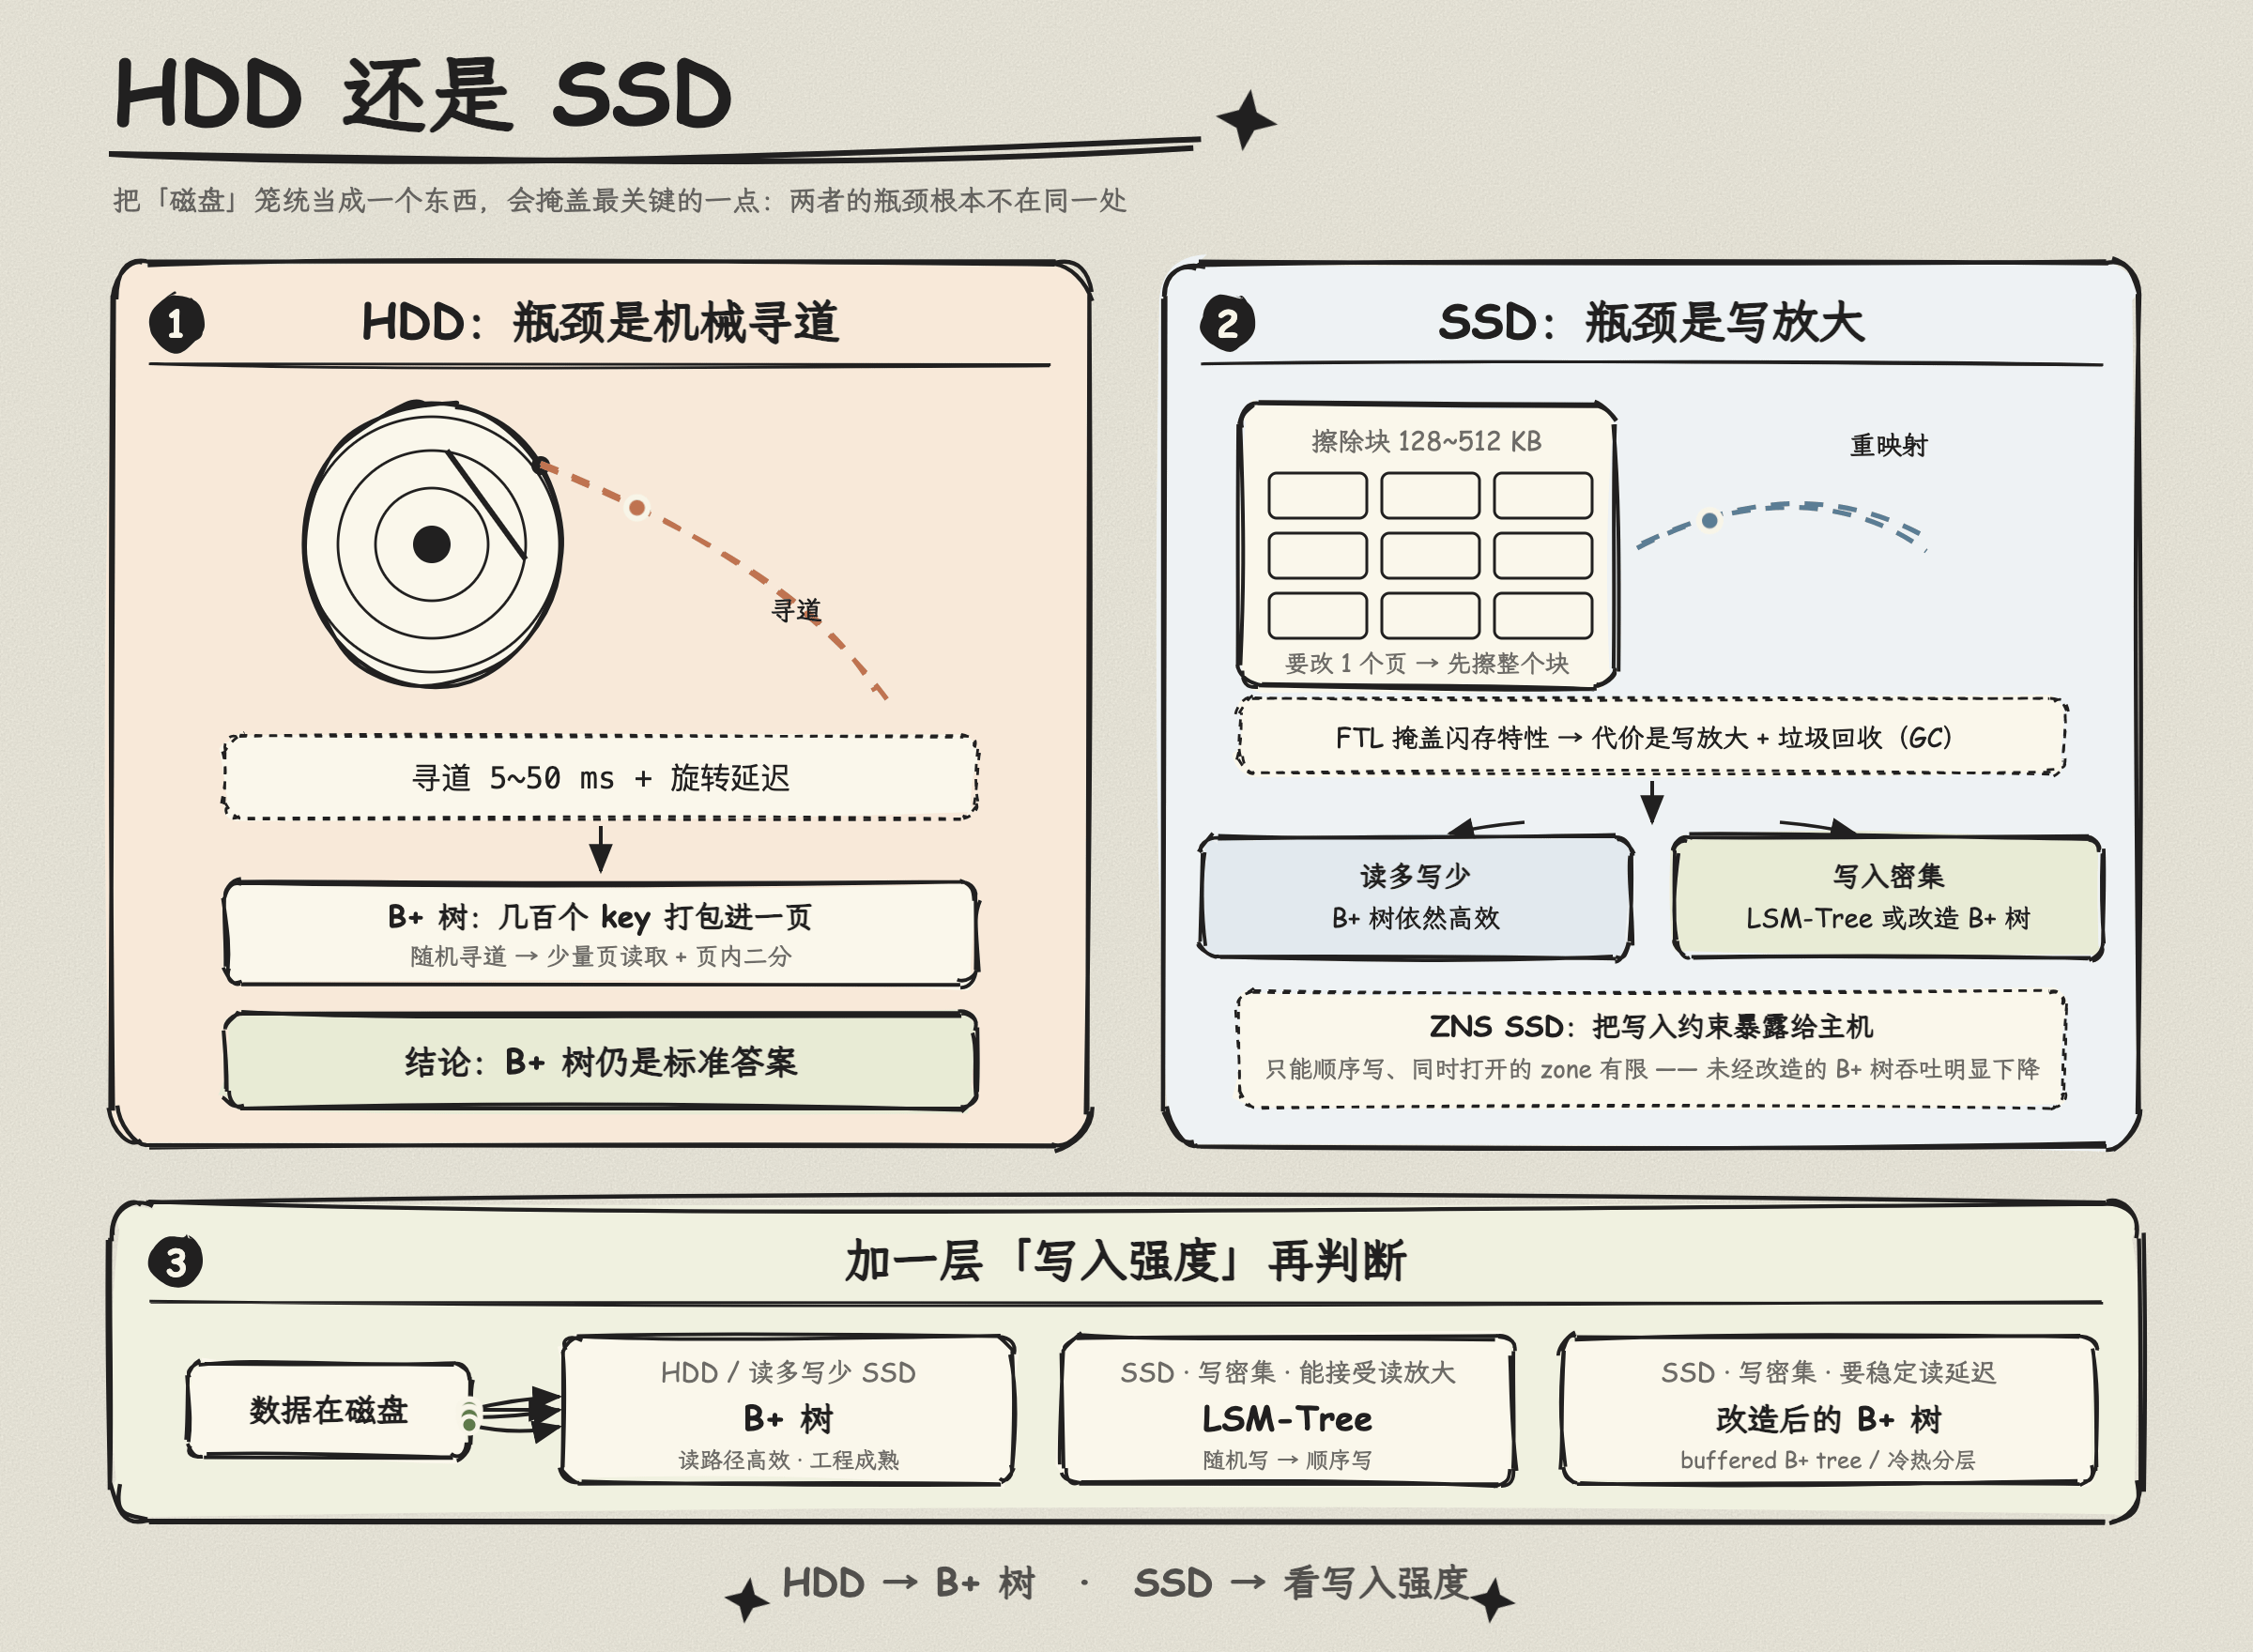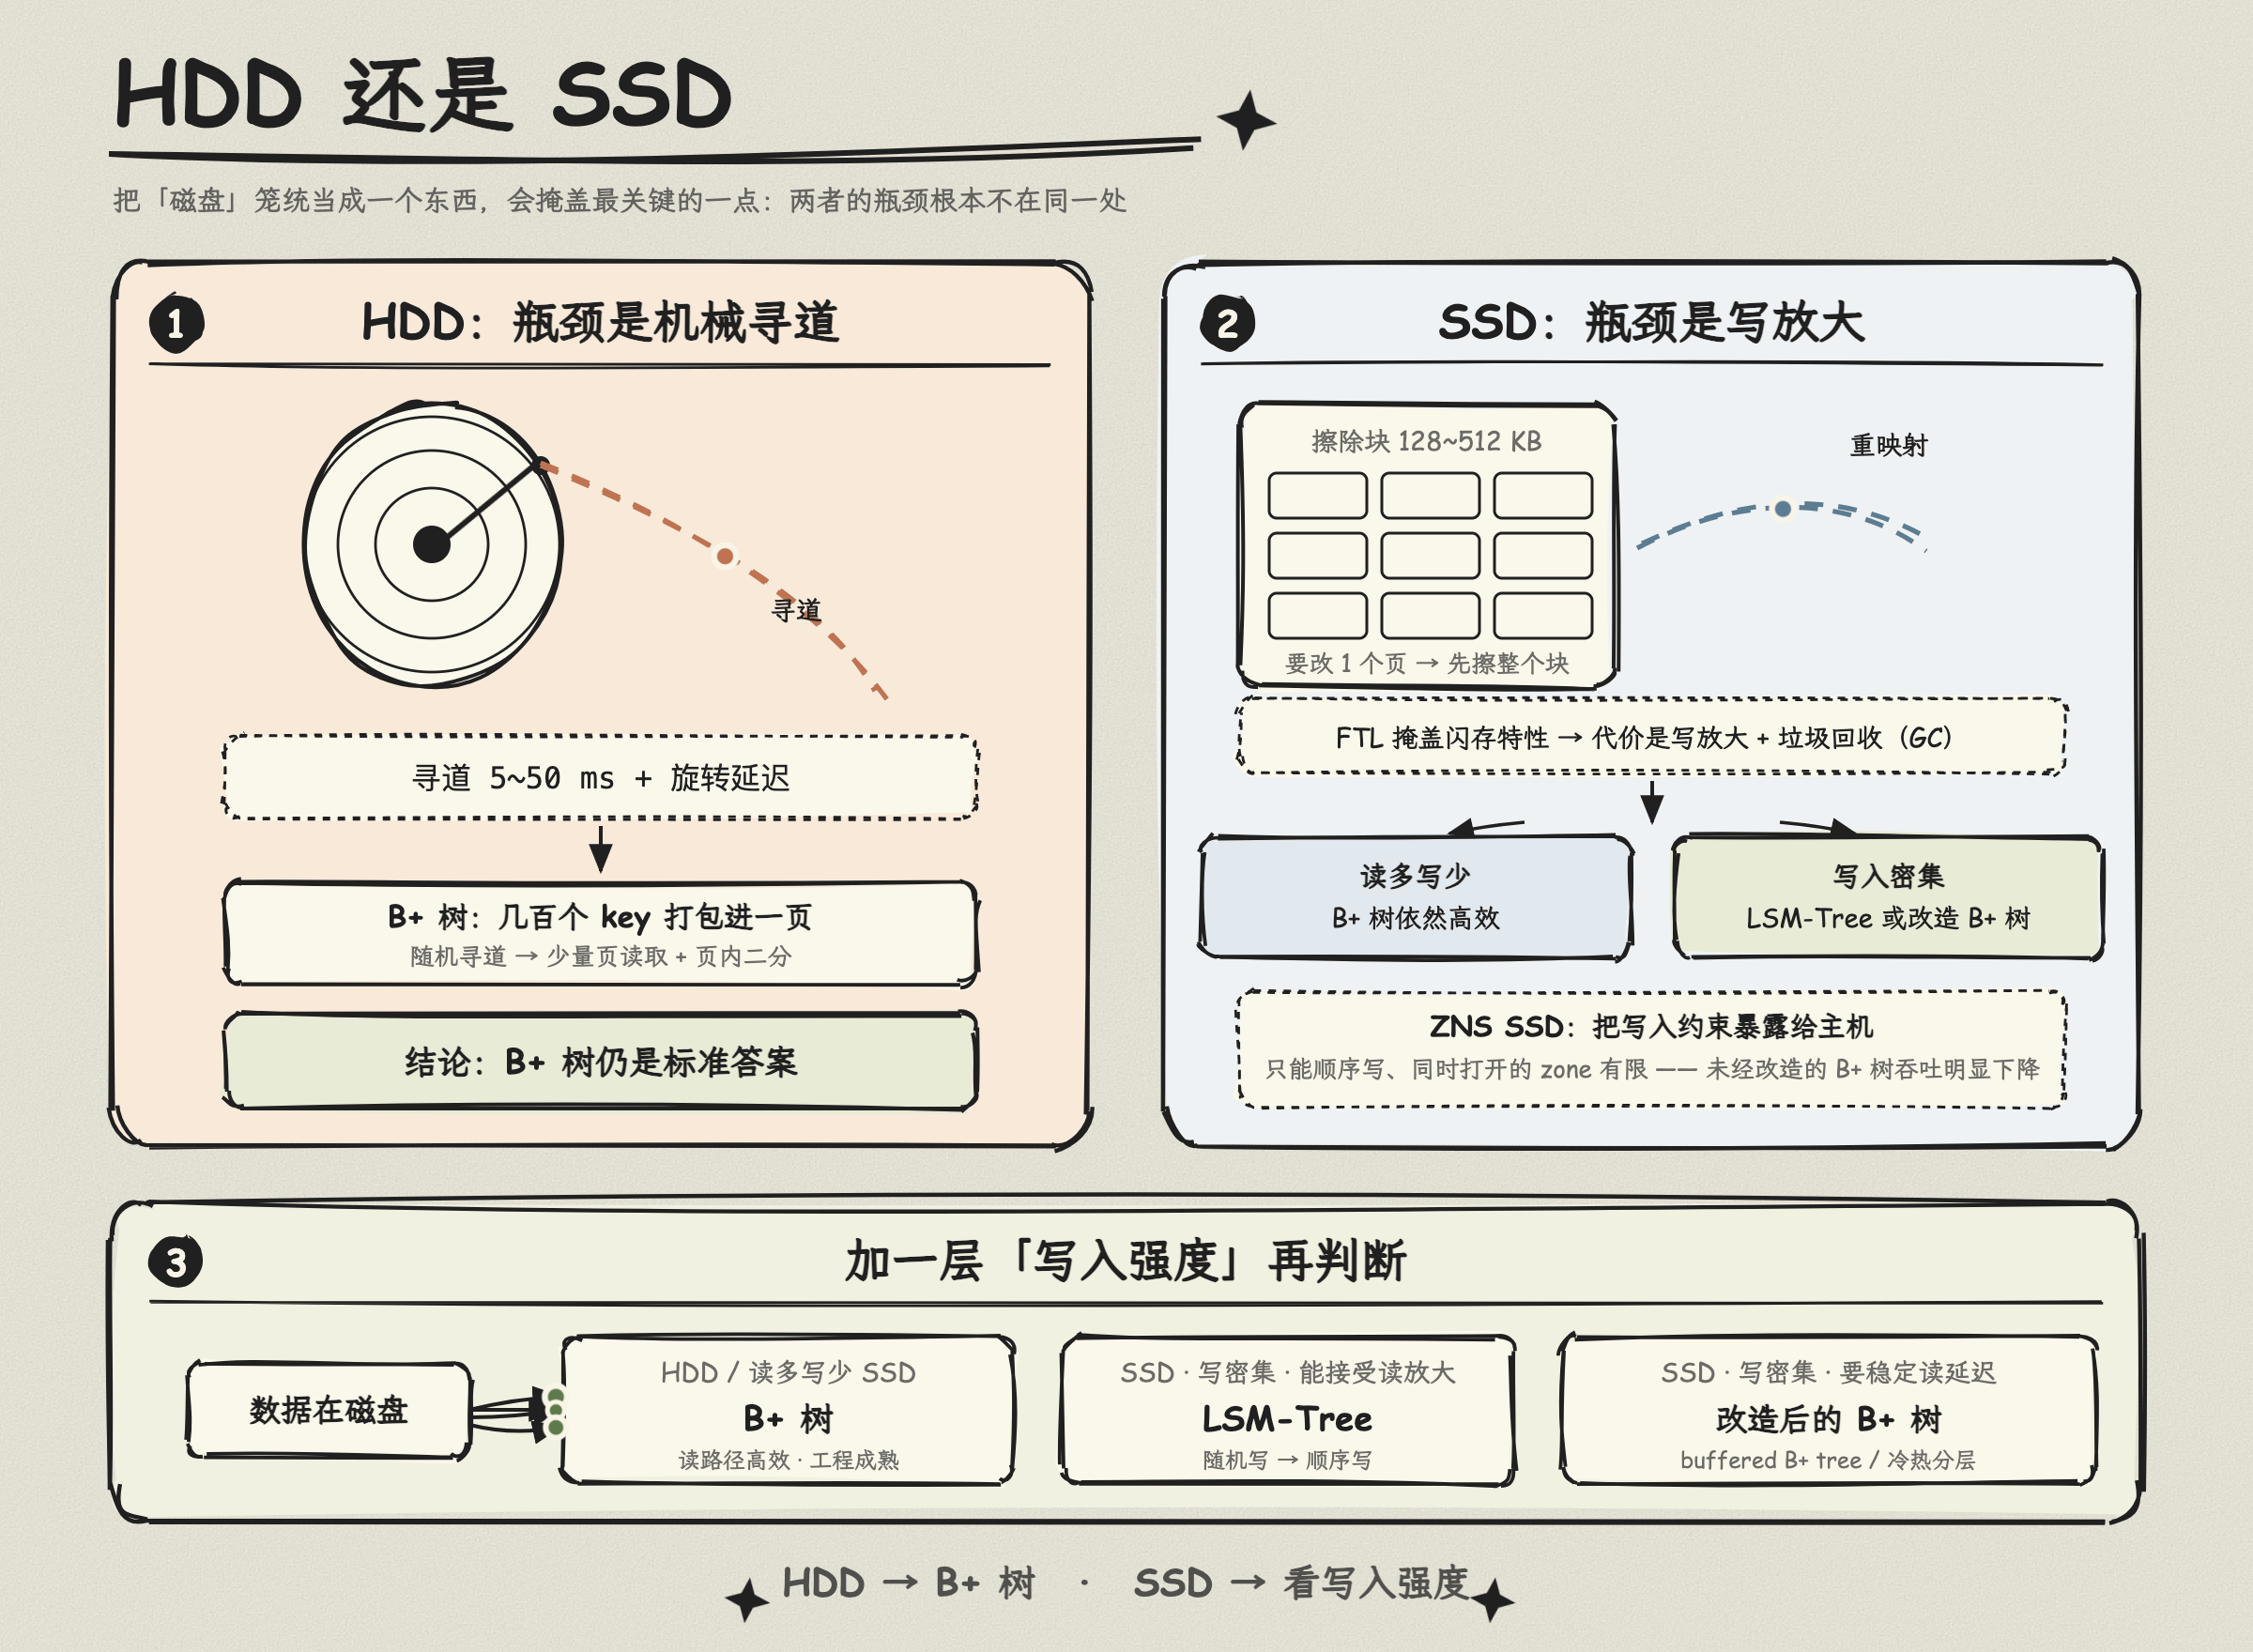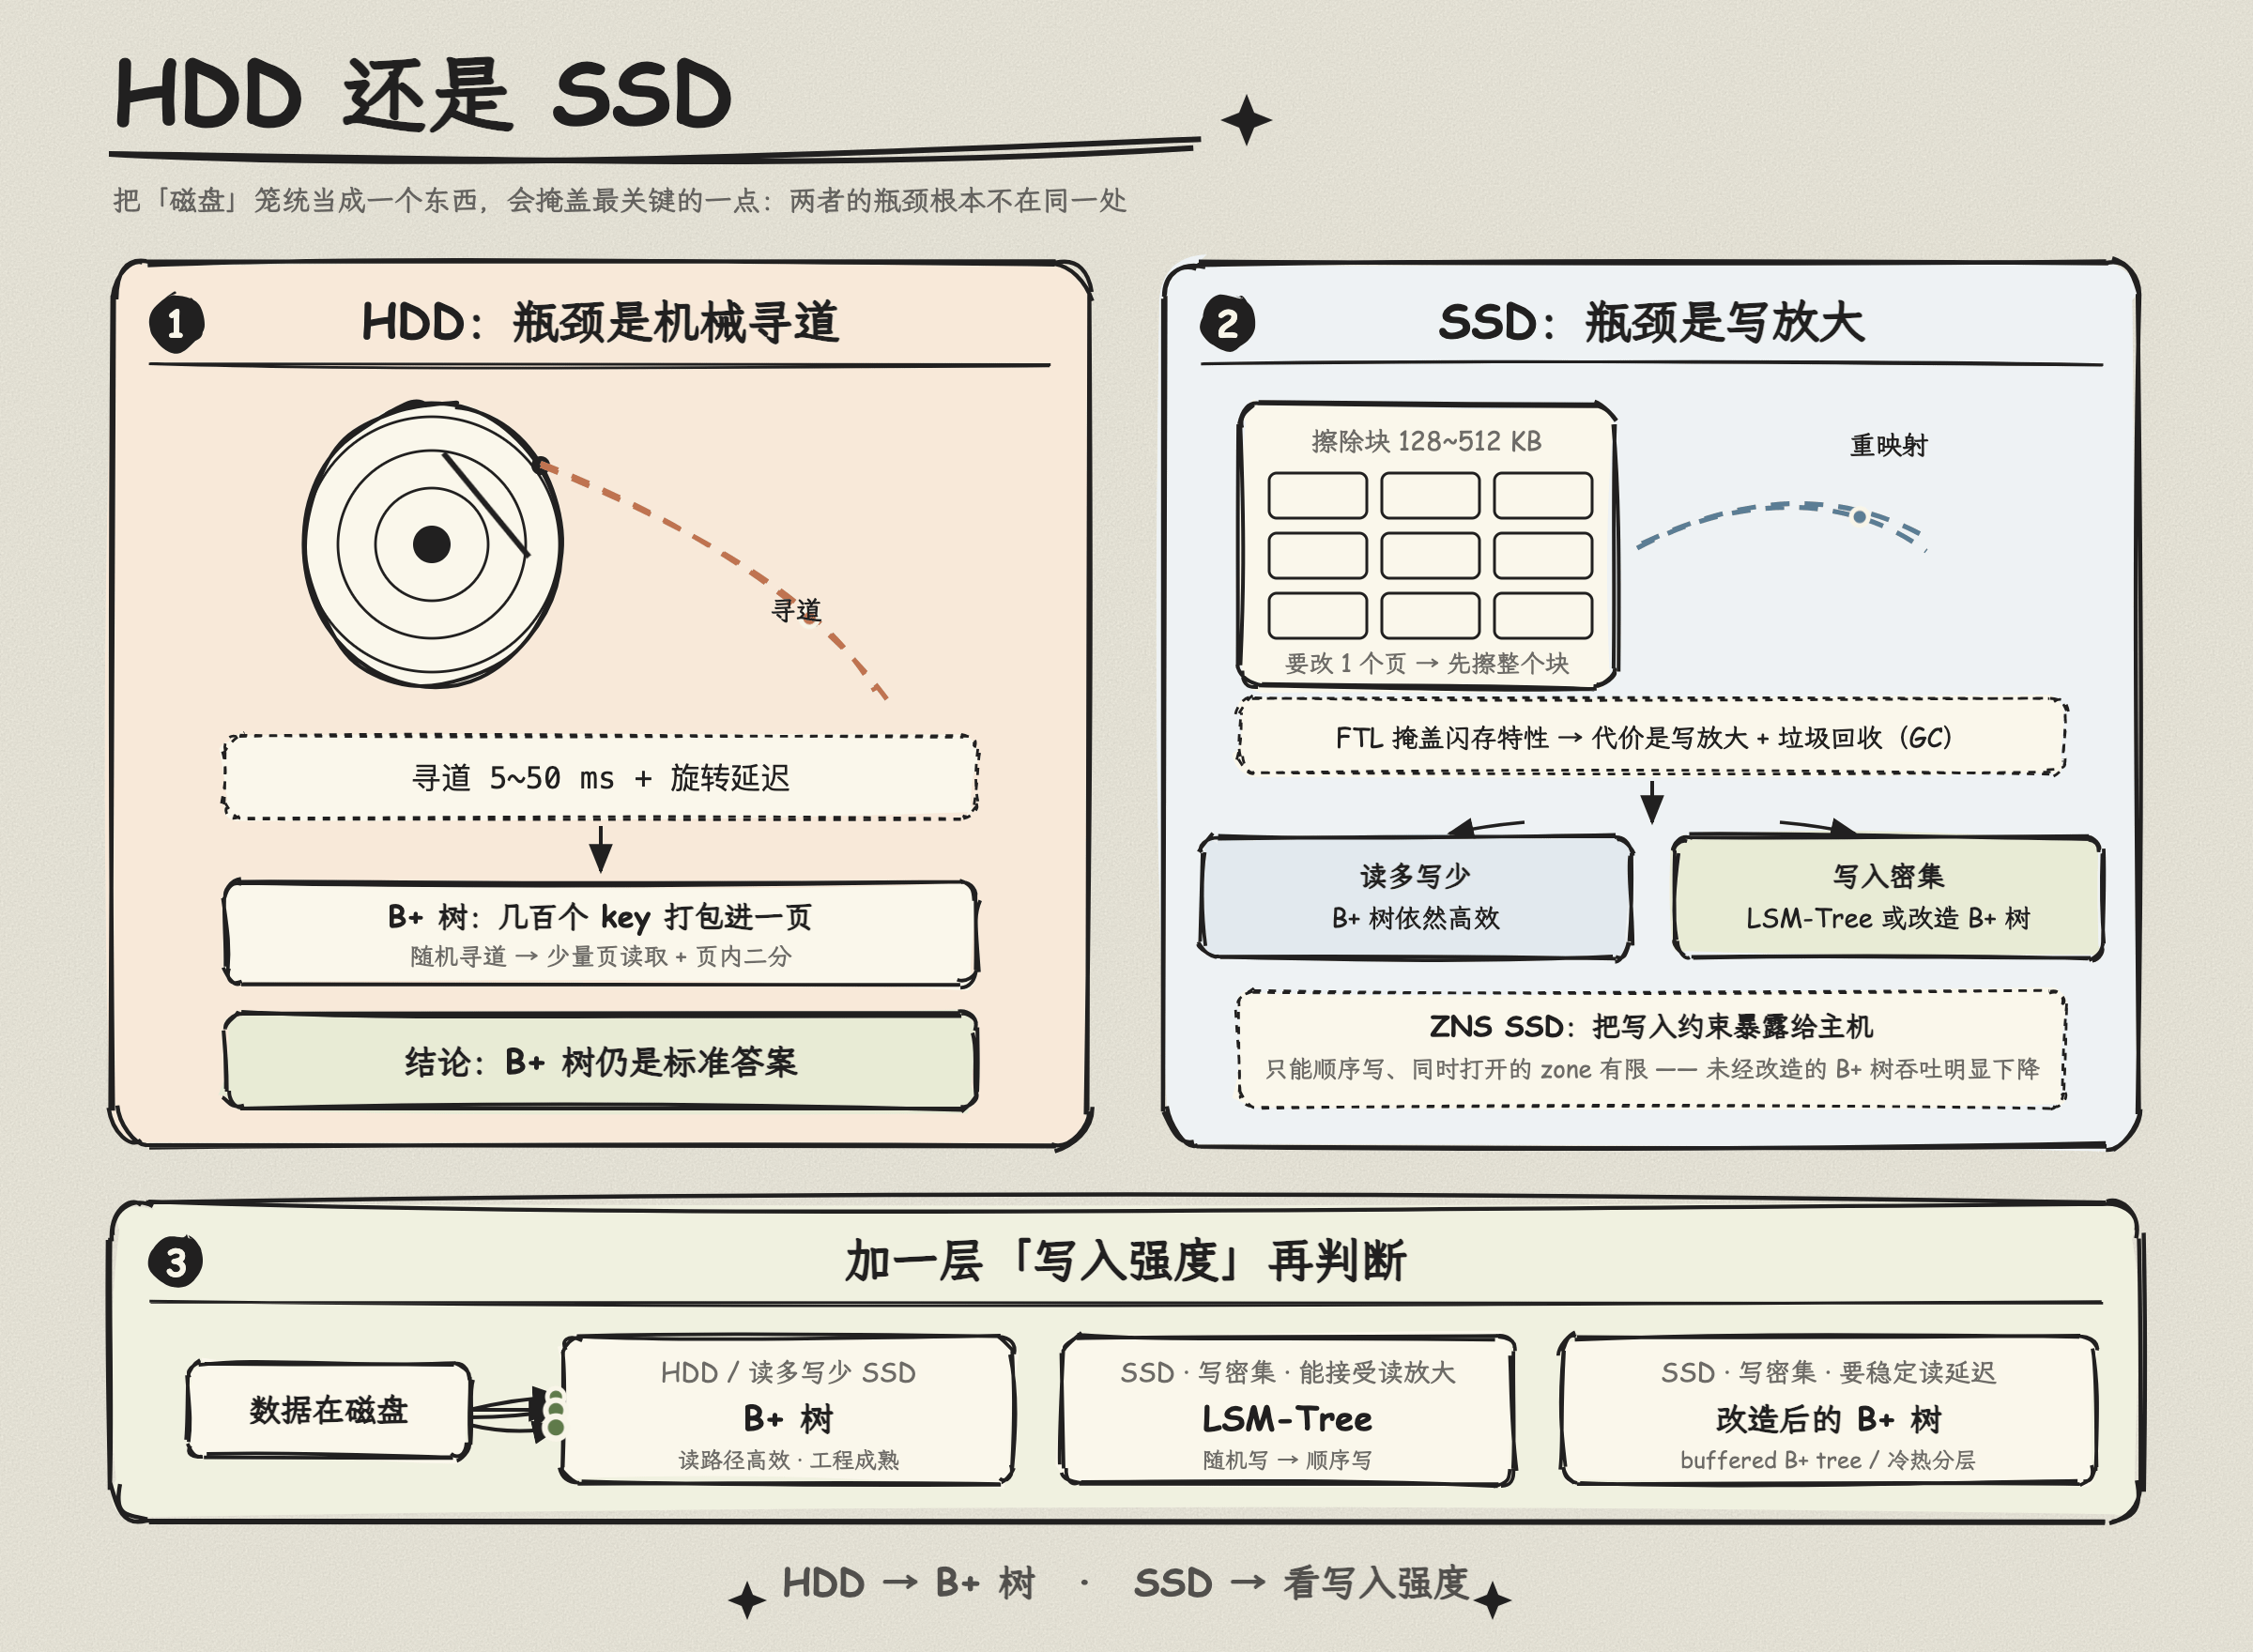
把“磁盘”笼统当成一个东西,会掩盖一个关键事实:HDD 的瓶颈是机械寻道,SSD 的瓶颈是闪存写放大和擦除块约束。B+ 树的大扇出和页对齐是为前者设计的;面对后者,它仍然可用,但需要正视新问题,而 LSM-Tree 在某些写入场景下更具优势。

4.1 HDD:B+ 树仍然是标准答案

机械硬盘的随机访问代价极高(寻道 5–50 ms,加上旋转延迟),而 B+ 树把几百上千个 key 打包进一个页,一次 I/O 取回一批,正好把“随机寻道”转化为“少量页读取 + 页内二分”。叶子链表让范围扫描变成顺序读,顺序读在 HDD 上远快于随机读。所以前面“B+ 树为磁盘 I/O 而生”的论述,主要就是针对 HDD 的,逻辑几乎不需要调整。

4.2 SSD:B+ 树可用,但有两个新问题

SSD 没有机械寻道,随机读的代价极低(页级读取只需几十微秒),这意味着“把数据打包进页以减少寻道”的收益变小了。但 SSD 有自己的麻烦:

第一,原地更新代价高。 闪存必须先擦除整个块(128–512 KB)才能覆写,而 B+ 树的节点更新往往是原地写。SSD 通过 FTL(闪存转换层)做重映射来掩盖这个问题,但代价是写放大和垃圾回收(GC)。在写入密集的场景下,B+ 树的随机小更新会持续触发 GC,拖累性能。

第二,ZNS SSD 等新形态让问题更尖锐。 传统 SSD 靠 FTL 隐藏闪存特性,而 ZNS SSD 把写入约束暴露给主机:只能顺序写、同时打开的 zone 数量有限。把未经改造的 B+ 树直接部署到 ZNS SSD 上,吞吐量会明显下降,写入次数增加——这说明 B+ 树“为块设备设计”的前提,在新型 SSD 上并不自动成立。

图 3:HDD 与 SSD 的瓶颈不在同一处。左边机械硬盘,代价大头是磁头寻道(5~50 ms)加旋转延迟,B+ 树把几百个 key 打包进一页,正好把随机寻道换成少量页读取;右边固态硬盘没有寻道,但闪存必须先擦除整个块才能覆写,原地更新经 FTL 重映射后留下写放大和 GC,于是要再按写入强度分岔:读多写少仍是 B+ 树,写密集则考虑 LSM-Tree 或改造后的 B+ 树。

4.3 选型判断:加一层“写入强度”

在原有三步选型(数据在哪 → 要不要顺序 → 实现成本)的基础上,磁盘场景可以拆成两条分支:

条件 推荐 理由
HDD,或读多写少的 SSD 场景 B+ 树 读路径依然高效,工程成熟度无可替代
SSD,写入密集,且能接受读放大 LSM-Tree 把随机写转为顺序写,避开 SSD 的原地更新痛点
SSD,写入密集,但需要稳定读延迟 改造后的 B+ 树(如 buffered B+ tree / 冷热分层) 用缓冲或分层存储减少对闪存的随机小写

LSM-Tree 在 SSD 上的优势来自它“顺序写 + 后台合并”的机制,这与闪存“顺序写友好、原地更新昂贵”的特性天然匹配。代价是读放大和空间放大,所以它不是无条件更优,只是在写密集场景下值得优先考虑。

所以“磁盘 → B+ 树”更准确的表述是:HDD → B+ 树;SSD → 看写入强度,读多写少选 B+ 树,写密集考虑 LSM-Tree 或对 B+ 树做闪存友好改造。


五、一张表收尾

维度 哈希表 跳表 B+ 树
存储介质 内存 内存 磁盘(HDD 为主;SSD 上可用但需权衡写入)
等值查询 期望 O(1),最快 期望 O(log n) O(log n),实际 1~2 次 I/O
范围查询 不支持 支持,定位后顺序扫 支持,叶子链表顺序扫
有序遍历 不支持 支持 支持
写入模式 随机写(扩容代价高) 随机写(局部改指针) 随机写 + 页分裂,有写放大
核心优势 极致的点查速度 内存有序 + 实现简单 磁盘 I/O 最小化(尤其 HDD)
典型系统 Redis KV、Memcached Redis ZSet、LevelDB MemTable MySQL InnoDB、大多数关系库

所以怎么选,顺序是:

  1. 先问数据在哪。内存 → 继续往下。磁盘 → 再问是 HDD 还是 SSD、写入强度如何:HDD 或读多写少的 SSD → B+ 树;SSD 写密集 → LSM-Tree 或闪存友好改造的 B+ 树(LSM 本身是另一个话题,但它是这个分支的自然候选)。
  2. 再问要不要顺序。不要 → 哈希表。要 → 跳表。
  3. 最后问实现和维护成本。在内存有序结构里,跳表比平衡树更容易写对、更容易并发,这是一个经常被忽略但很实际的加分项。

前两步根据数据特征圈定候选集,第三步在候选集内做最终取舍。


引用与致谢

本文配图所用资源如下:

封面图

动图(图 1 ~ 图 3)

  • 生成工具:Animated Sketch Diagram —— 一个把技术概念画成「黑墨手绘涂鸦 + 米色纸面」风格动画图的 Claude Code 插件。
  • 项目地址:https://github.com/OLDyade/animated-sketch-diagram
  • 作者:OLDyade
  • 许可:见项目仓库中的 LICENSE 文件。
  • 说明:三张动图均由该工具生成 SVG + CSS 动画后导出为无缝循环 GIF,文字内容依据本文正文整理,图中数据为示意值(节点数、页大小、耗时区间等取的是文中给出的典型量级,不是某次真实压测的结果)。

感谢阅读。

楔子

在早些年开发 Node.js 项目的过程中,我使用过其子进程(child_process)模块的部分功能,当时需要在 Node.js 的程序中使用 Linux 下的一个命令来处理一些数据。比如实现一个使用 ls 命令来查看当前目录结构的功能:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// 这是 Node.js 官方版本 12.x 文档下提供的一个实现例子 [Child Process | Node.js v12.13.0 Documentation](https://nodejs.org/dist/latest-v12.x/docs/api/child_process.html#child_process_child_process_spawn_command_args_options)
const { spawn } = require(‘child_process’);
const ls = spawn(‘ls’, [‘-lh’, ‘/Users’]);

// 控制台正常输出
ls.stdout.on(‘data’, (data) => {
console.log(`stdout: ${data}`);
});

// 控制台异常输出
ls.stderr.on('data', (data) => {
console.error(`stderr: ${data}`);
});

// 关闭
ls.on('close', (code) => {
console.log(`child process exited with code ${code}`);
});

事实上,我们可以通过以上方式,来实现任何与本地 Linux 服务交互的工作。任何 Linux 服务器下的系统命令,或者安装的第三方软件,均可以通过 Node.js 来使用。

达摩克利斯之剑

当时只是觉得这个功能好玩、实用,但是没有进一步深入研究。直到 周下载量过 200万的 npm 包被注入恶意代码 事件的发生,让我意识到 Node.js 的子进程功能还是一把达摩克利斯之剑。在安全防范较低或者没有的情况下,极其容易被恶意利用,而且后果不堪设想。

当然,该事件当中还藏着另外一把达摩克利斯之剑:JavaScript 下的 eval 函数 。eval 函数中可以执行几乎所有的 JavaScript 代码,简直就是一个行走的编译器。在使用该函数时,同样需要做好相关的安全工作,比如限制未知用户往里面传入任何数据。

当然,事件热的时候,关注过,凉了之后也就不了了之。

又见,思考

直到最近一段时间,在做一个项目,需要对图像文件做一下处理。在 Linux/Mac 下有一个图形图像处理工具,叫 imagemagick ,里面有瑞士军刀般多的好用功能。下意识中,我就想到了使用 Node.js 的子进程功能来直接使用。但是我又觉得这么实现似乎过于简单,而且太依赖本地环境。

于是,我就去 Node.js 官网查找了一下,看有没有新增处理图形图像的新特性,很遗憾,并没有!但是我并没死心,又继续在 bing 中搜索了一下。这时我找到一片文章(nodejs图片处理工具gm用法),介绍了如何在 Node.js 环境下,使用 npm 包 gm 来处理图形图像文件。

我很高兴,并认为这是一个理想的方案,因为那篇文中关于 gm 的介绍十分清楚,并且使用起来也很简洁。在甚至连 gm 在 npm 官网上的使用手册都没有看的前提下,我就贸然使用了 gm 。

当我激动地盯着屏幕,看着那段脚本启动,然后报异常后,我的心情先是失落,然后转为意外,最后,我静静地笑了。因为异常提示没有找到 convert 命令,而 convert 命令正是我上面提到 imagemagick 工具一下的一个命令。所以我推测这个 gm 包其实就是按照我最初的那种思路实现的。

为了一探究竟并验证我的想法。首先,我看了 gm 在 npm 上的官方使用手册。果然,文档的一开始就清楚的提示,使用该工具之前需要先安装 imagemagick 。那它到底是如何使用的 imagemagick 呢?让我们接着往下看。

我看了 gm 的源码。果然, gm 引用了一个叫 cross-spawn 的包,来执行 convert 命令,而 cross-spawn 的源码中,确实是使用 child_process 子进程来实现的。

到此为止,整个过程已经理顺。而我则陷入了沉思……

可想而知,利用这种模式,即 Node.js + child_process 的方式,可以实现很多基于操作系统命令行的功能。在没有遇到 gm 之前,我只是简单地这么认为。在遇到 gm 之后,我才发现,原来真的有工程师利用这种模式来输出被广泛( gm 在 npm 上的周下载量,截止我写这篇文章为止,已经超 10 万了)使用的工具。有时候,编程技术迭代很快,日新月异,每隔一段时间就会有一个新的很炫酷的技术冒出来,然后受到大家的追捧。而有时候,编程技术迭代又很慢,很多技术明明是新瓶装旧酒,却同样可以焕发出耀眼的光芒。

所以说,在计算机这一行,如果你真心的热爱她,就应该沉下心来,认真地去理解和感悟技术的本质,而不是去一个劲儿地追逐新时髦。唯有看透本质,才是获取真理钥匙的最佳途径。

导读

使用 npm 作为包管理工具已经很多年了,但是常用的其实就那么几个功能,一些基础的但很重要的概念和用法反而不太清楚。最近抽空整理并探索一下,重新学习 npm 。

今天先对 package.json 配置文件中的 dependencies 和 devDependencies 做一番研究。

dependencies

  1. 使用环境:生产环境下所依赖的 npm 包集合;
  2. 命令行安装单个包的方式:
1
2
3
4
# 在与 package.json 同级目录下执行
# —sava-prod 为默认安装模式
# 安装以后会自动在 package.json 的 dependencies 下添加 <package-name>
npm install <package-name> [—sava-prod]
  1. 命令行集成安装方式:
1
2
3
4
5
# 在与 package.json 同级目录下执行
# 安装 dependencies 和 devDependencies 中的所有 npm 包
npm install
# 仅安装 dependencies 下的所有 npm 包
npm install —production
  1. 被调用:如果将当前工程作为一个单独包,提供给其他人使用,在对方使用 npm install 命令安装时,会自动下载 dependencies 下的包集合。

devDependencies

  1. 使用环境:开发和测试环境下所依赖的 npm 包集合;
  2. 命令行安装单个包的方式:
1
2
3
# 在与 package.json 同级目录下执行
# 安装以后会自动在 package.json 的 devDependencies 下添加 <package-name>
npm install <package-name> —sava-dev
  1. 命令行集成安装方式:
1
2
3
# 在与 package.json 同级目录下执行
# 安装 dependencies 和 devDependencies 中的所有 npm 包
npm install
  1. 被调用:如果将当前工程作为一个单独包,提供给其他人使用,在对方使用 npm install 命令安装时,不会自动下载 devDependencies 下的包集合。

建议

部署

在我以往写代码的过程中,对于需要引用包的位置,并没有做任何区分,因为在使用 npm install 时会一起安装,所以没有太在意,直到使用 nest.js 时发现,默认安装的包居然有 200M 之多。

当我需要自动化部署它们到一台线上服务器时,会花费很多时间,但其实像 @nestjs/cli 、 @types/supertest 等开发和测试工具在线上根本是用不着的。

于是我对于要往线上环境上传的工程使用了 npm install —production 命令,这时文件大小缩小为 11M ,然后再压缩以后,最终仅仅剩下了 5M 。

发布

当整个工程开发完毕,作为一个独立包待发布时,同样需要注意!如果不对 dependencies 和 devDependencies 加以区分,将开发/测试依赖写在生产依赖下,会导致调用该 npm 包的用户下载很多与其无关的包,从而造成不必要的资源浪费。

参考来源

Specifying dependencies and devDependencies in a package.json file | npm Documentation
npm install 你很明白吗 - NeverYu - CSDN博客

起因

在一次使用 vs code 时,发现一个 bug :使用中文路径 split terminal (终端分屏)时会报异常并且失败,英文路径是ok的。

经过

确认 bug

然后我在不同场景下试图复现这个 bug :

  1. 使用 vs code 新建一个工程,然后新建中文目录, bug 会 100% 复现;
  2. 在 vs code 中选择不同 shell , bash 和 zsh , bug 仍旧 100% 复现;
  3. 因为vs code的终端是基于本地系统的,所以我在本地终端中,新建中文文件,然后基于该路径,使用终端软件自带分屏功能进行分屏,并没有出现 bug ,排除终端问题。

提交 bug

目前来看,这个应该是 vs code 的一个 bug,实锤了。因此我决定将这个 bug反馈给 vs code 的工作人员。

之前在使用 vs code 时,无意中发现右下角有个笑脸,是用来接收反馈信息的,于是乎我现在选择触发它。

触发以后,点击“提交 bug ”,会弹出一个界面,用于填写bug内容,这里需要使用英文编辑(如果是中文提问,工程师会告诉你他不会中文,并无情地关闭 issue )。然后点击“在 github 预览”会跳转到 github 下(需要登录),此时如果不需要编辑,直接 submit issue 就好。

来自工程师的响应

在提交完 issue 以后的第二天早上,我收到了来自 vs code 工作人员的回复,一位来自澳大利亚的软件工程师,他告诉我提交该类型的 issue ,还需要提供一下我的 vs code 版本信息,最好还有 bug 复现的视频、动图或者截屏。

得到对方的及时回复(毕竟有时差),我还是有点小激动的。然后按照对方提示,我认真的准备了 vs code 版本信息和 bug 复现动图,并再一次提交。

这一次,在当天晚上我就得到了回复,对方提供了解决方案,修改 setting 配置,在分屏时自动返回到 vs code 工程的父路径。这样配置以后,中文路径分屏确实不报异常了,但是却修改了我原本的使用习惯。于是乎,我把这个情况再一次反馈回去。

这位来自澳大利亚的帅气工程师,这次是这么回复的:你提的问题我们后续会修复,之前告诉你的也只是当前的解决方案。简洁并且直爽,人家之所以给你提之前的方案,并不是说 bug 不存在,只是另一个解决方式,bug我们还是会改,但是你得等待。

结果

到此为止,我认为我的目的达到了,于是乎就把这个issue关了。但是没过多久,这个工程却重新打开了 issue 。我没有再追问,我推测在 bug 修复之前, issue 应该是不会关闭,具体是不是这个澳洲小伙修复就不得而知了。

关于这次issue的整个过程,在 github 上完成过程,感兴趣的同学可以自行查阅。(terminal.integrataed.splitCwd inherited doesn’t work correctly for unicode characters · Issue #83496 · microsoft/vscode · GitHub)

总体思路

  1. 在linux服务器新建无登录账号(/sbin/nologin/)
  2. 构建自动化启动进程脚本
  3. 新建计划任务定时监控服务(crontab)

初衷

在服务器的管理中,我们需要启动一些服务,出于安全方面的考虑,我们不希望以root的方式启动它,而是为这些服务单独建立相应的账号,并且禁用它们的shell登录权限。

实现过程

场景说明

在linux服务器上实现对于nodejs进程进行守护的场景。

构建nodejs程序

  1. 我们新建一个nodejs程序server.js:
1
2
3
4
5
6
7
8
9
const http = require(‘http’)
const server = http.createServer(function (req, res) {
res.writeHead(200, {
‘Content-Type’: ‘application/json’
});
res.end(‘{“server”:”nodejs”}’);
});
server.listen(8080)
console.log(“port = 8080”)
  1. 常规启动:
1
node server.js

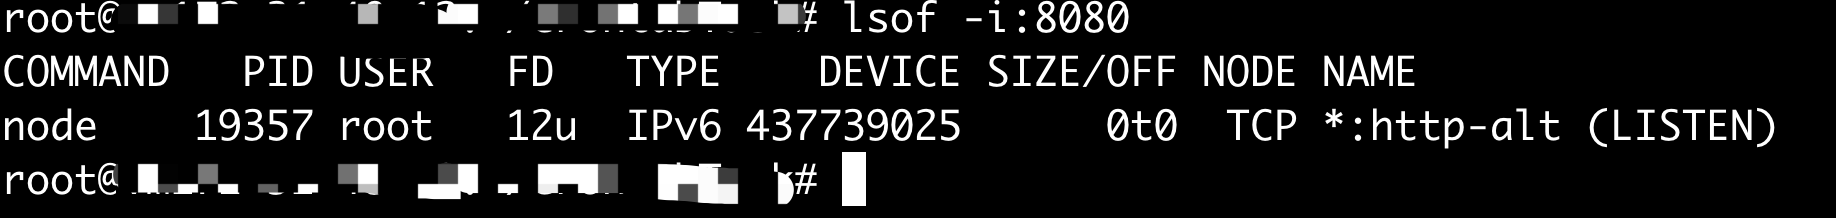
启动以后,server.js进程属于root用户,或者其他可以shell登录的用户:

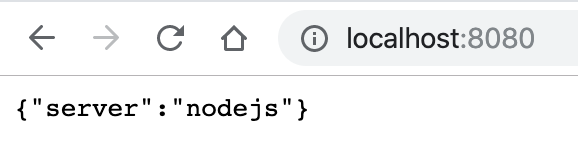
3. 在浏览器敲入ip加端口即可查看运行结果:

新建无登录账号

  1. 新建账号:
1
useradd -M -s /sbin/nologin nodejsUser
  1. 在/etc/passwd下查看账号状态:

    nodejsUser是无法shell登录的,我们可以使用如下命令启动server.js:
1
2
3
4
# 赋予nodejsUser账号可访问server.js文件的权限
sudo chown nodejsUser /opt/nodejsUser/server.js
# 启动
sudo -u nodejsUser node /opt/nodejsUser/server.js
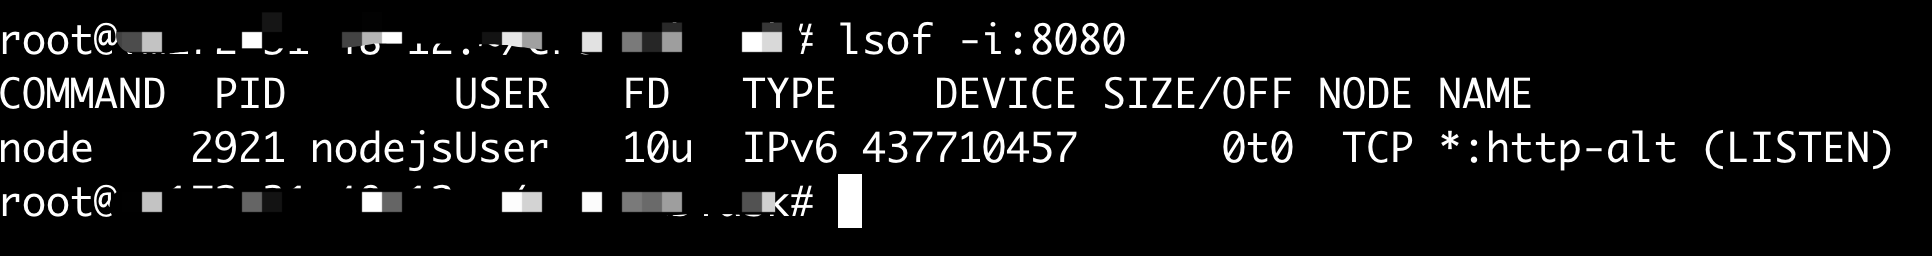
  1. 此时查看8080端口,可以发现,现在用户是nodejsUser了:

编写自动化启动脚本

  1. 此处我们需要借助tmux工具来实现实时监控nodejs进程的功能,下面是具体实现过程server.sh:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
#!/bin/bash
# tumx启动脚本

# 兼容zsh
export DISABLE_AUTO_TITLE="true"
# 会话名称
session=“sever”
# 判断server.js进程是否存在
ps -ef|grep "node /opt/nodejsUser/server.js" |grep -v grep
if [ $? -ne 0 ]
then
echo "start process....."
# 判断tmux会话是否存在
tmux has-session -t $session
if [ $? = 0 ]
then
# 如果存在,则进入该会话
tmux attach-session -t $session
else
# 如果不存在,则新建会话
tmux new-session -d -s $session
fi
# 发送启动程序命令
tmux send-keys -t $session "sudo -u nodejsUser node /opt/nodejsUser/server.js" C-m
else
echo "runing....."
fi
exit
  1. 当tmux会话启动以后,可以随时查看server.js运行的情况:
1
2
# 	启动会话
tmux a -t server

自定义计划任务

  1. 新建计划任务:
1
crontab -e
  1. 任务内容:
1
*/1 * * * * /bin/bash /opt/nodejsUser/server.sh >> /opt/nodejsUser/run.log 2>&1

每分钟执行一次server.sh脚本,执行情况记录到日志文件run.log当中。crontab的定时机制可以自行查阅,比较好理解,这里不再赘述。

写在最后的话

到此为止,所有功能均已实现,我们的计划任务会定时对server.js进程扫描,当发现该进程crash时,会自动重启。当服务器重启时,计划任务也会超常运行。

其实在这之前,我在管理nodejs项目时,使用的是pm2监控工具,现成的免费工具,用起来确实也比较方便,但是在无登录账号下遇到无法启动pm2的问题,虽然花了一些时间攻克,但最终并没有解决,因此就有了本文中的解决方案,先用一段时间看看效果吧。

0%