哈希表、跳表还是 B+ 树:怎么选
选择哈希表、跳表还是 B+ 树,本质上不是在选“哪个数据结构更好”,而是在回答一个问题:你的数据放在哪里,以及你打算怎么查它。
如果数据全在内存里、只按 key 精确找,哈希表是首选;如果数据在内存里、既要按 key 找又要按顺序取一段,跳表是那个“刚刚好”的答案;如果数据在磁盘上、既要等值查又要范围扫还要排序,B+ 树是几十年工程实践筛选出来的默认选项——但“磁盘”本身还要再拆一层:机械硬盘(HDD)和固态硬盘(SSD)的瓶颈不同,选型结论也会随之松动。
下面按场景拆开讲。
一、哈希表:只解决“这一个 key 在哪”
哈希表的核心优势只有一个:等值查询期望 O(1)。给定一个 key,算个哈希,直接跳到数组对应位置。没有树高,没有指针跳转,没有页分裂。
但它的问题也同样明确:数据是无序的。哈希函数打散了顺序,你无法高效地回答“比这个 key 大的下一个是谁”或者“把 100 到 200 之间的都取出来”。
所以哈希表的适用边界很清晰:
- 纯内存场景。哈希表依赖连续数组和指针跳转,放到磁盘上,一次查询可能对应多次随机 I/O;更关键的是它无法把多个 key 打包进一个页,扩容和冲突处理在磁盘上代价极高。磁盘哈希并非完全不存在(如某些 KV 引擎的哈希索引),但在需要范围/排序的场景下劣势明显,工程复杂度也高。
- 只有等值查询。Memcached、Redis 的键值对空间、以及各种内存字典,都是这个场景。一旦业务需要
WHERE id > 100或者ORDER BY,哈希表直接出局。
一句话:如果你确定永远不需要范围查询和排序,哈希表是最快的。但真实业务里,“永远确定”往往不成立。
二、跳表:内存里的有序结构,用简单换确定性
跳表解决的是哈希表解决不了的问题:在保持期望 O(log n) 查找的同时,支持范围查询和有序遍历。
它的结构是在有序链表上建多级索引,查找时从高层往低层跳,最终落到目标区间,然后沿底层链表顺序扫过去。范围查询的代价是“定位起点 + 顺序遍历”,非常自然。
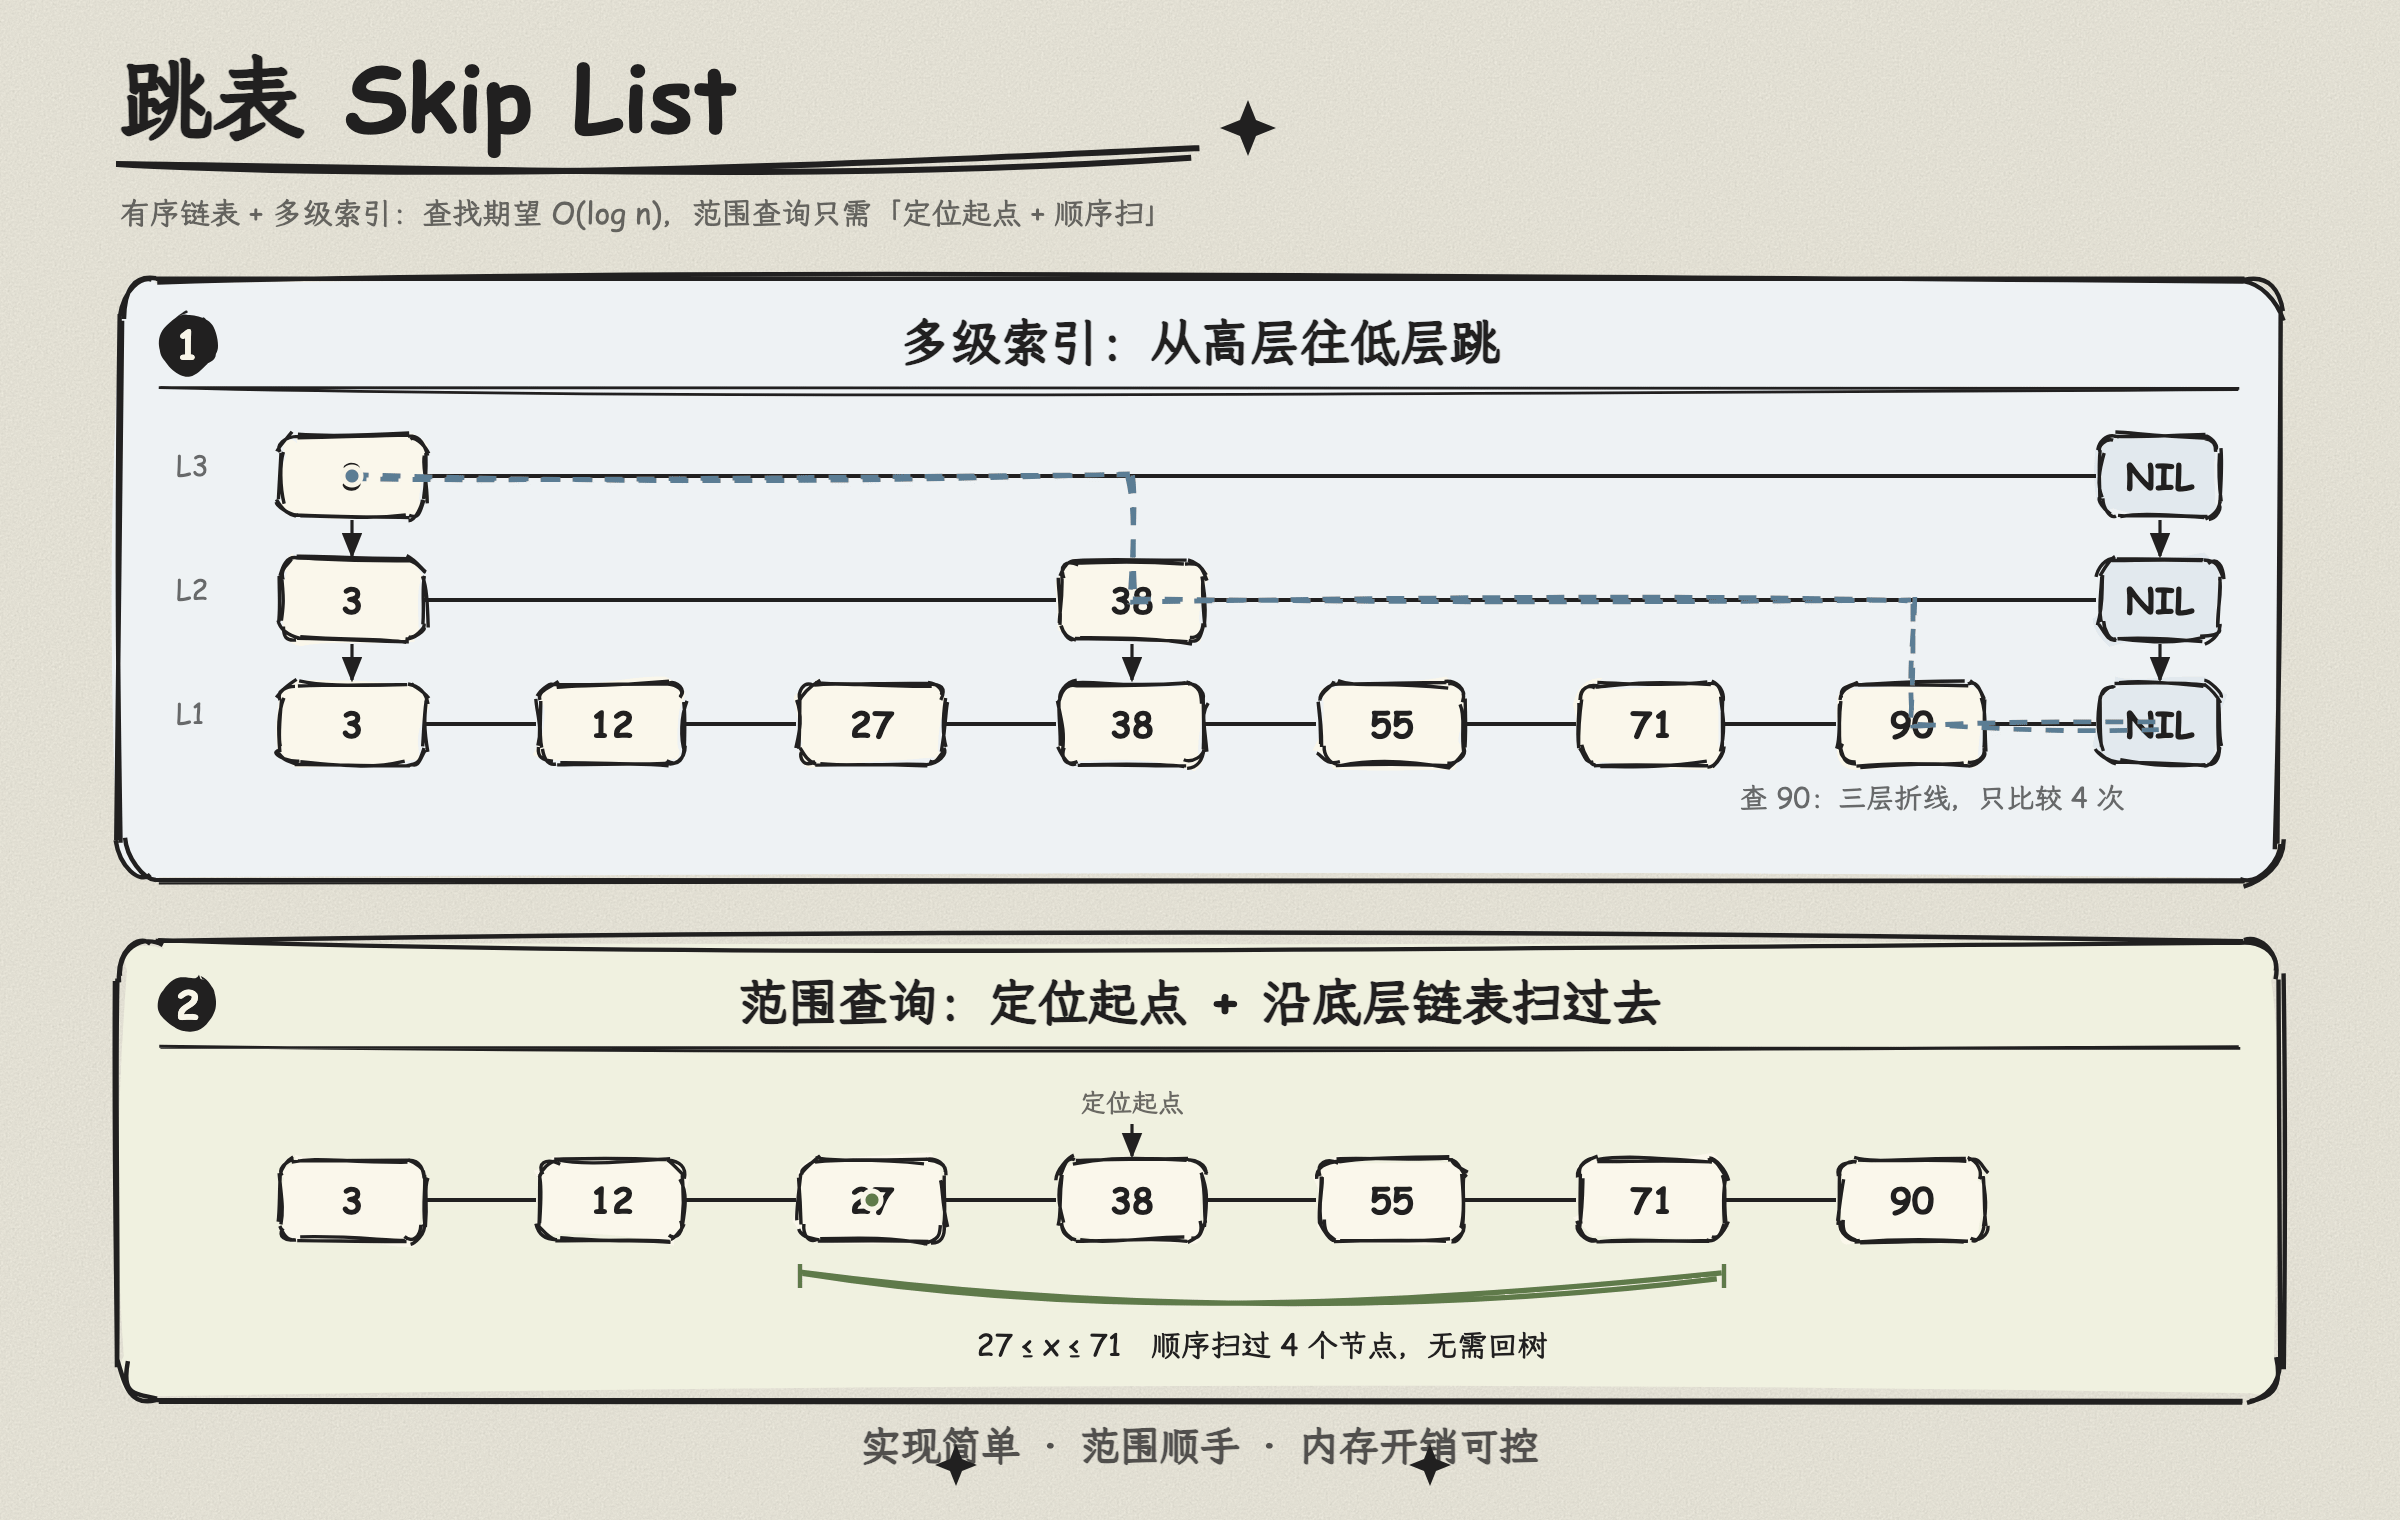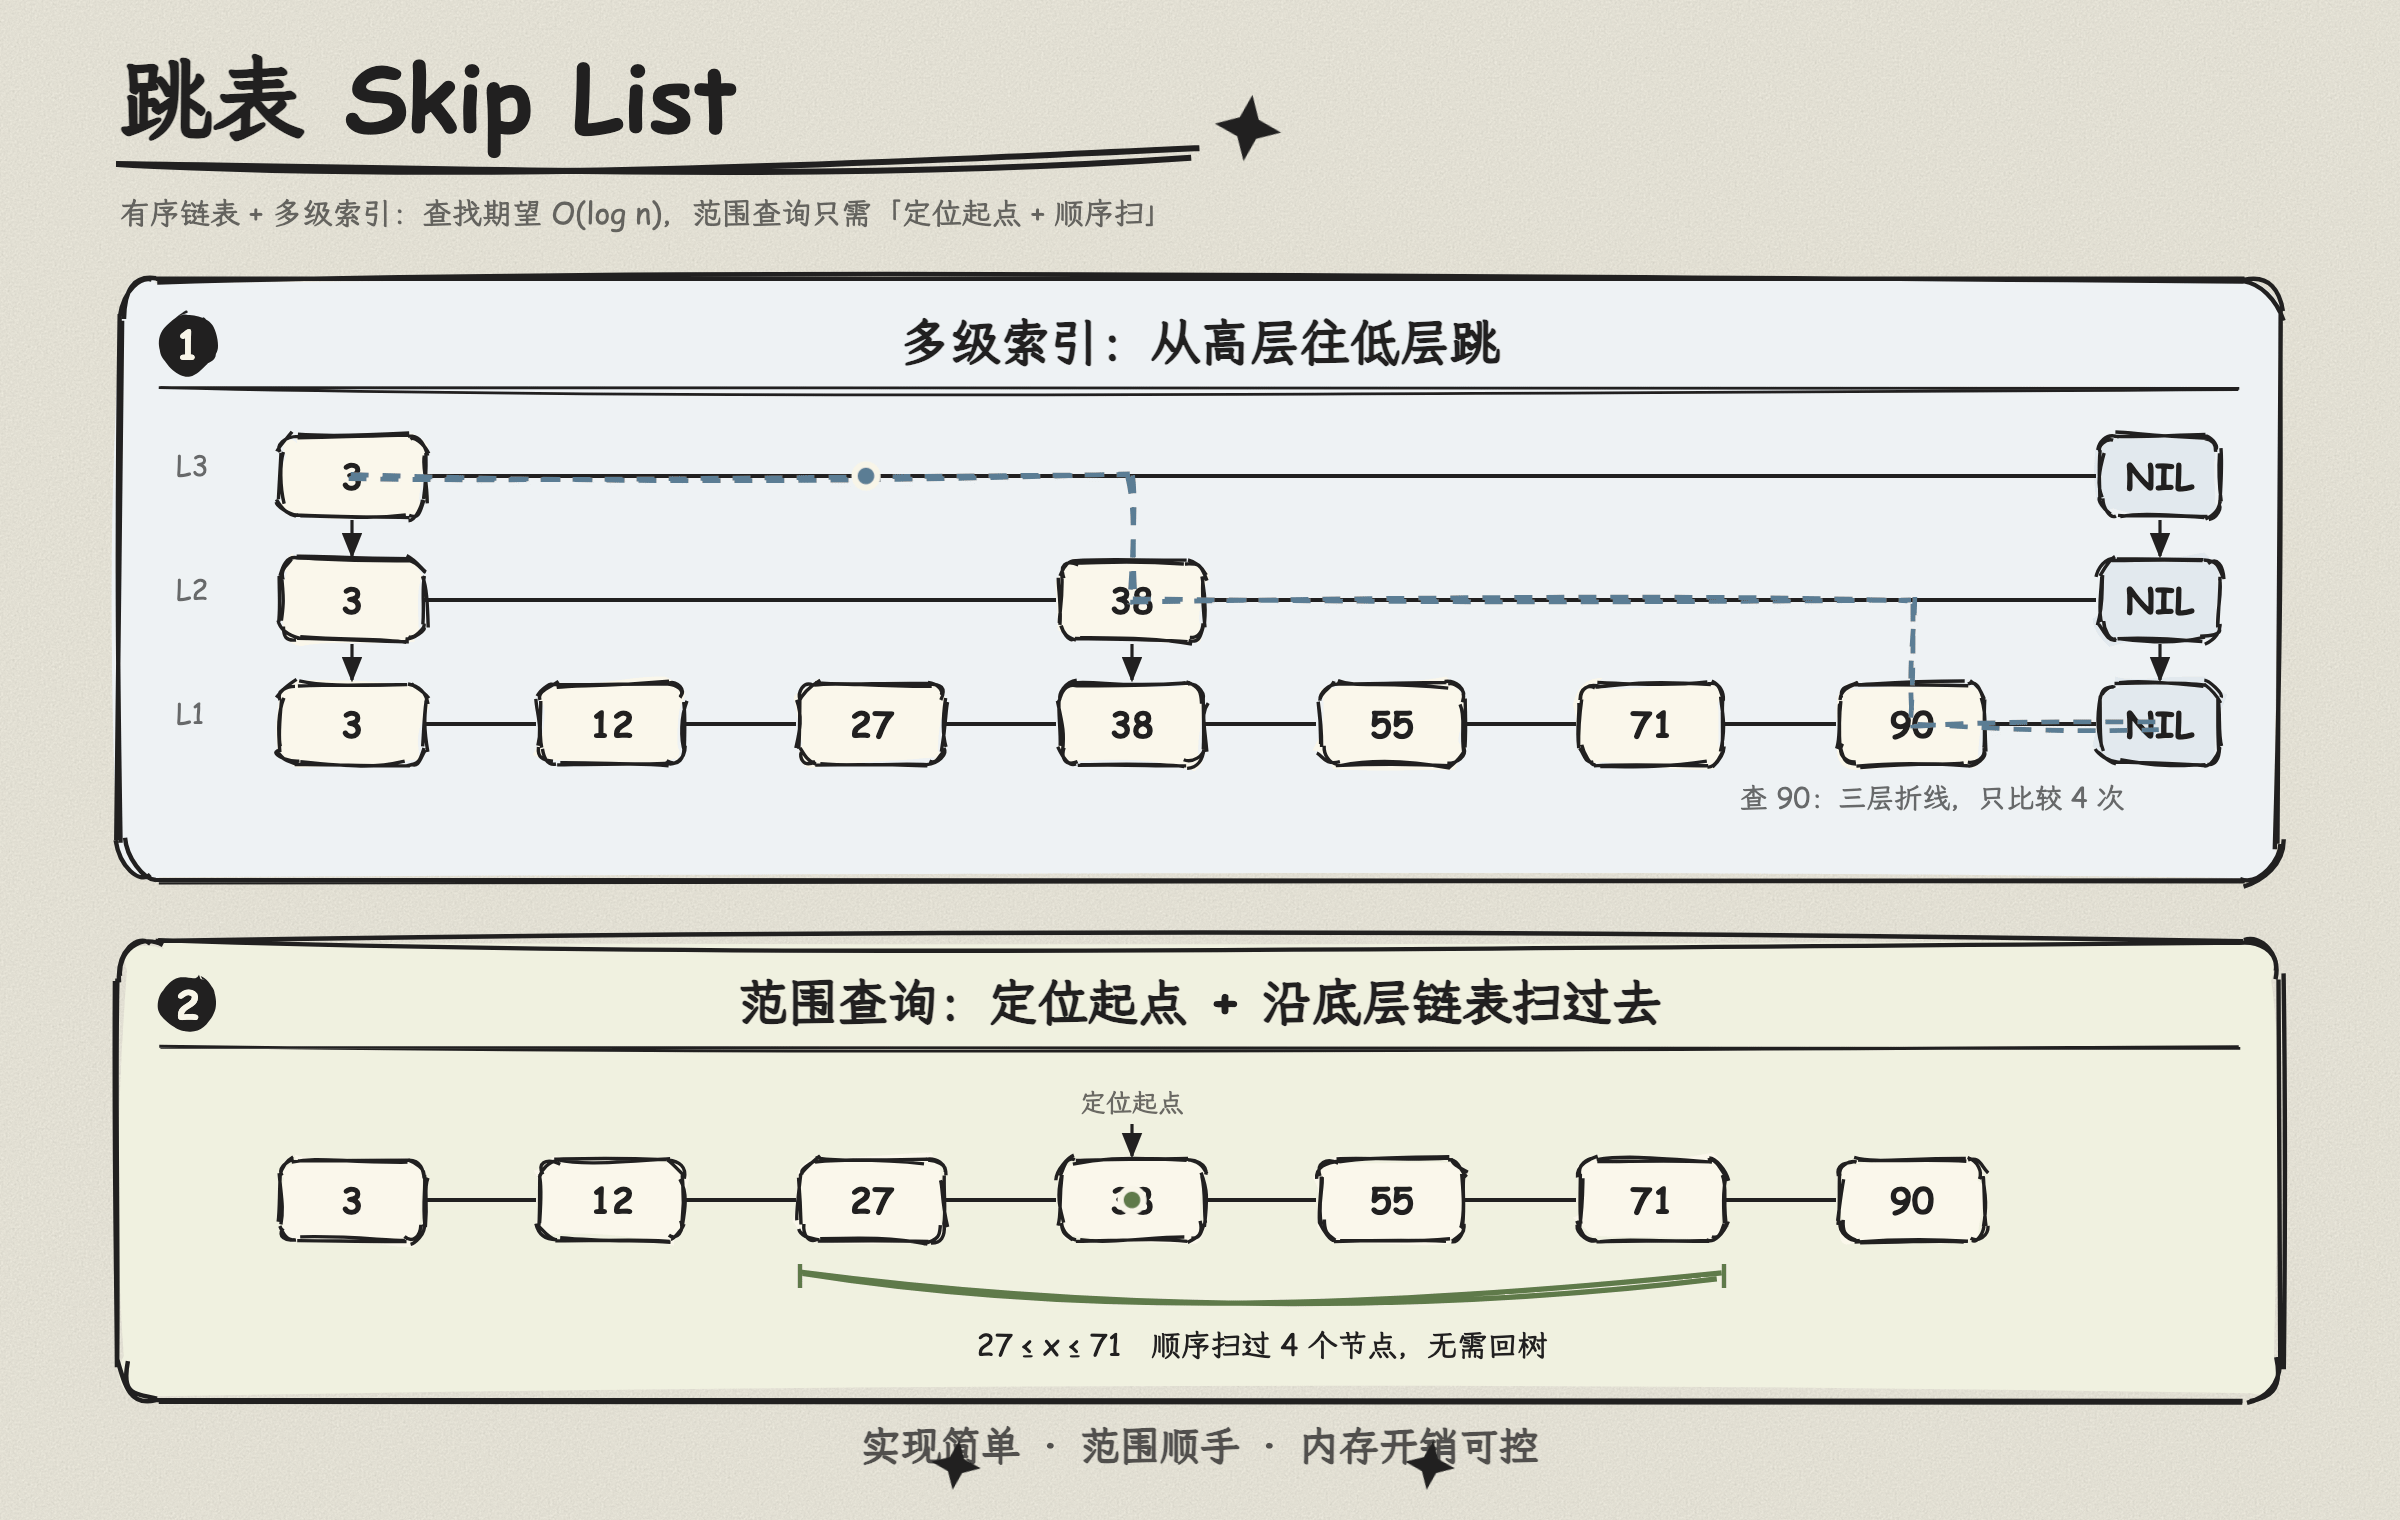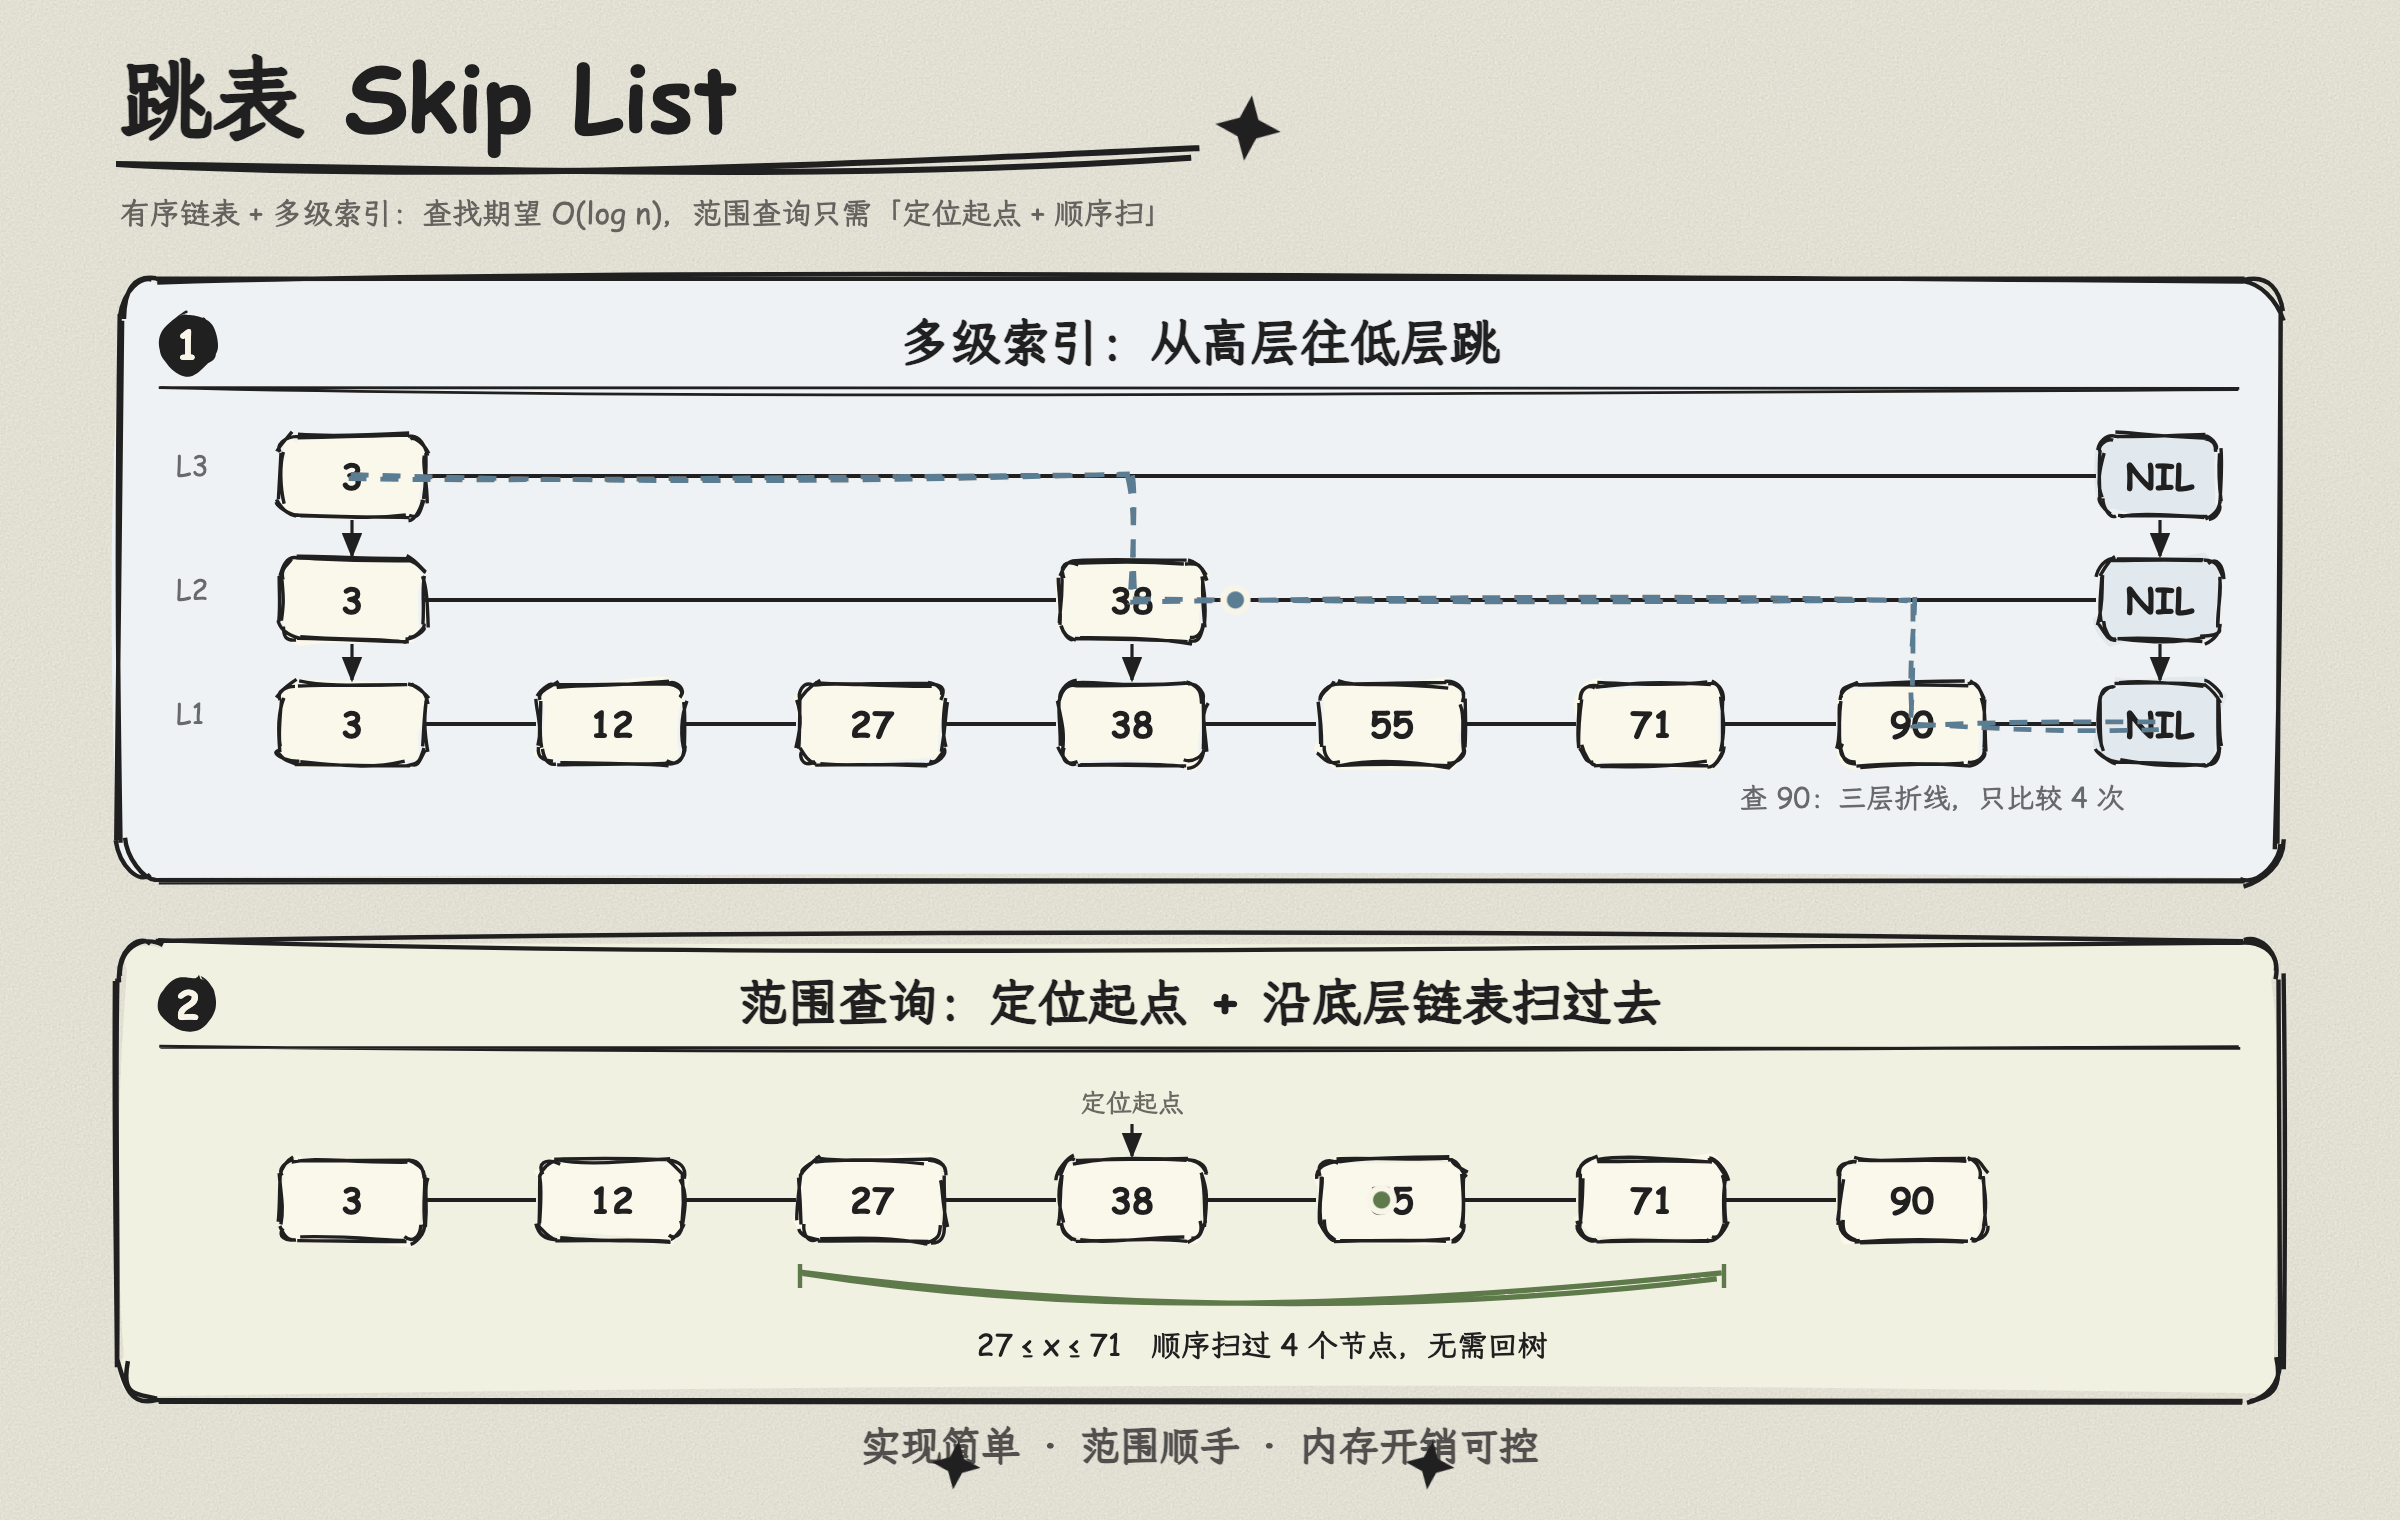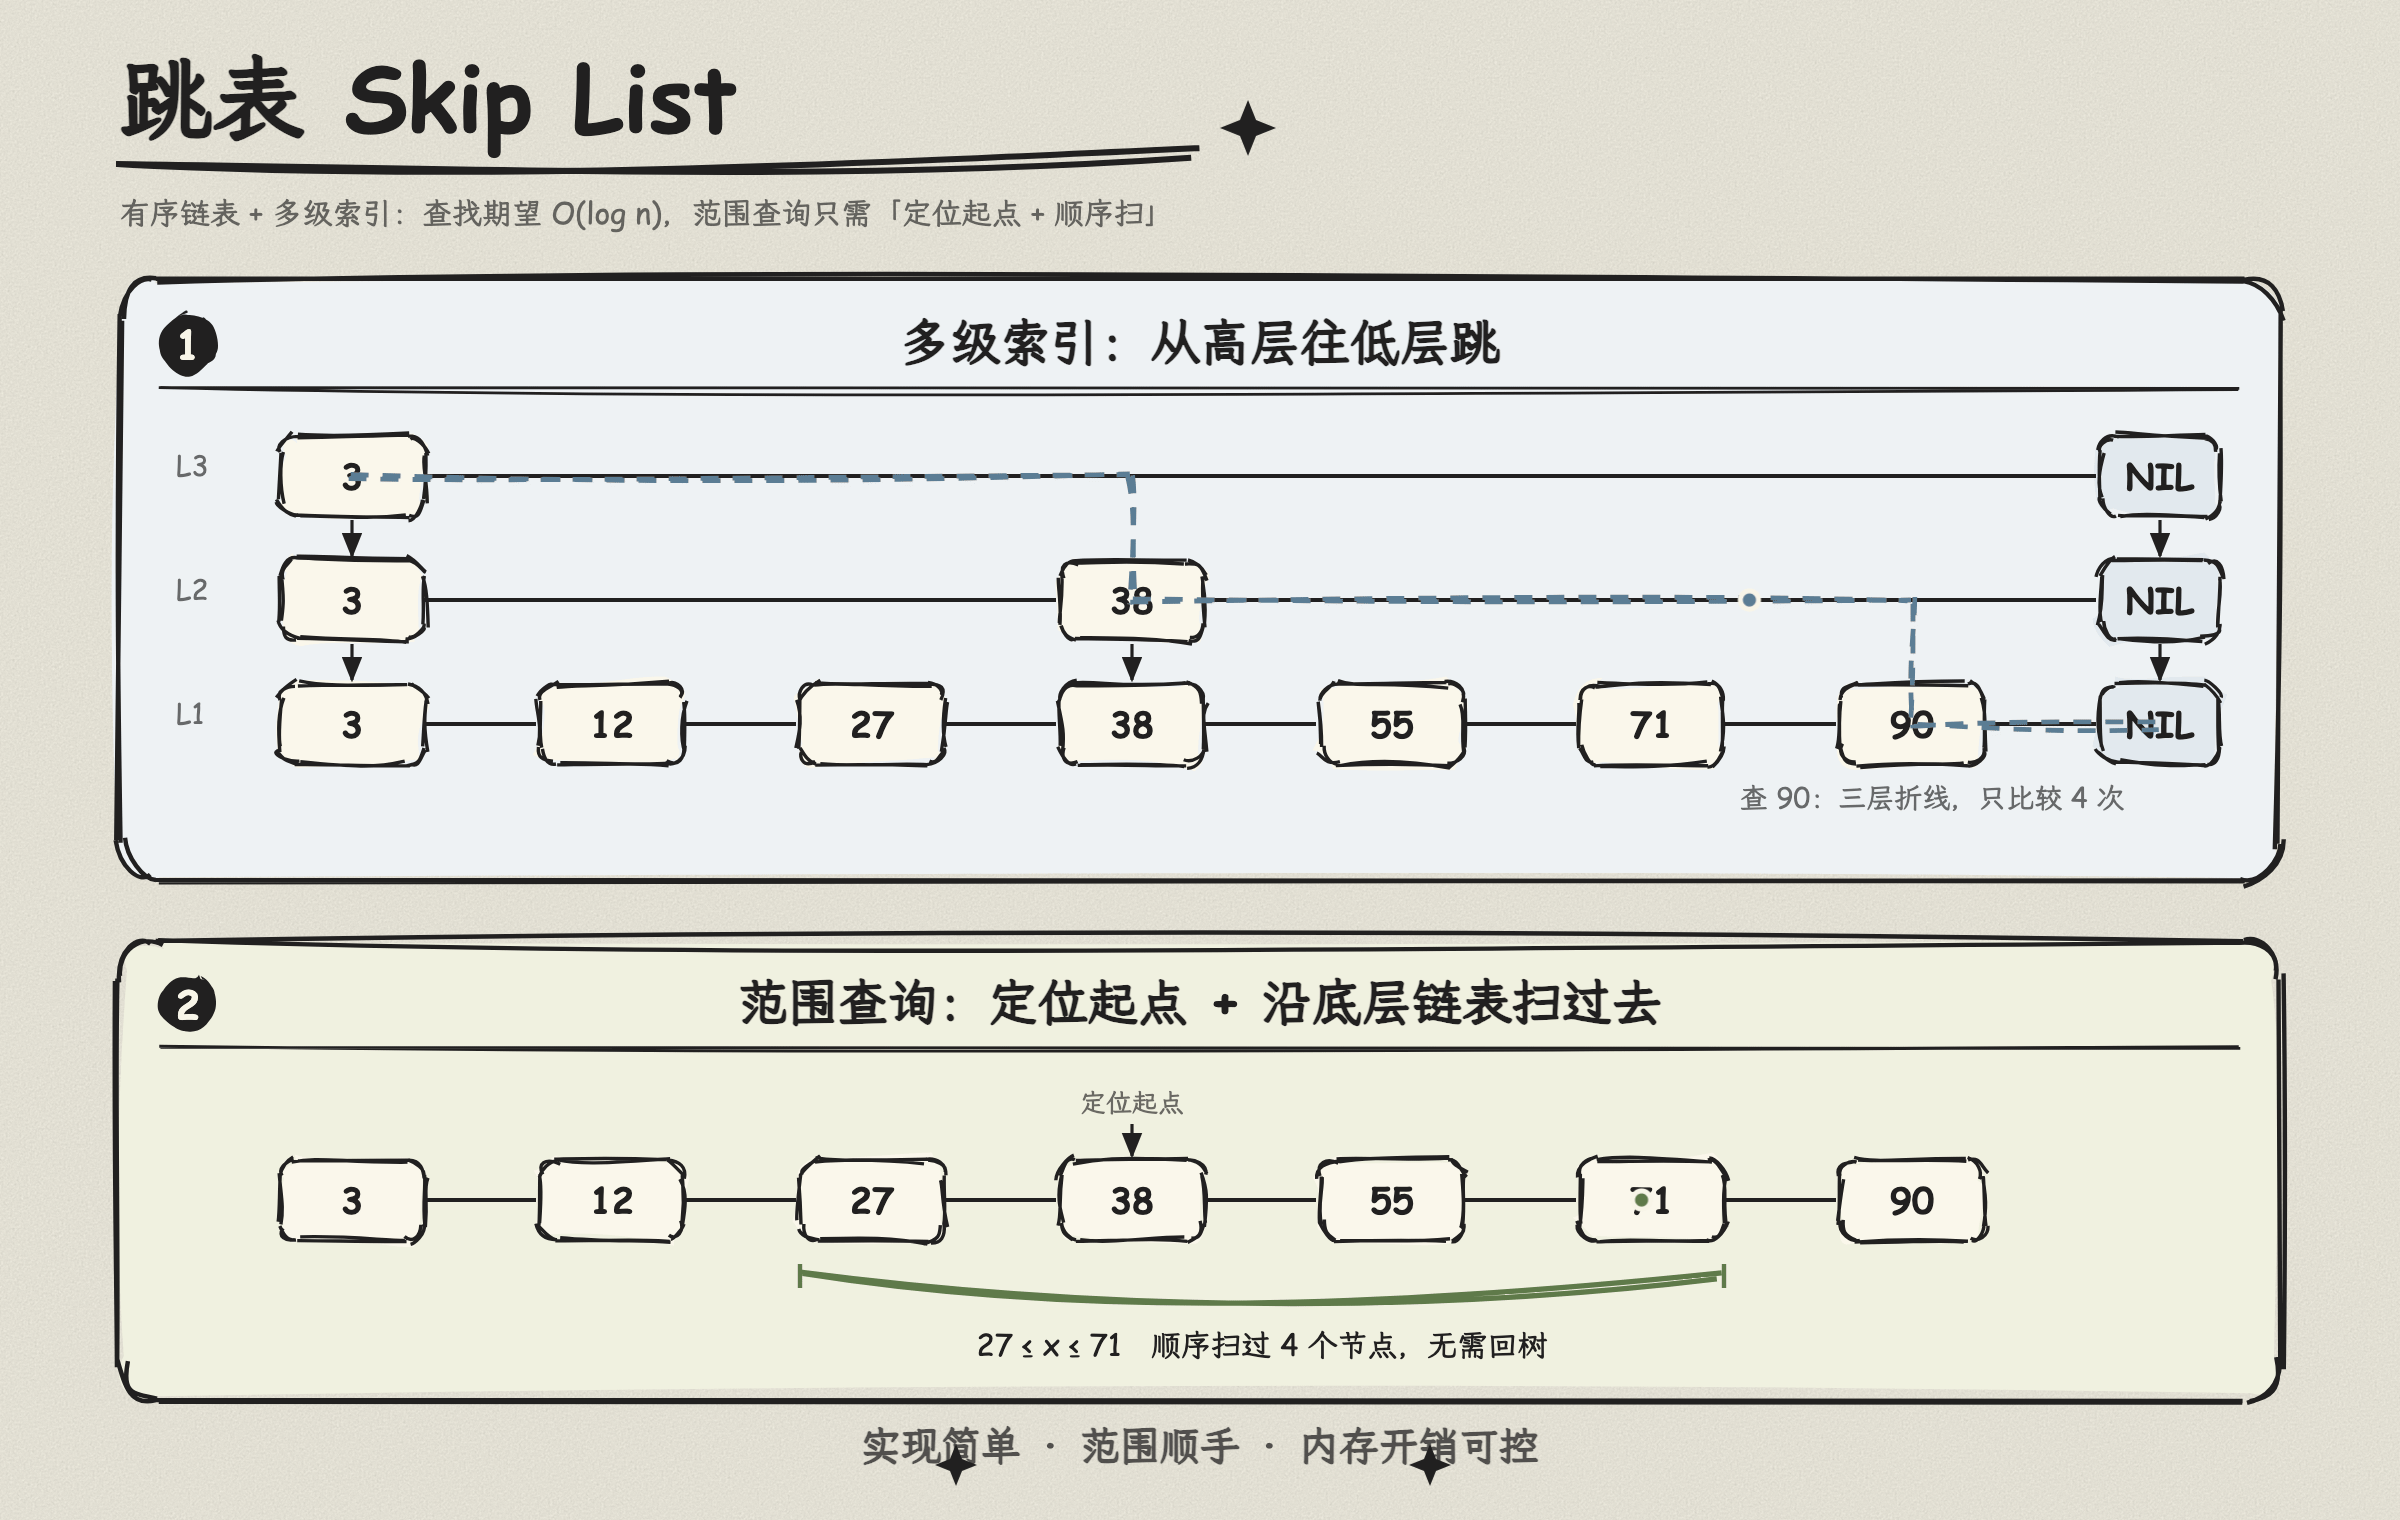
图 1:跳表的两件事。上半部分是一条三层索引链,查找 90 时从 L3 一路往右下跳,折线只比较 4 次就命中;下半部分是范围查询,先用索引定位到区间起点,再沿底层有序链表一路扫过去。
跳表真正的竞争力,不在理论复杂度,而在工程上的“刚刚好”:
- 实现比平衡树简单得多。红黑树插入删除要旋转、变色,跳表只改指针加概率建层;范围查询上,跳表沿底层链表直接扫,平衡树要走中序遍历(递归或显式栈)。对于需要自己实现或维护数据结构的系统来说,这是一个被低估的优势。
- 局部修改、读路径易无锁化。这在
ConcurrentSkipListMap这类并发容器里是实打实的优势。不过要注意,Redis ZSet 和 LevelDB MemTable 选跳表的主因并不是并发——Redis 命令执行本身是单线程,LevelDB 的写入也由 mutex 保护——而是实现简单 + 范围遍历顺手 + 内存开销可控。 - 内存场景下 B+ 树的优势用不上。B+ 树为磁盘 I/O 做的所有优化(大扇出、页对齐、减少树高)在内存里都失去了意义。内存里一次指针跳转和一次数组访问的差距,远小于磁盘寻道和顺序读的差距。
Redis 的 ZSet 选跳表而不是 B+ 树或红黑树,逻辑就在这里:数据在内存,需要按 score 排序和范围取,跳表实现简单、范围查询顺手、内存开销可控。
一句话:内存 + 有序 + 范围查询,跳表是那个“没有明显短板”的选择。
三、B+ 树:为磁盘 I/O 而生,但有前提
B+ 树的所有设计,都指向同一个目标:把磁盘 I/O 次数压到最低。
它的关键特征:
- 非叶子节点只存 key,不存数据。这让每个磁盘页(InnoDB 默认 16KB)能塞下几百上千个索引项,扇出极高,树很矮。几百万行数据,树高通常只有 3~4 层。
- 数据全在叶子节点,叶子之间用链表串起来。范围查询和全表扫描变成沿着叶子链表顺序读,磁盘顺序读的性能远高于随机读。
- 节点大小对齐磁盘页。每次读一个节点就是读一个页,不浪费,也不多读。
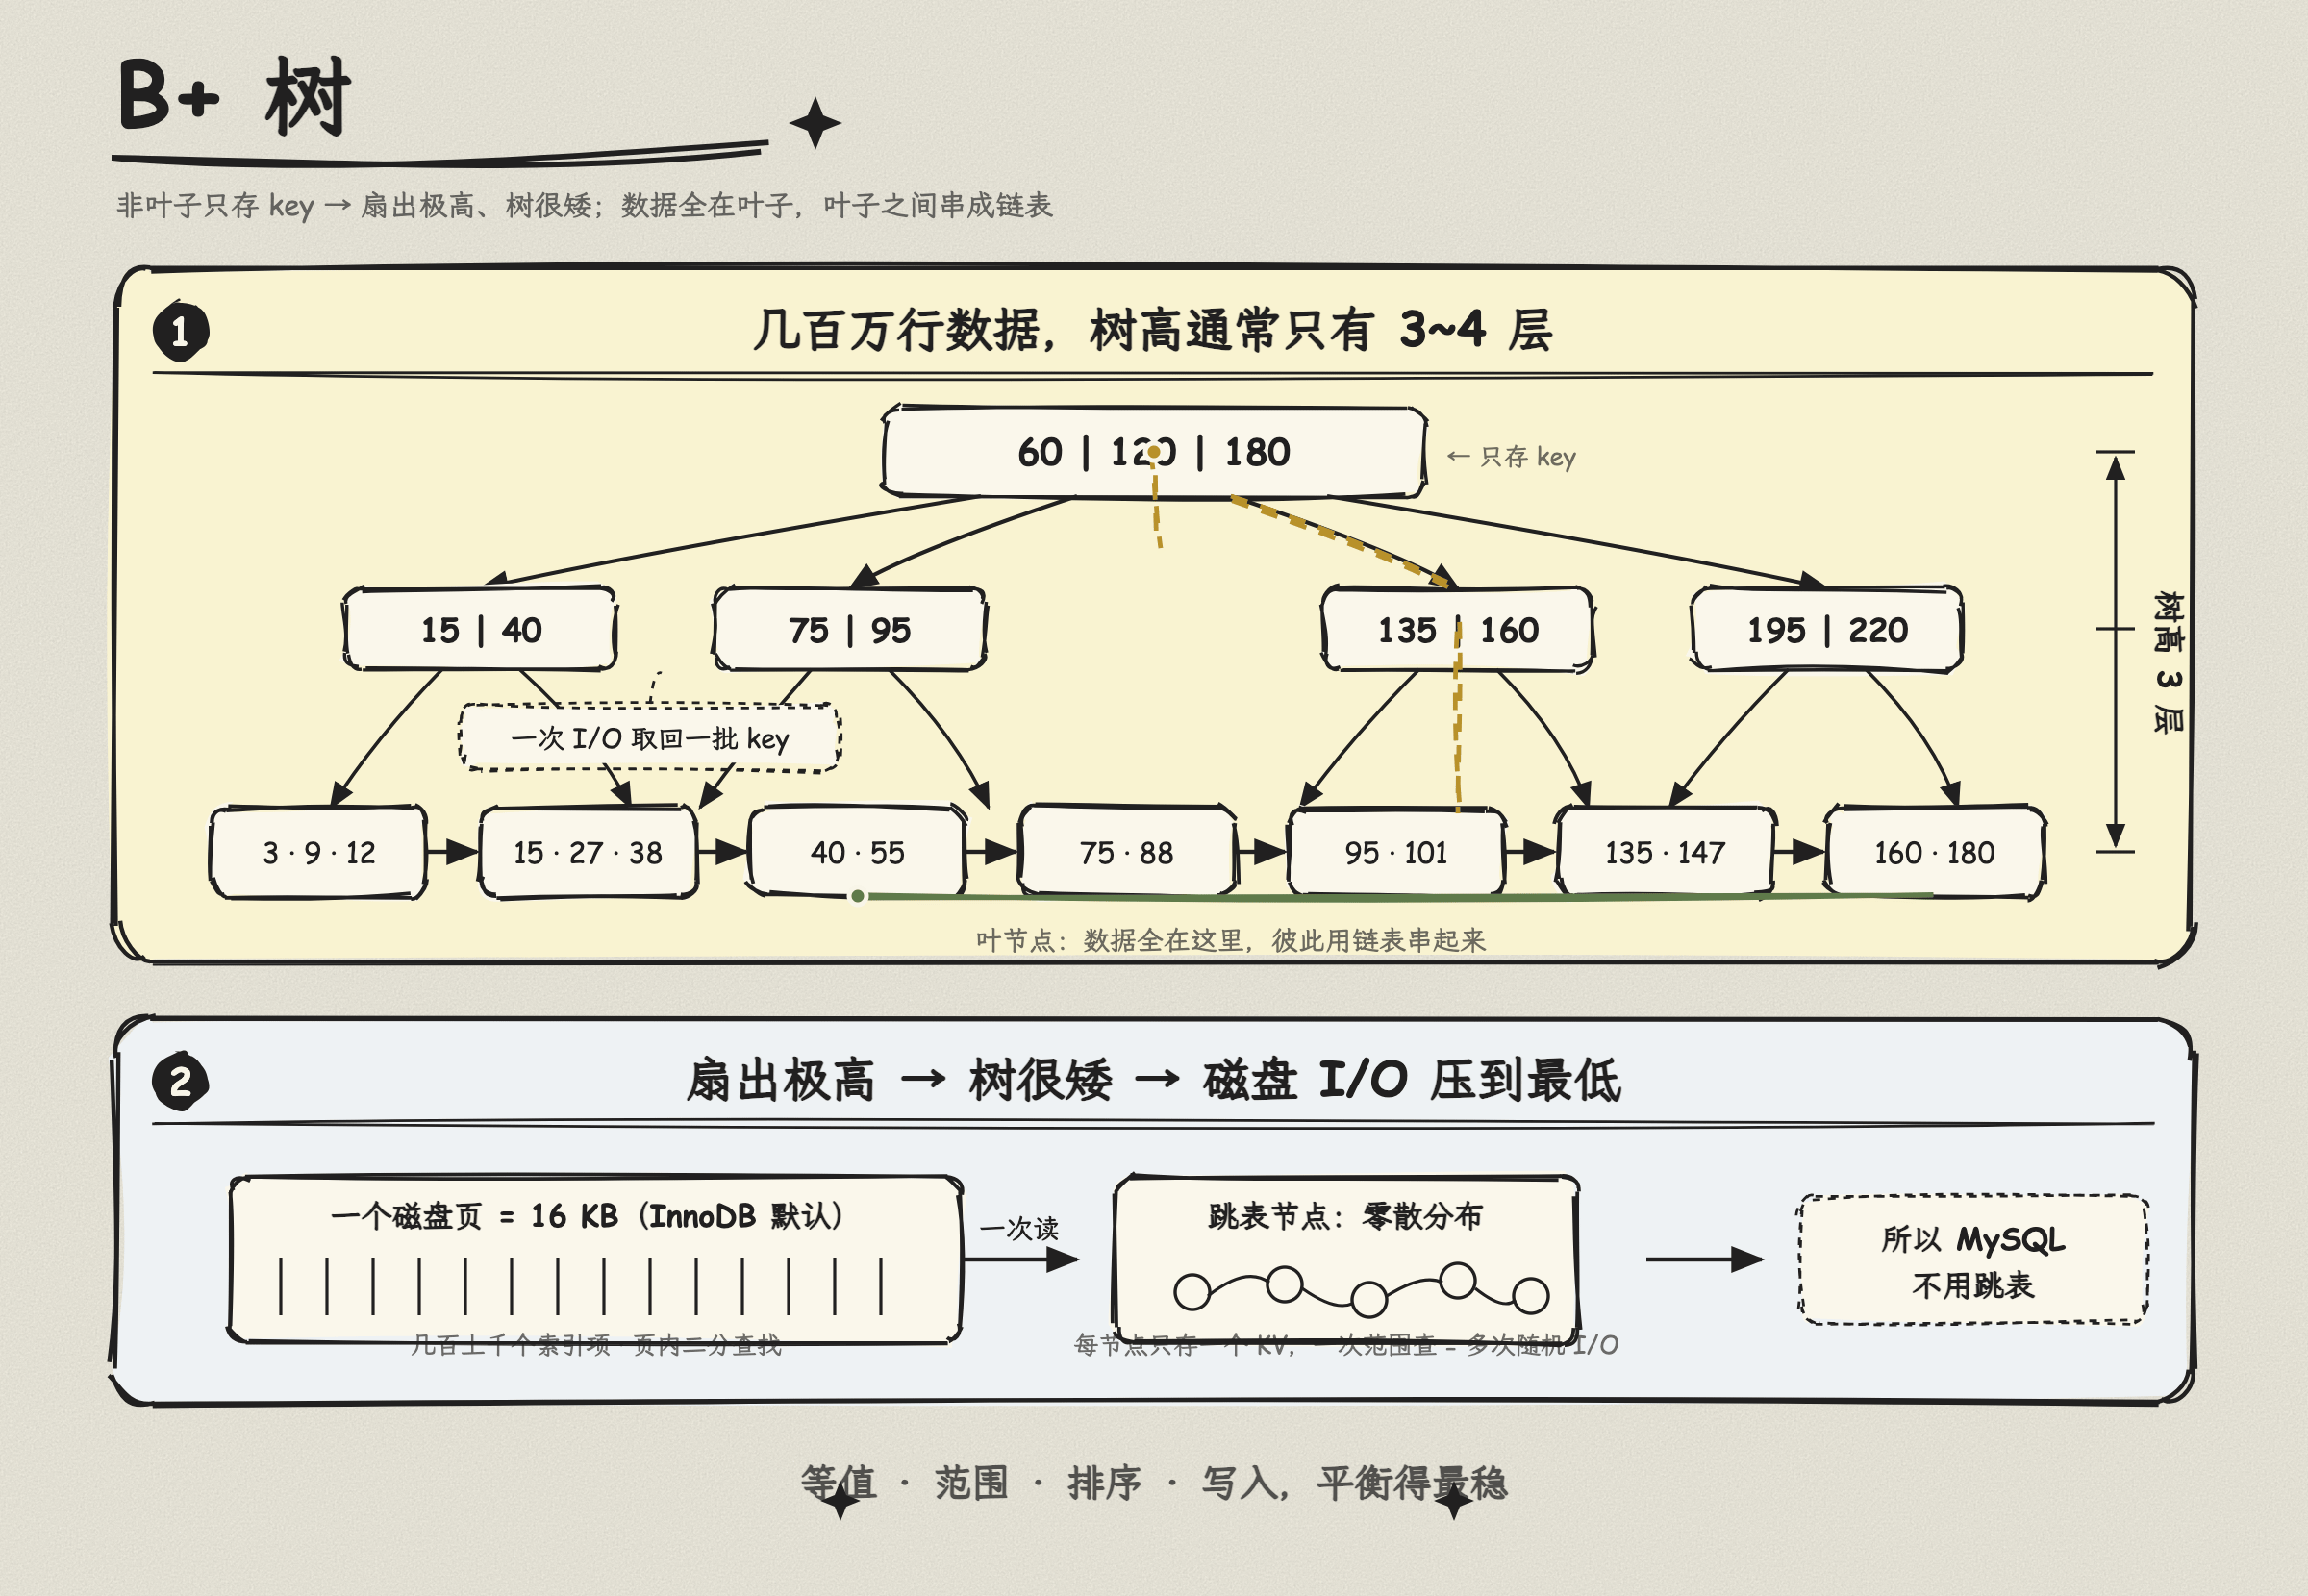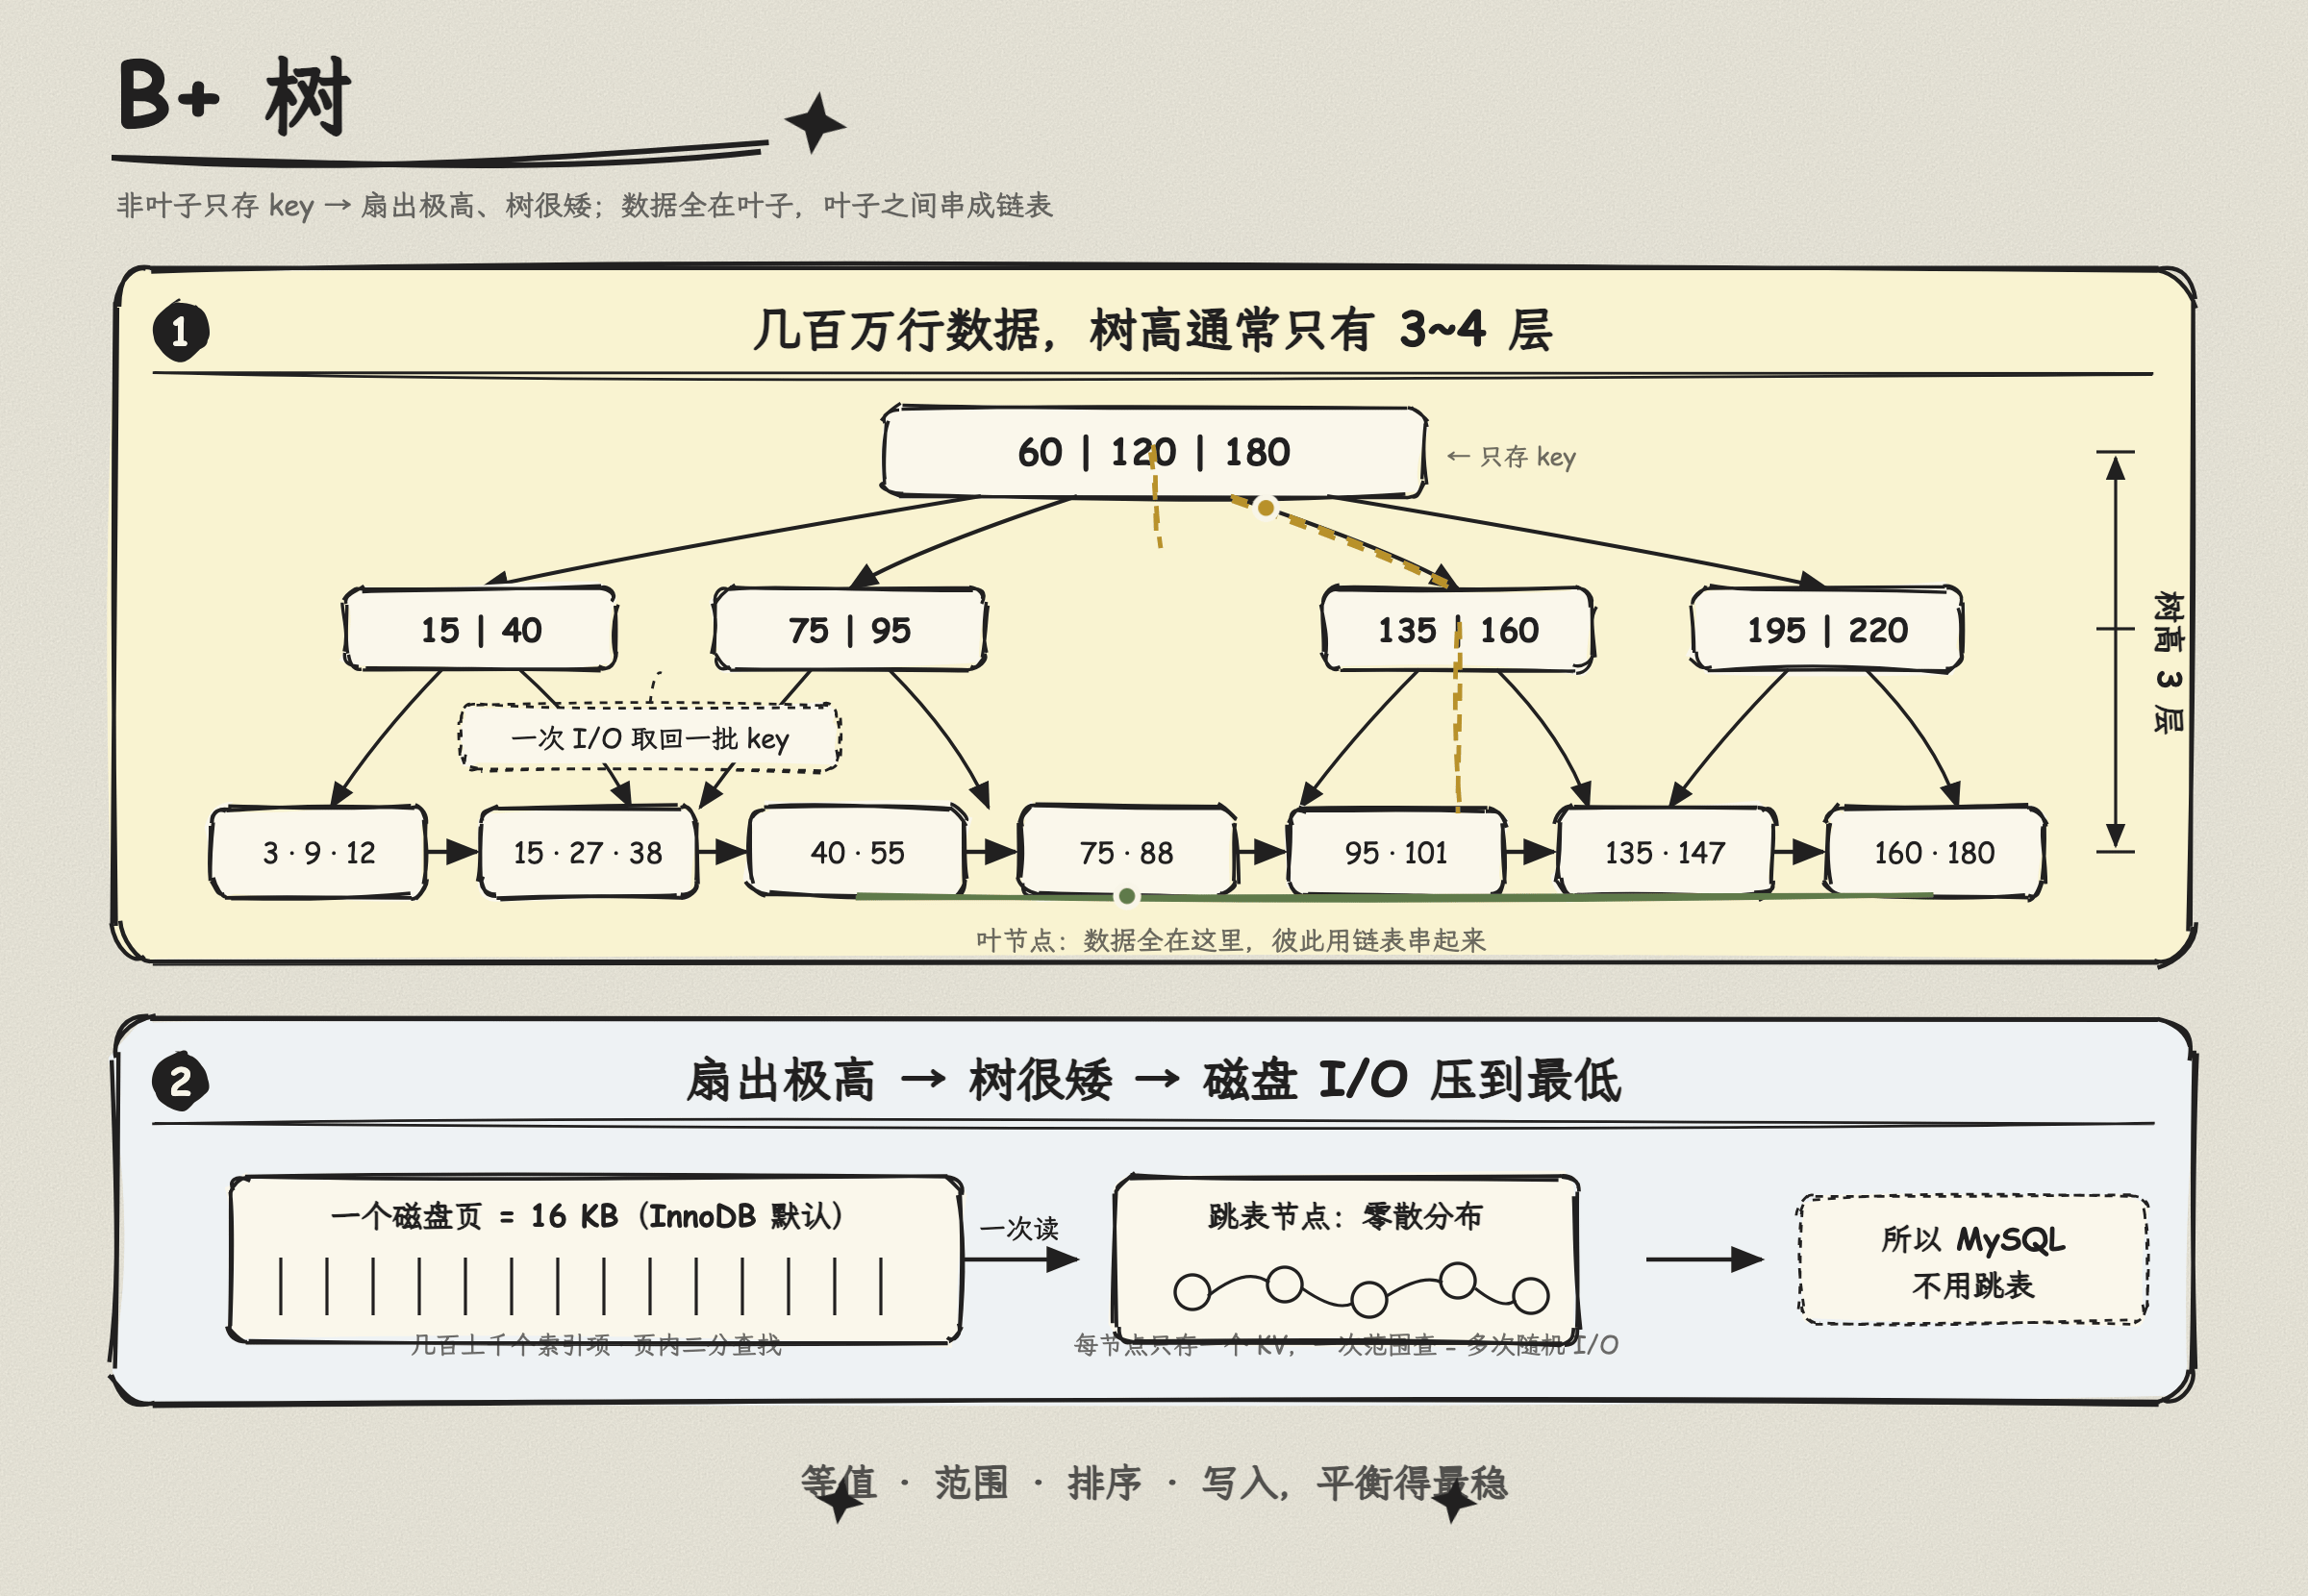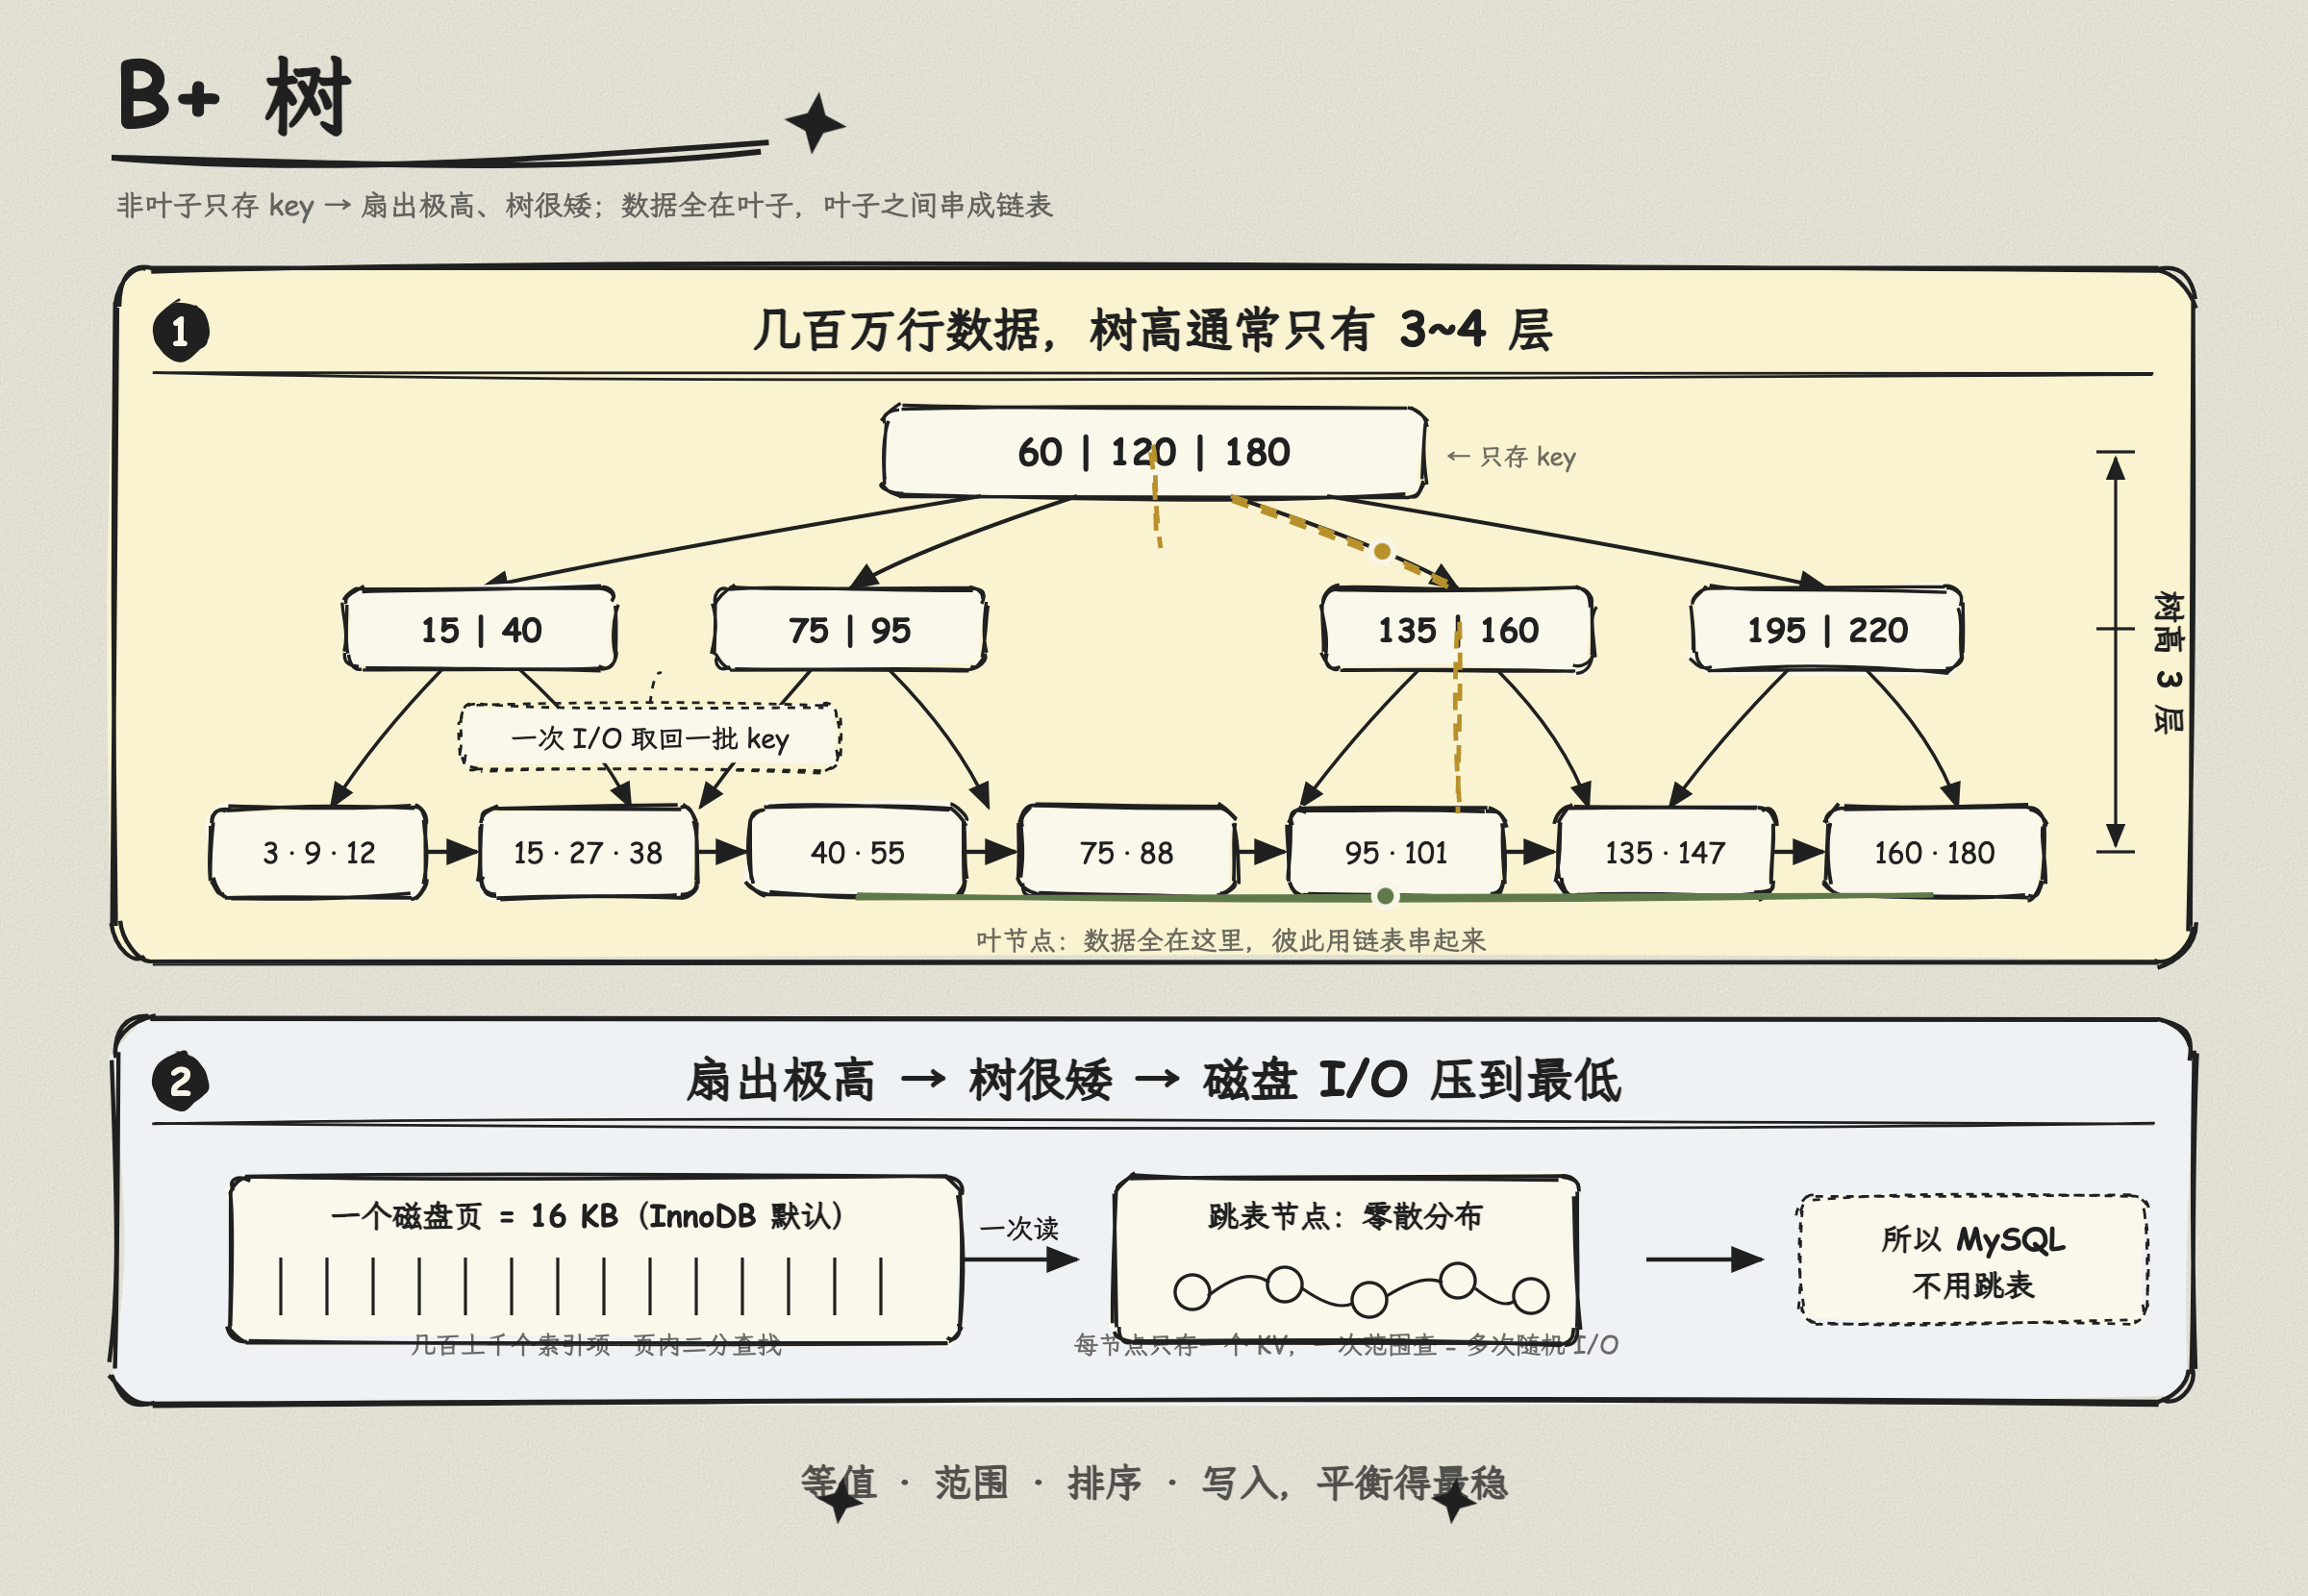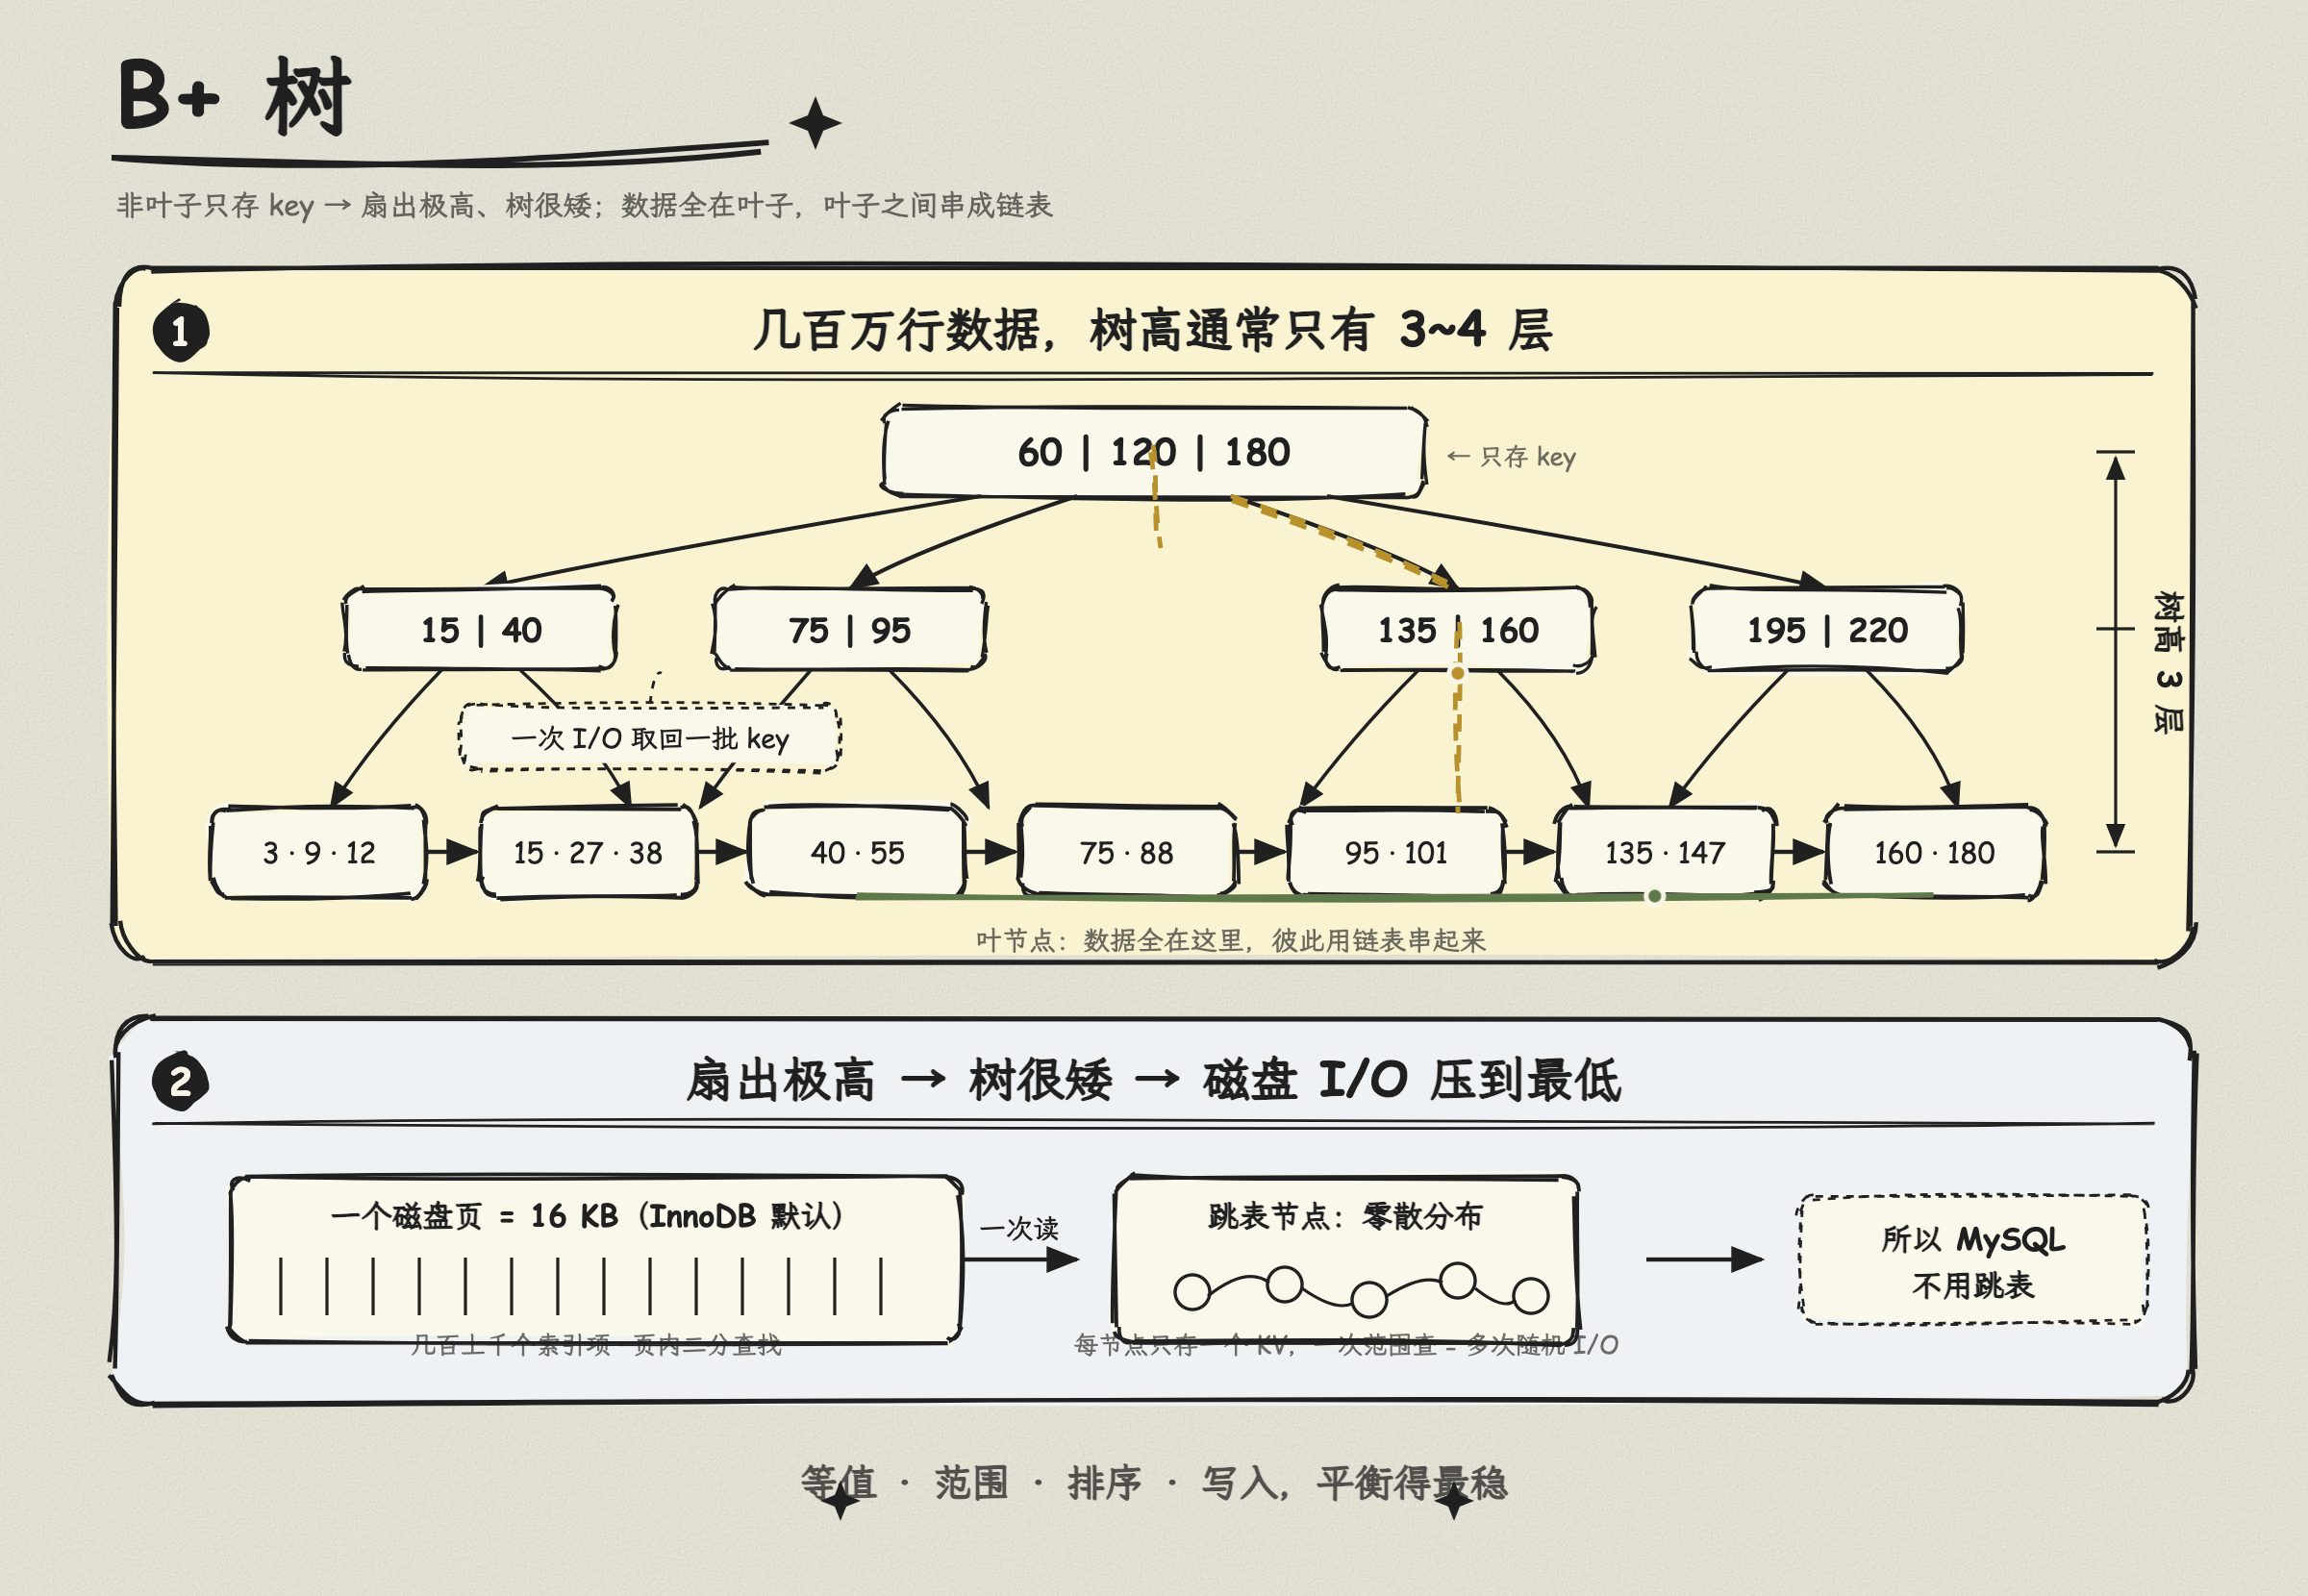
图 2:B+ 树为什么磁盘友好。非叶子节点只存 key,所以一个 16KB 的页能塞下几百上千个索引项,扇出极高、树只有三层。数据全部落在叶子层,叶子之间用链表串起来——等值查询沿左侧虚线走「根 → 内部节点 → 叶子」,范围查询则沿底部绿色箭头在叶子链表上顺序扫。右下角对比了跳表:节点零散分布、每节点只存一个 KV,放到磁盘上一次范围查询就是多次随机 I/O。
关于 I/O 次数还要补一句:B+ 树的根节点和上层节点通常常驻 buffer pool,实际查询的磁盘 I/O 往往只有 1 到 2 次,比“树高 3 到 4 层”更乐观——树高是上界,不是每次查询都要走满。
代价同样明确:随机写、页分裂、写放大。这正是 LSM-Tree 用“顺序写 + 后台合并”换“读放大”的动机——那是另一个话题,但说明 B+ 树不是没有代价的“最优解”,而是在读写之间平衡得最稳的默认选项。
为什么 MySQL 不用跳表?因为跳表是为内存设计的。它的节点零散分布,每个节点只存一个 KV,放到磁盘上,一次范围查询可能触发大量随机 I/O。B+ 树把多个 key 打包进一个页,一次 I/O 取回一批,这才是磁盘友好的做法。
一句话:B+ 树不是“最好的”,但它是在等值、范围、排序、写入之间平衡得最稳的那个——前提是瓶颈在机械寻道或页级读取代价,而这一点在 HDD 和 SSD 上并不完全相同。
四、磁盘要分 HDD 和 SSD:瓶颈变了,结论要微调
把“磁盘”笼统当成一个东西,会掩盖一个关键事实:HDD 的瓶颈是机械寻道,SSD 的瓶颈是闪存写放大和擦除块约束。B+ 树的大扇出和页对齐是为前者设计的;面对后者,它仍然可用,但需要正视新问题,而 LSM-Tree 在某些写入场景下更具优势。
4.1 HDD:B+ 树仍然是标准答案
机械硬盘的随机访问代价极高(寻道 5–50 ms,加上旋转延迟),而 B+ 树把几百上千个 key 打包进一个页,一次 I/O 取回一批,正好把“随机寻道”转化为“少量页读取 + 页内二分”。叶子链表让范围扫描变成顺序读,顺序读在 HDD 上远快于随机读。所以前面“B+ 树为磁盘 I/O 而生”的论述,主要就是针对 HDD 的,逻辑几乎不需要调整。
4.2 SSD:B+ 树可用,但有两个新问题
SSD 没有机械寻道,随机读的代价极低(页级读取只需几十微秒),这意味着“把数据打包进页以减少寻道”的收益变小了。但 SSD 有自己的麻烦:
第一,原地更新代价高。 闪存必须先擦除整个块(128–512 KB)才能覆写,而 B+ 树的节点更新往往是原地写。SSD 通过 FTL(闪存转换层)做重映射来掩盖这个问题,但代价是写放大和垃圾回收(GC)。在写入密集的场景下,B+ 树的随机小更新会持续触发 GC,拖累性能。
第二,ZNS SSD 等新形态让问题更尖锐。 传统 SSD 靠 FTL 隐藏闪存特性,而 ZNS SSD 把写入约束暴露给主机:只能顺序写、同时打开的 zone 数量有限。把未经改造的 B+ 树直接部署到 ZNS SSD 上,吞吐量会明显下降,写入次数增加——这说明 B+ 树“为块设备设计”的前提,在新型 SSD 上并不自动成立。
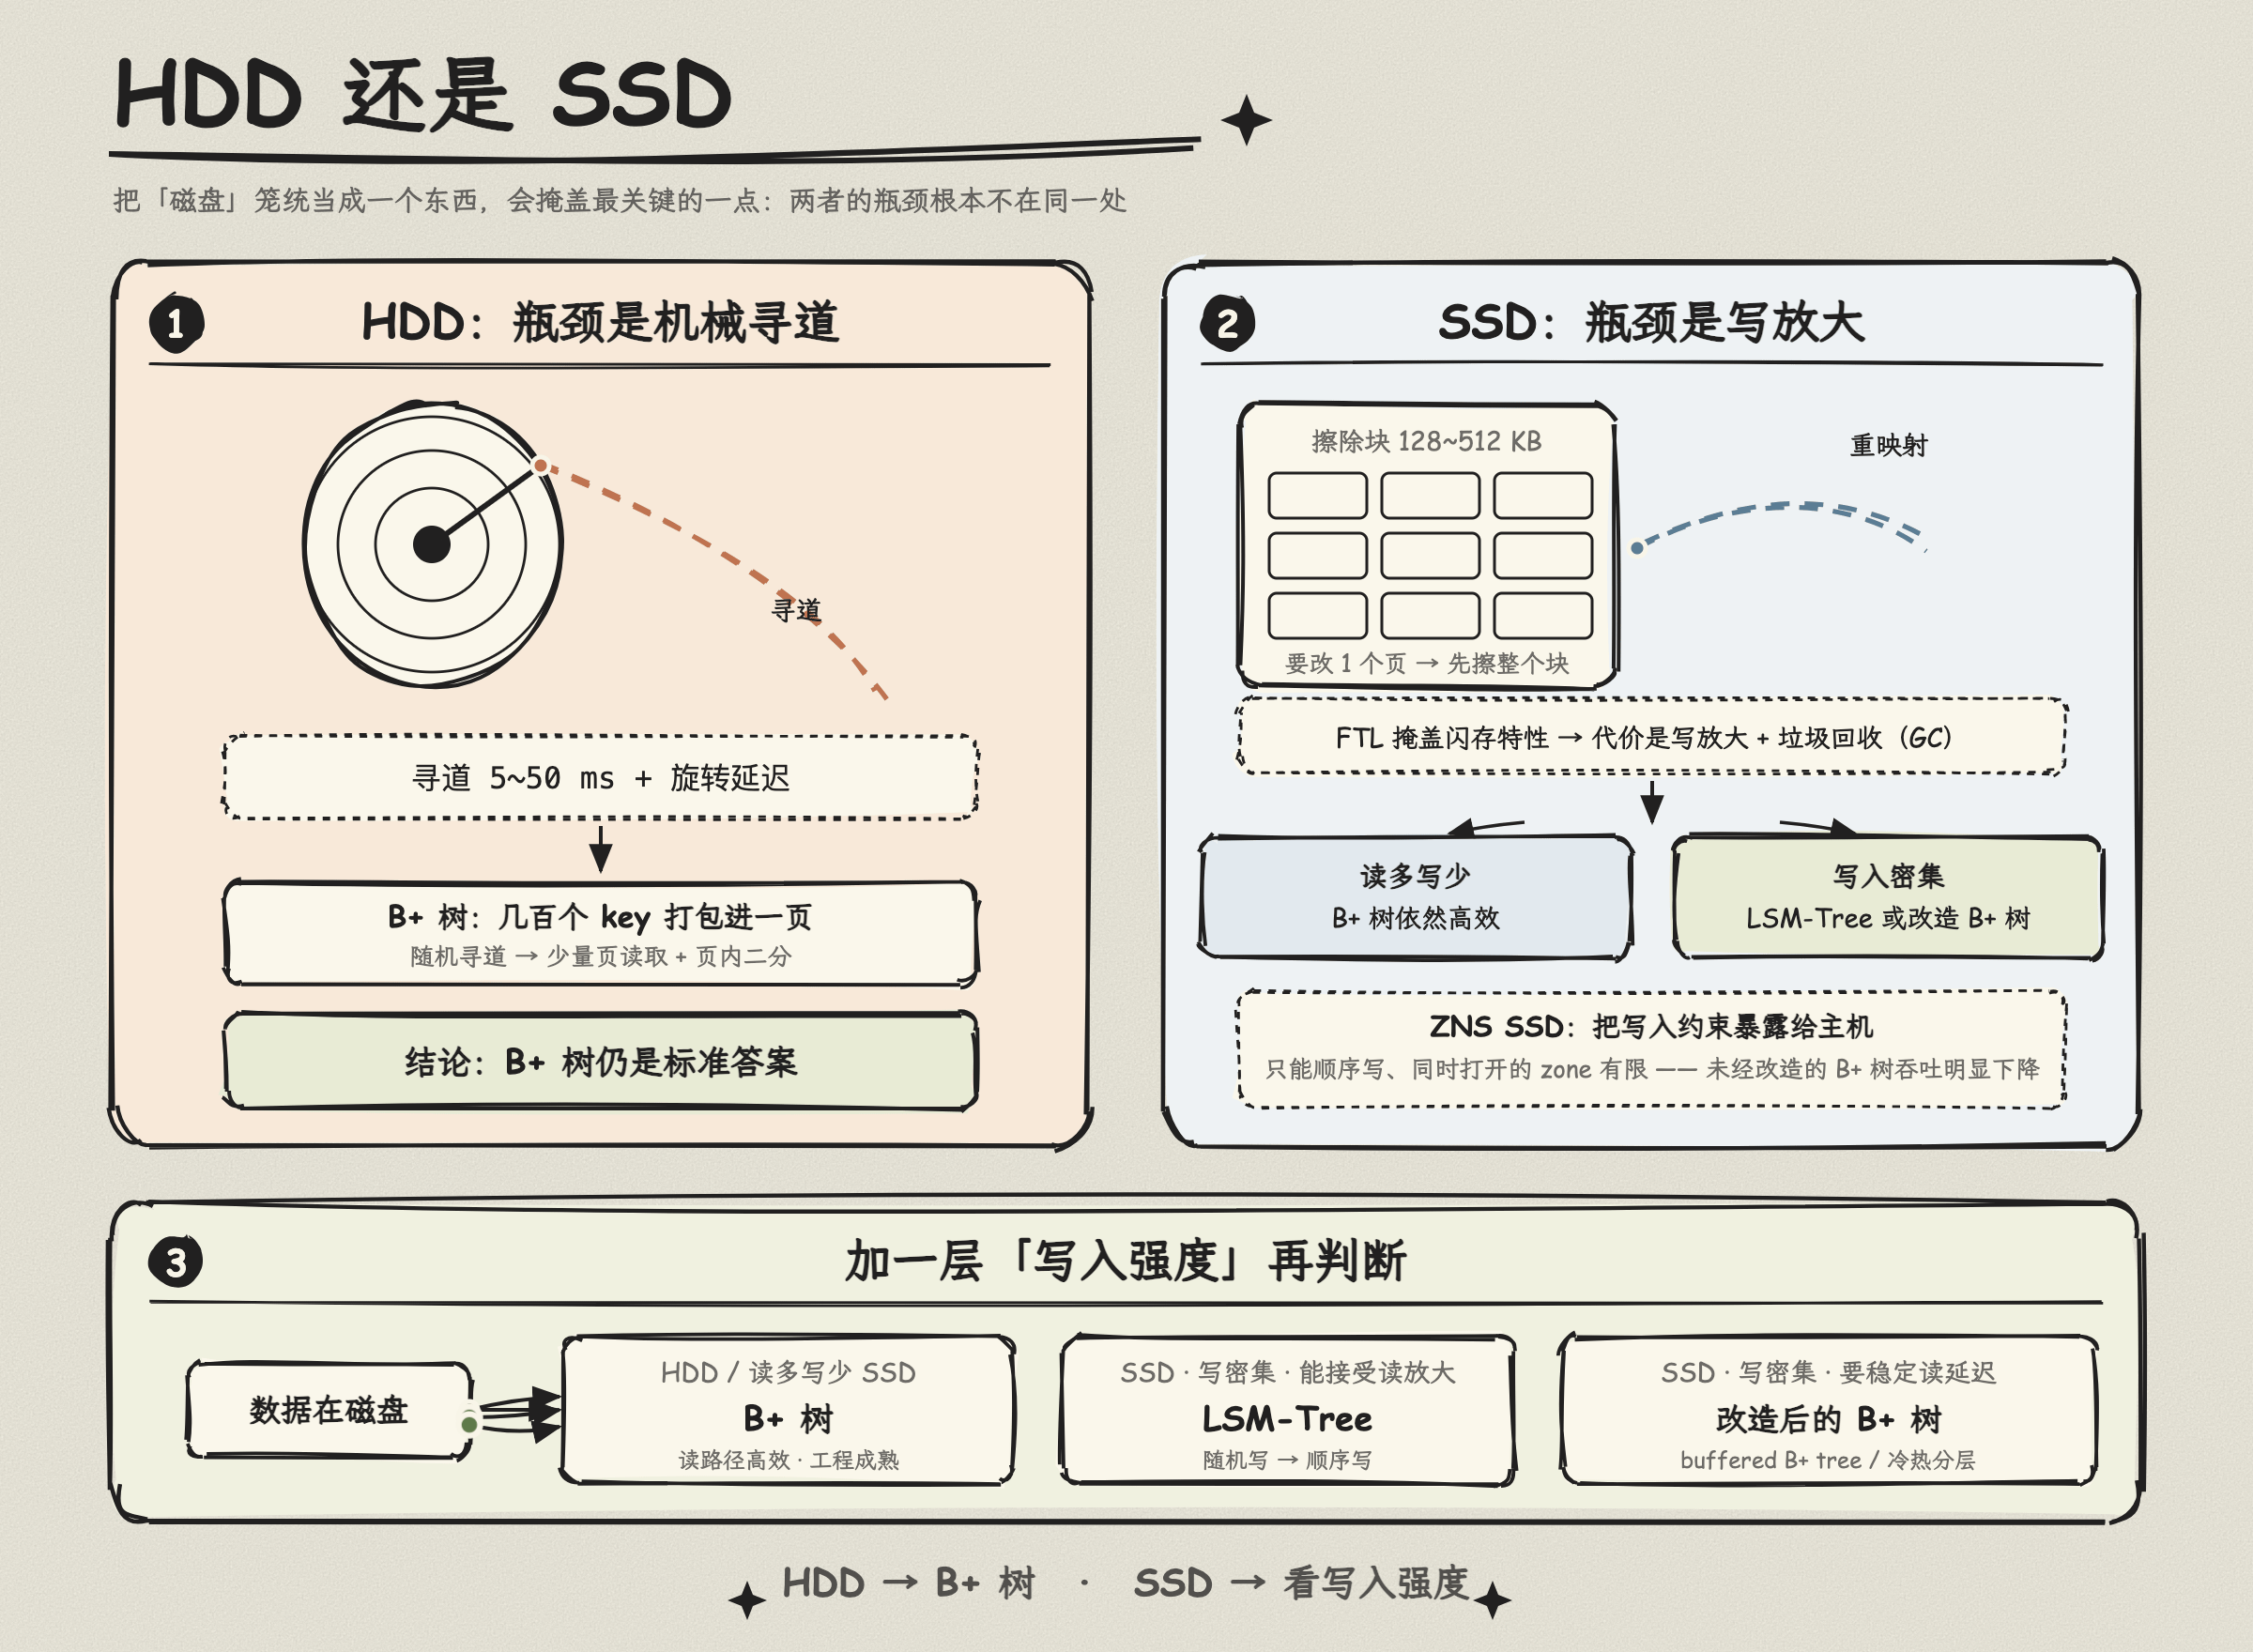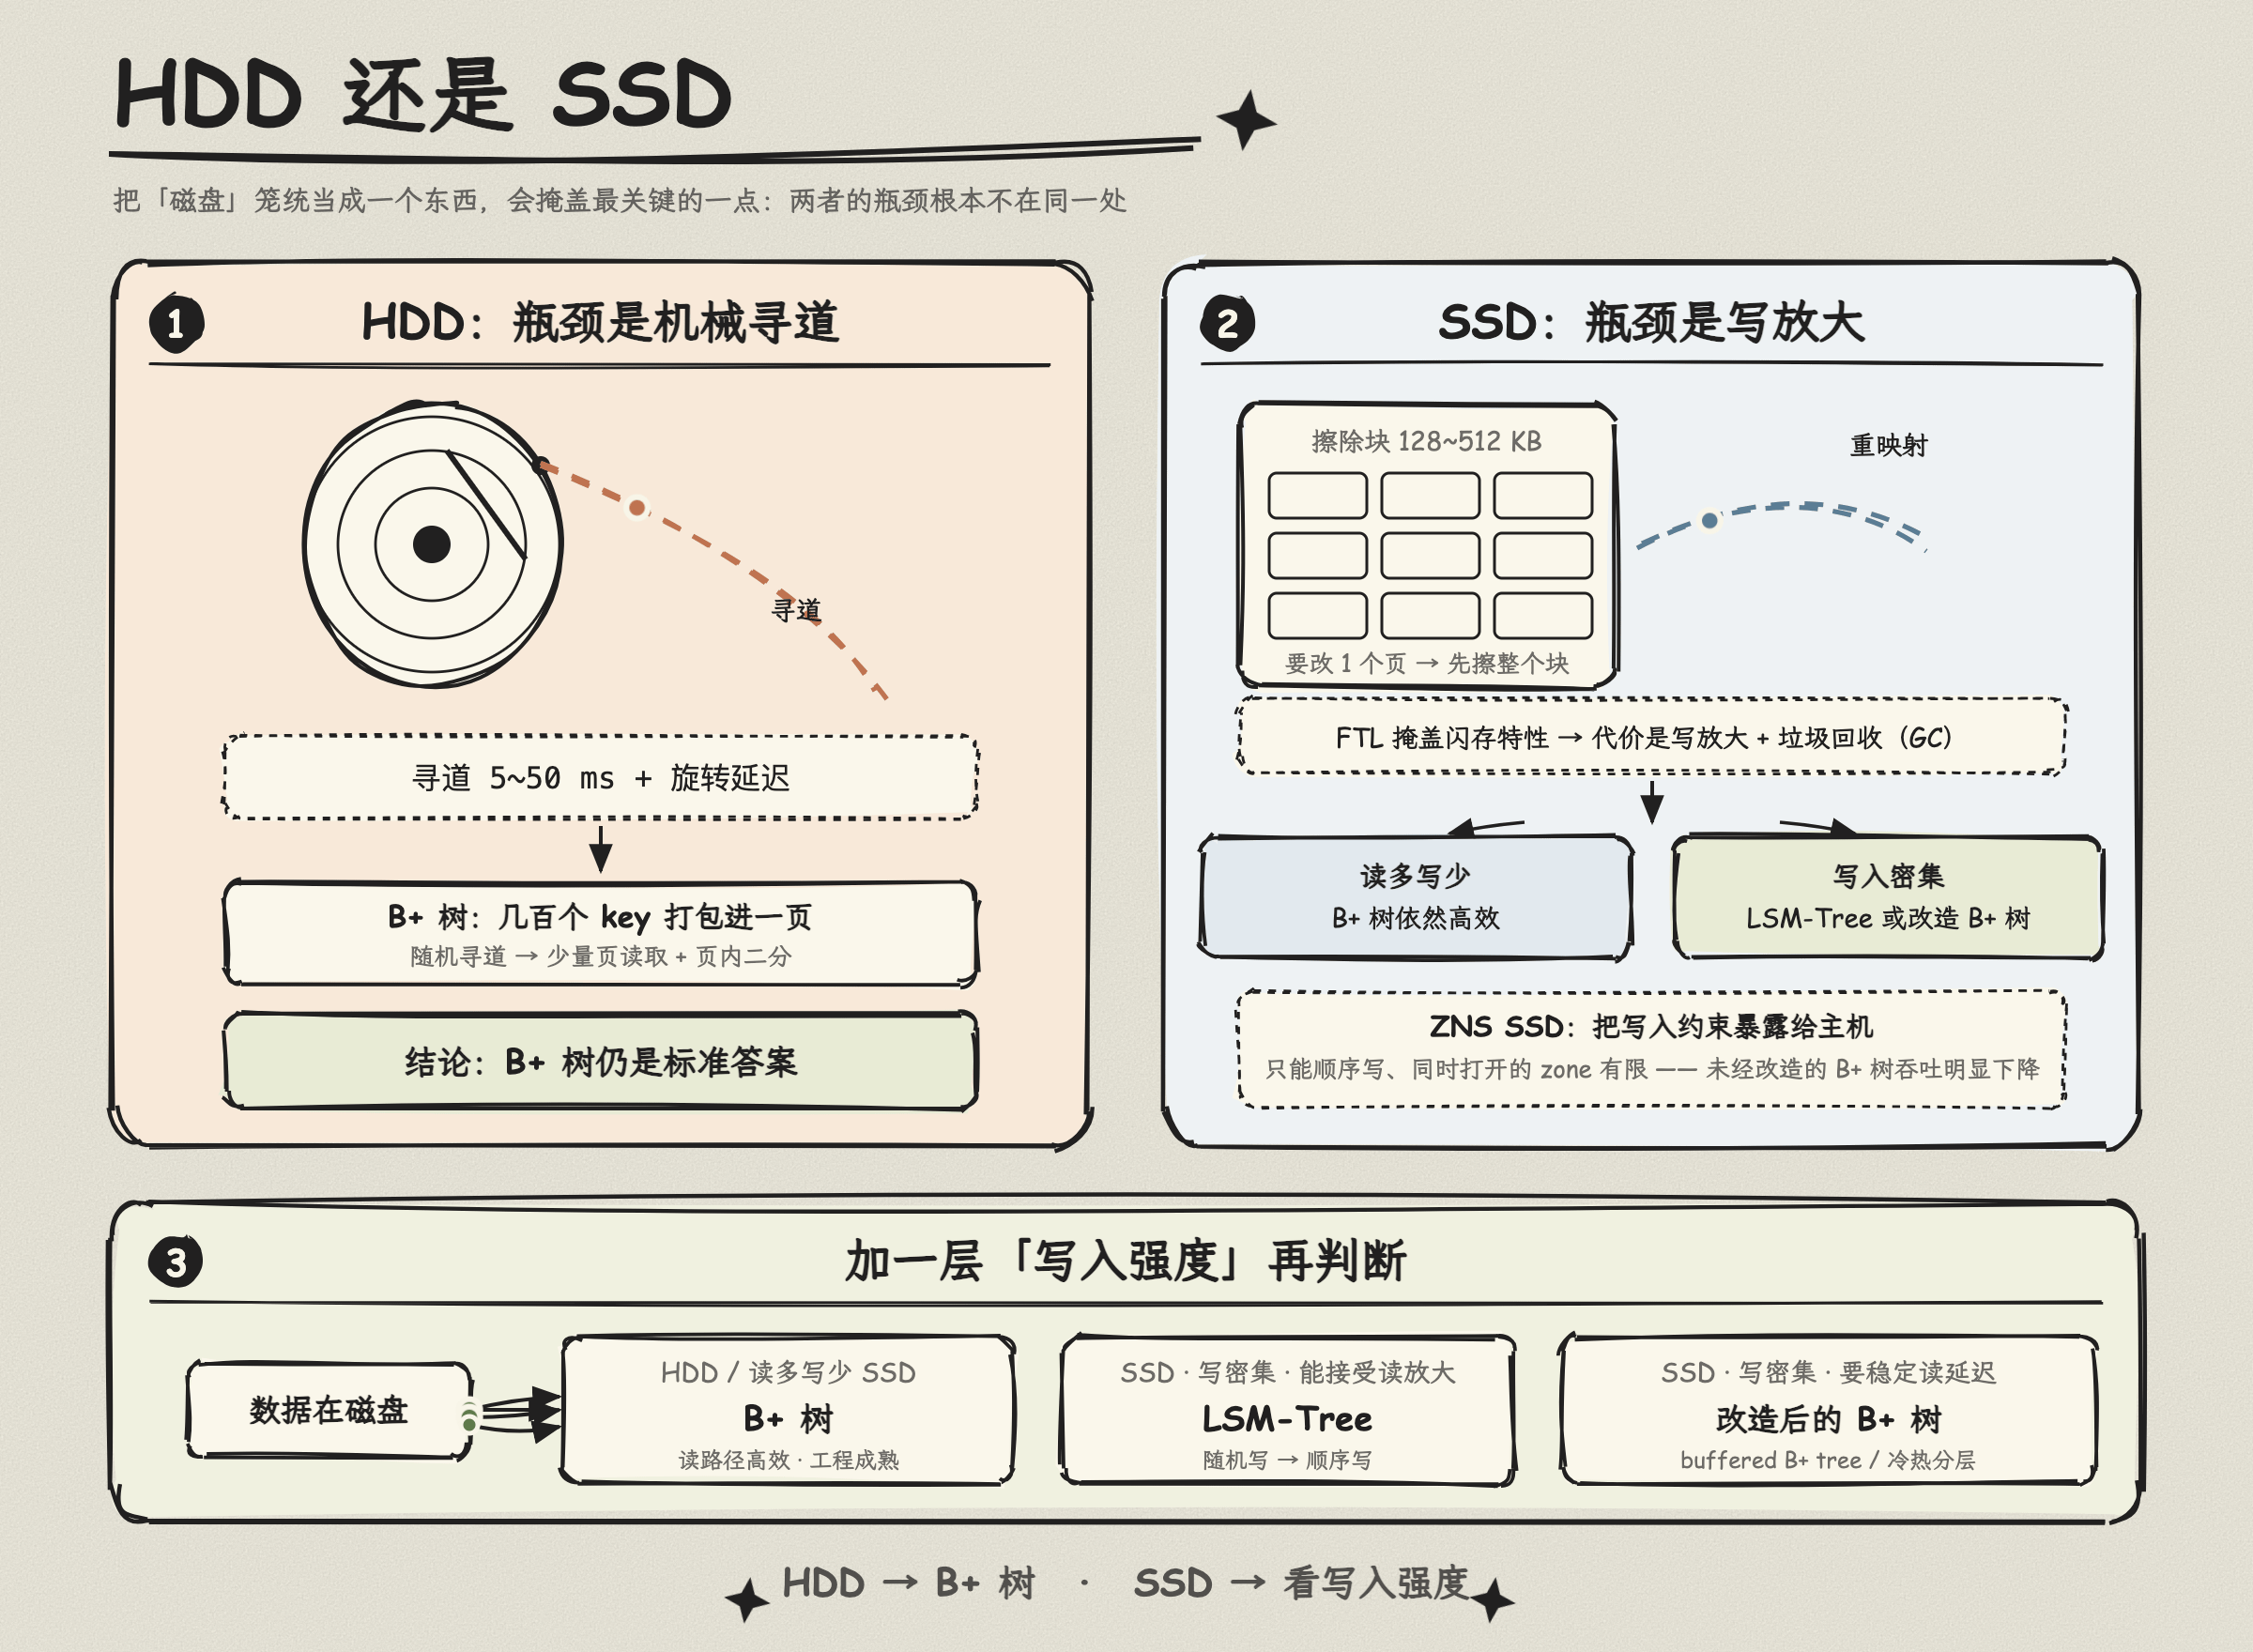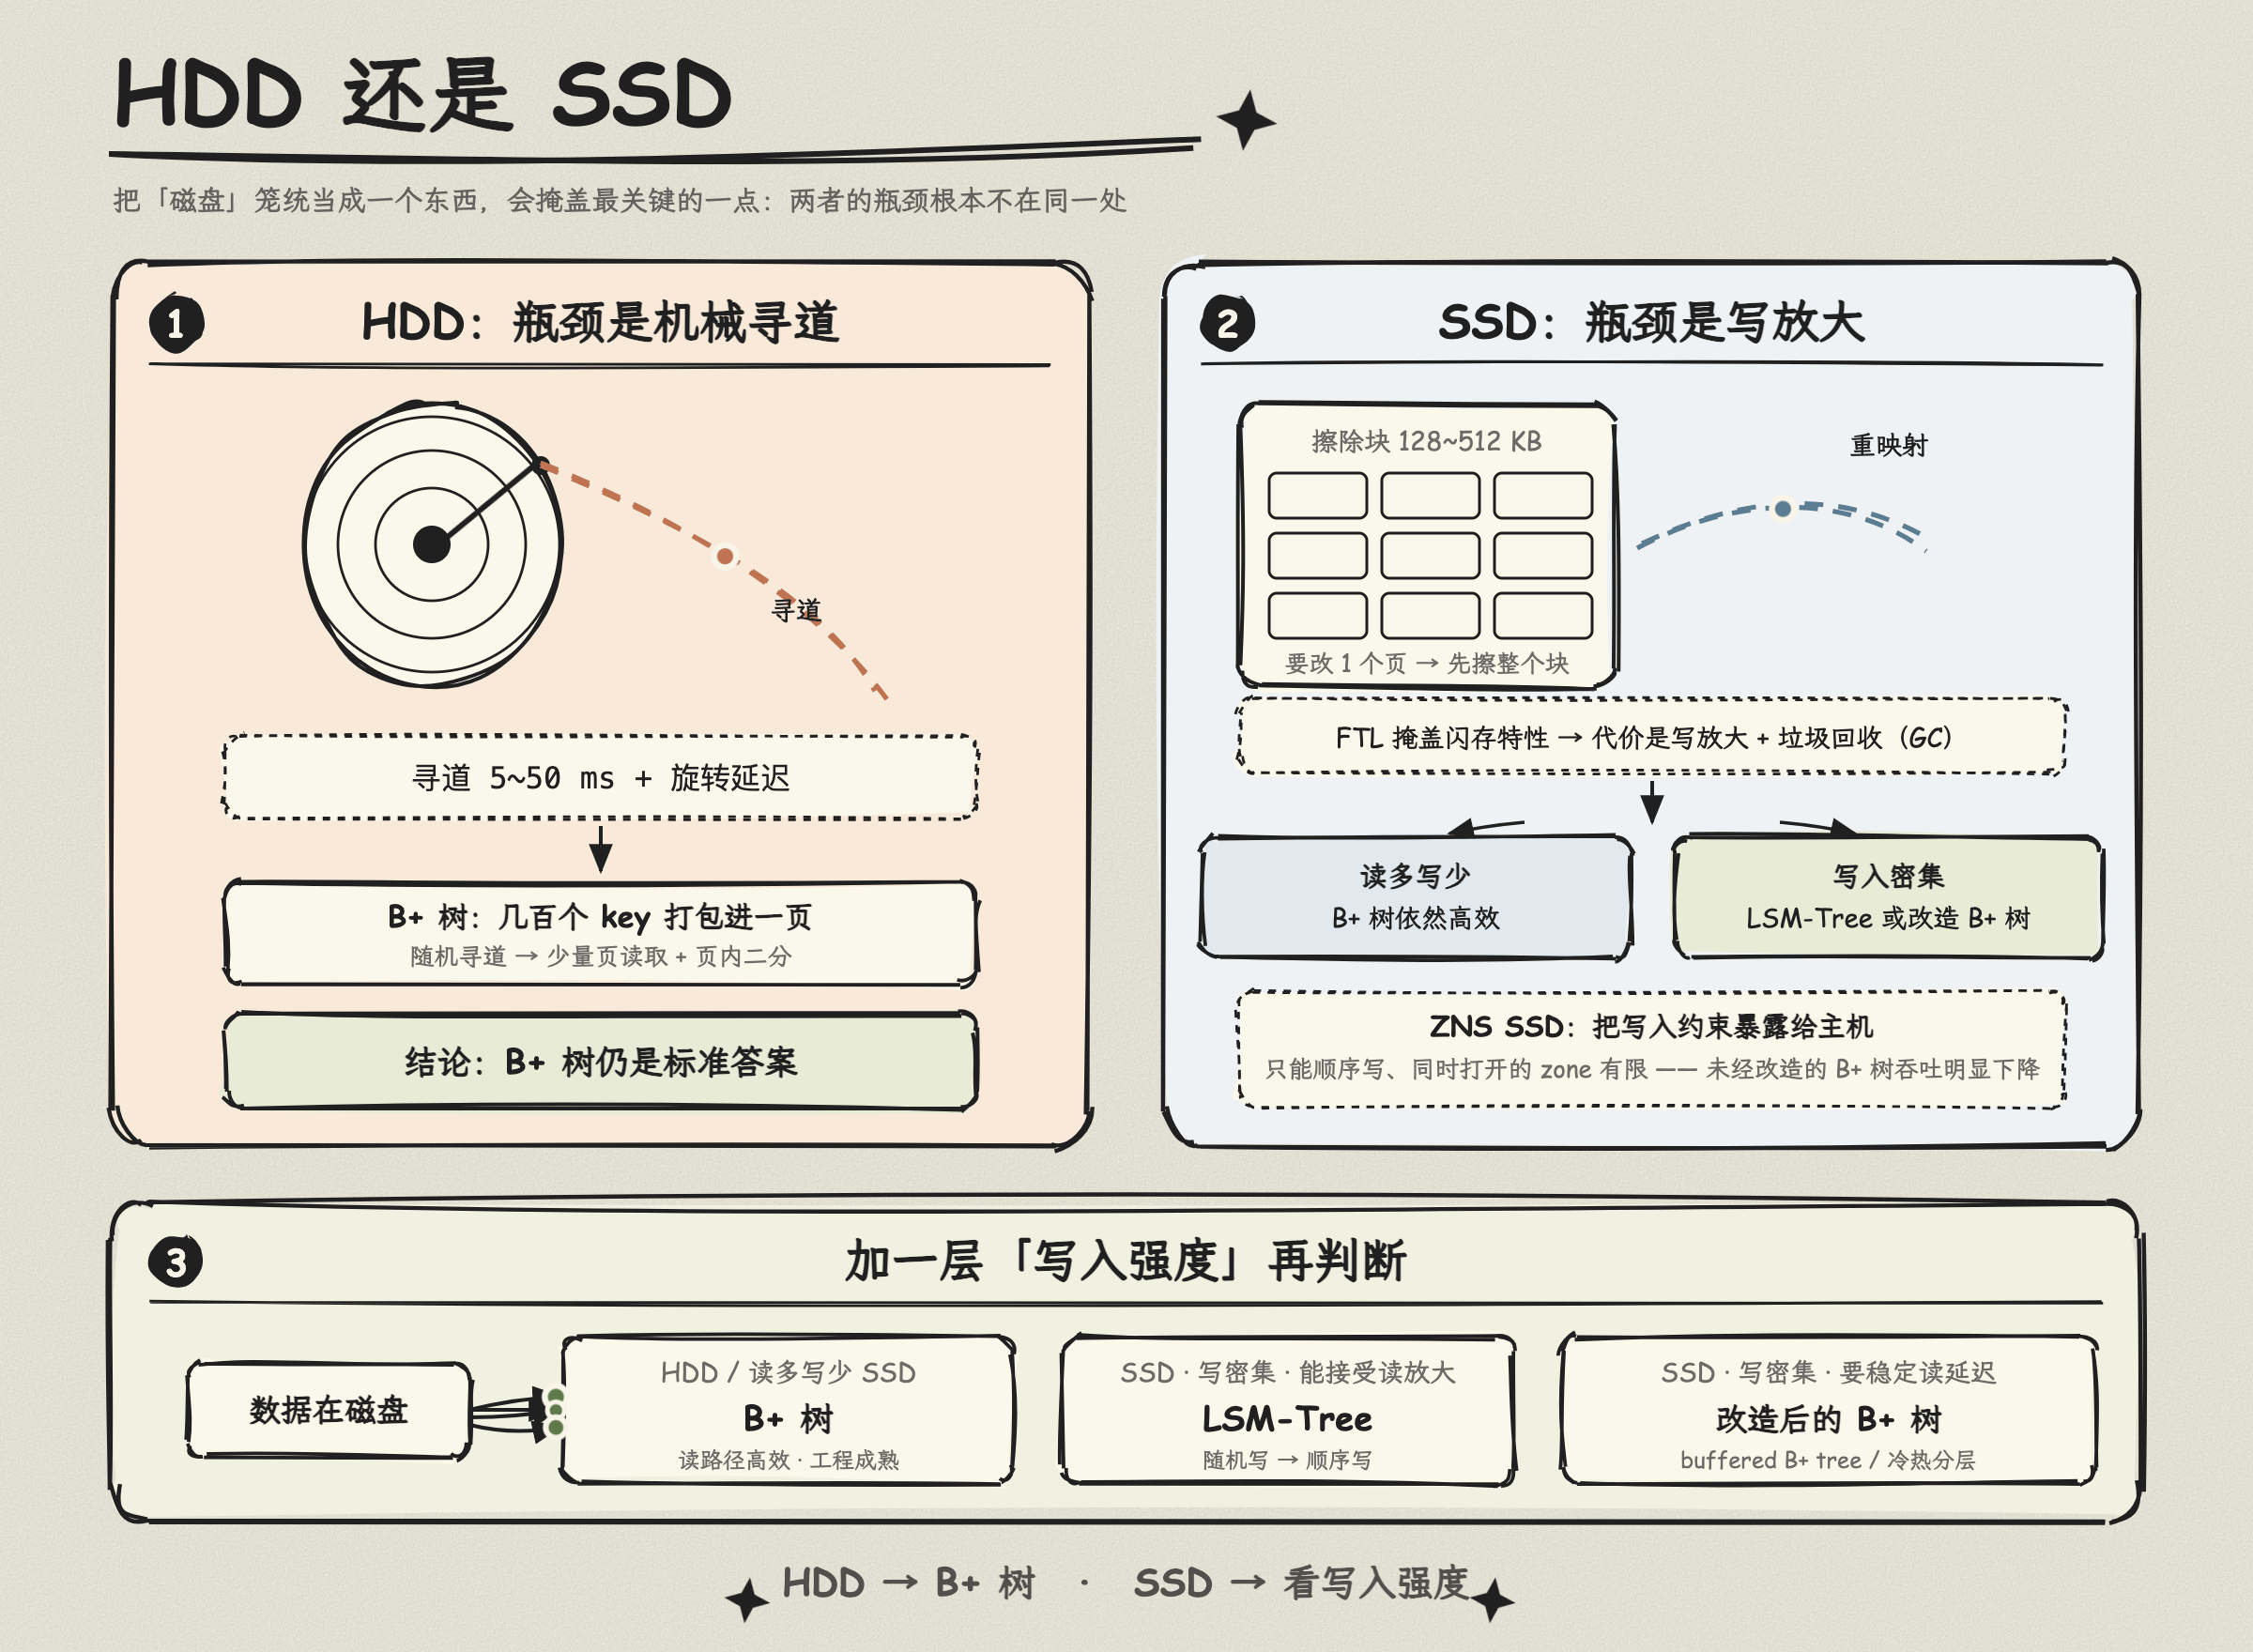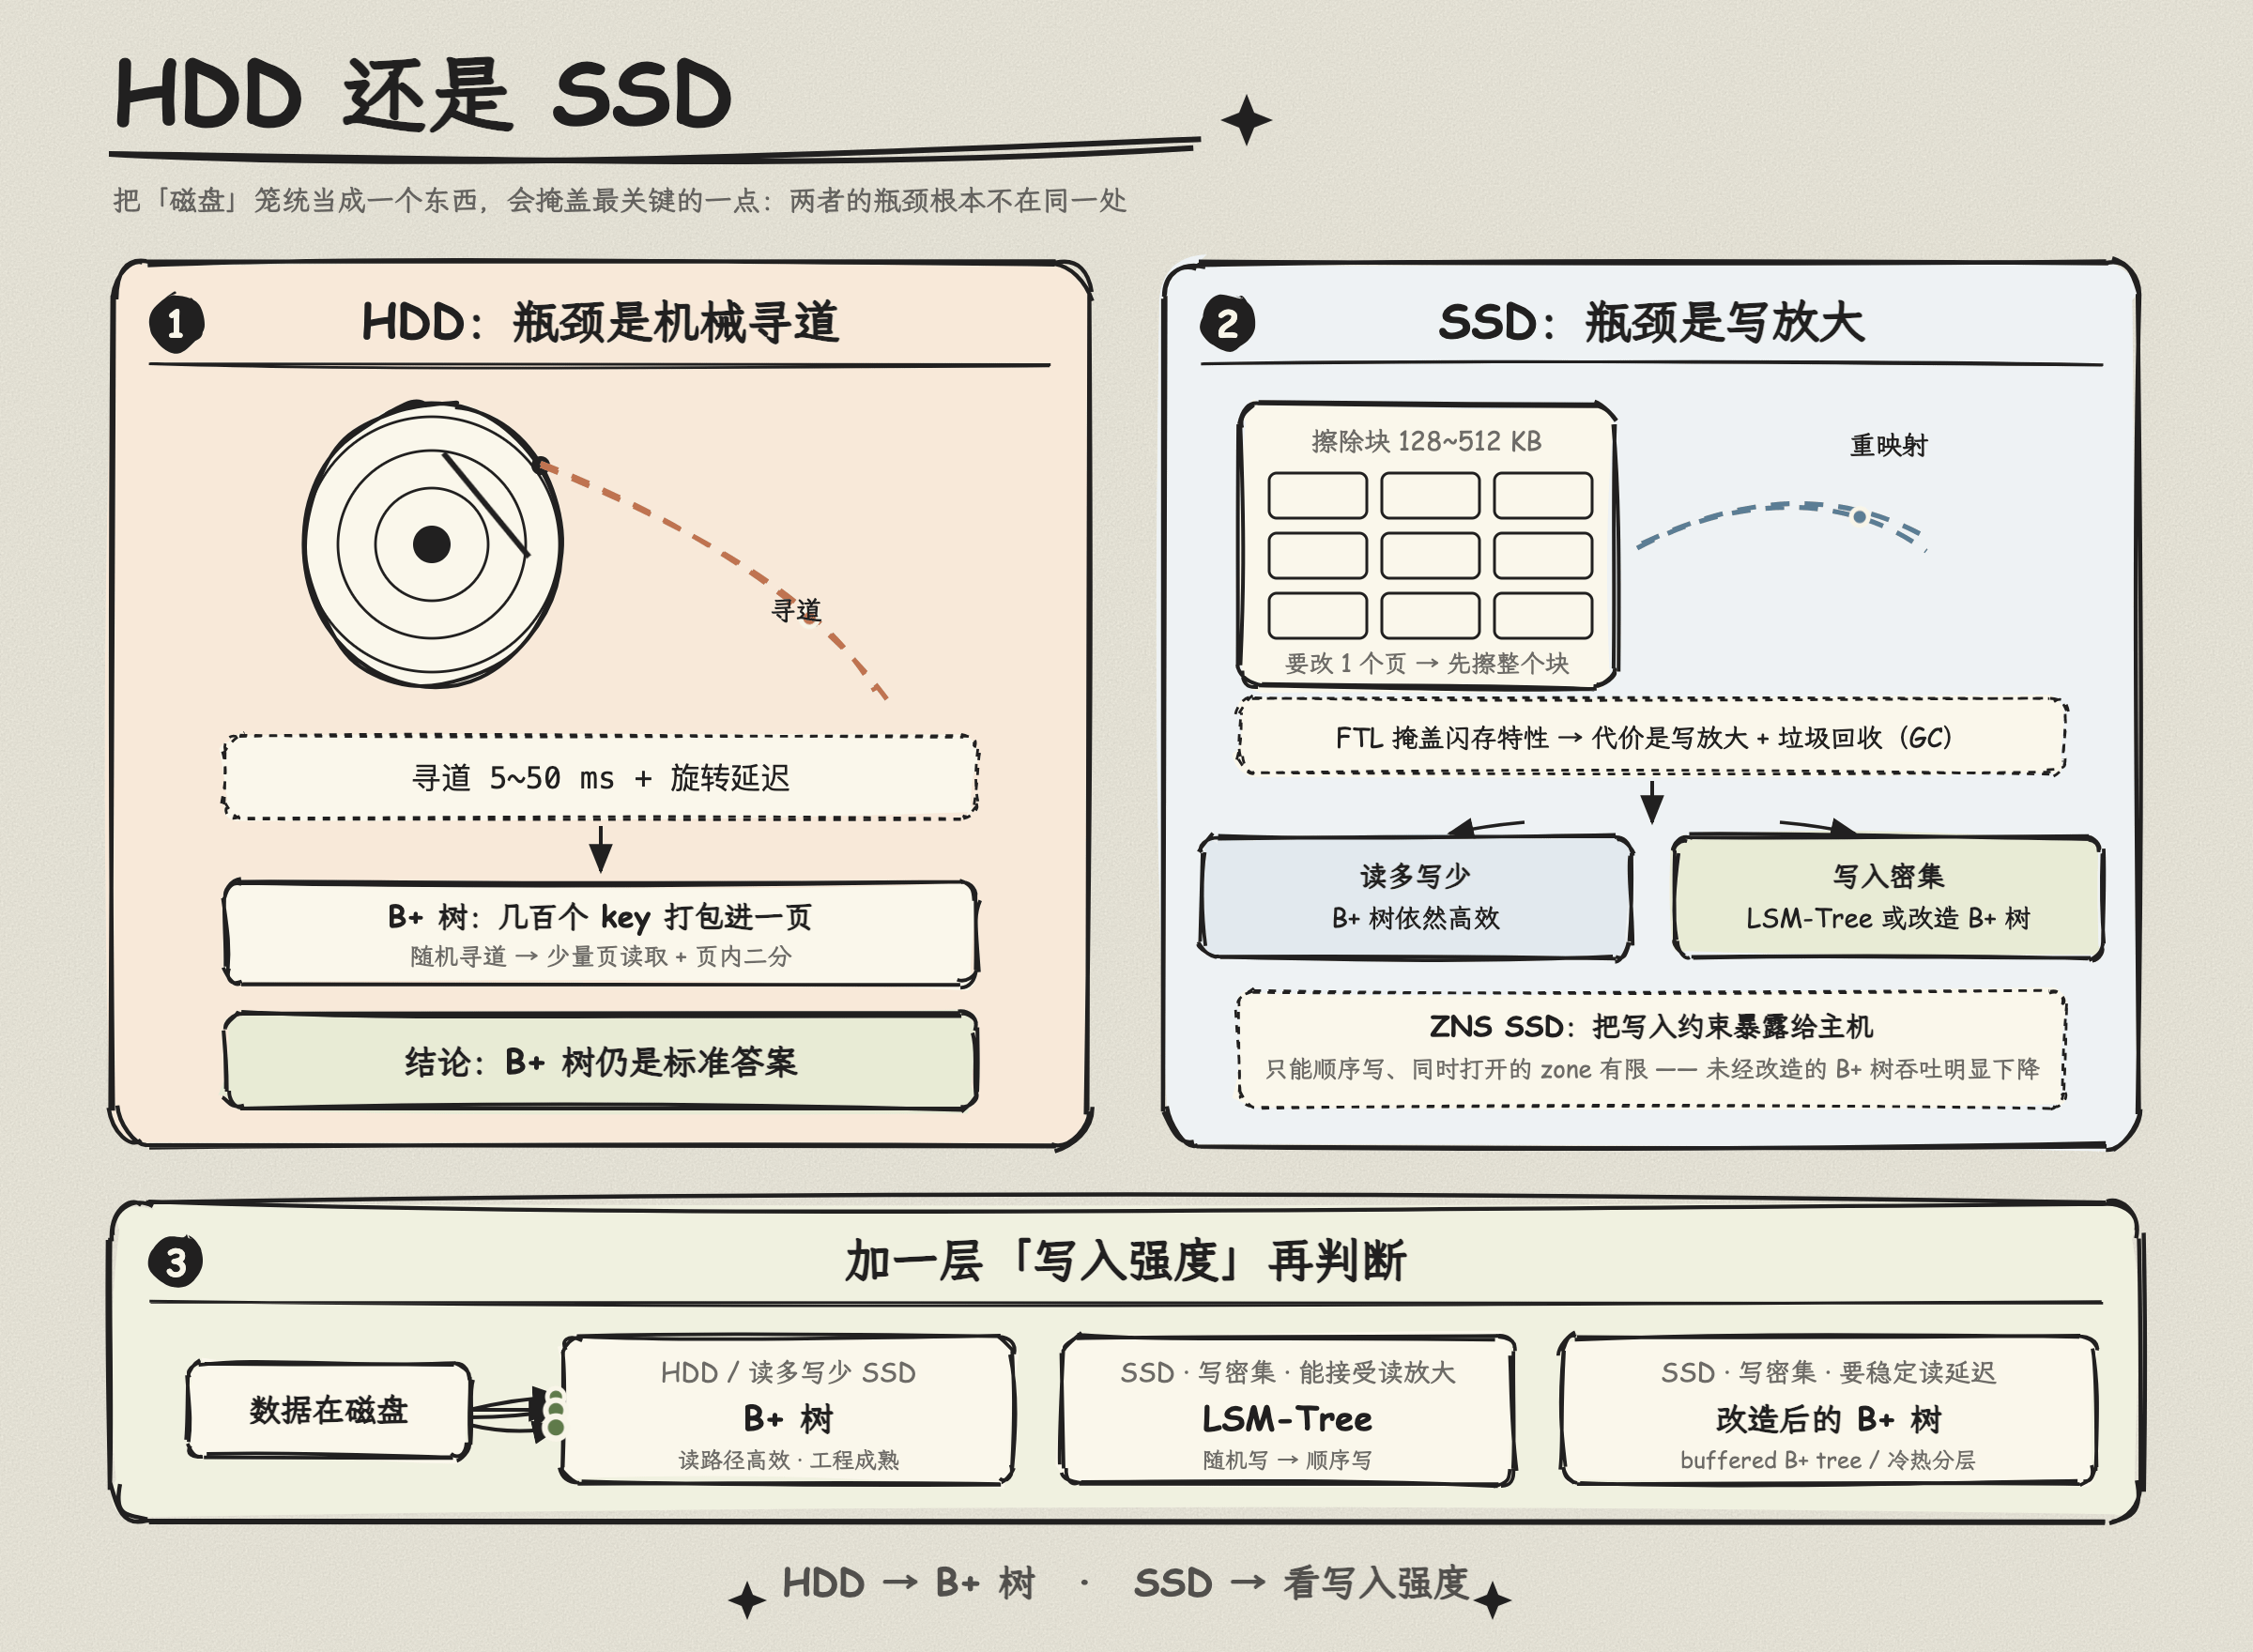
图 3:HDD 与 SSD 的瓶颈不在同一处。左边机械硬盘,代价大头是磁头寻道(5~50 ms)加旋转延迟,B+ 树把几百个 key 打包进一页,正好把随机寻道换成少量页读取;右边固态硬盘没有寻道,但闪存必须先擦除整个块才能覆写,原地更新经 FTL 重映射后留下写放大和 GC,于是要再按写入强度分岔:读多写少仍是 B+ 树,写密集则考虑 LSM-Tree 或改造后的 B+ 树。
4.3 选型判断:加一层“写入强度”
在原有三步选型(数据在哪 → 要不要顺序 → 实现成本)的基础上,磁盘场景可以拆成两条分支:
| 条件 | 推荐 | 理由 |
|---|---|---|
| HDD,或读多写少的 SSD 场景 | B+ 树 | 读路径依然高效,工程成熟度无可替代 |
| SSD,写入密集,且能接受读放大 | LSM-Tree | 把随机写转为顺序写,避开 SSD 的原地更新痛点 |
| SSD,写入密集,但需要稳定读延迟 | 改造后的 B+ 树(如 buffered B+ tree / 冷热分层) | 用缓冲或分层存储减少对闪存的随机小写 |
LSM-Tree 在 SSD 上的优势来自它“顺序写 + 后台合并”的机制,这与闪存“顺序写友好、原地更新昂贵”的特性天然匹配。代价是读放大和空间放大,所以它不是无条件更优,只是在写密集场景下值得优先考虑。
所以“磁盘 → B+ 树”更准确的表述是:HDD → B+ 树;SSD → 看写入强度,读多写少选 B+ 树,写密集考虑 LSM-Tree 或对 B+ 树做闪存友好改造。
五、一张表收尾
| 维度 | 哈希表 | 跳表 | B+ 树 |
|---|---|---|---|
| 存储介质 | 内存 | 内存 | 磁盘(HDD 为主;SSD 上可用但需权衡写入) |
| 等值查询 | 期望 O(1),最快 | 期望 O(log n) | O(log n),实际 1~2 次 I/O |
| 范围查询 | 不支持 | 支持,定位后顺序扫 | 支持,叶子链表顺序扫 |
| 有序遍历 | 不支持 | 支持 | 支持 |
| 写入模式 | 随机写(扩容代价高) | 随机写(局部改指针) | 随机写 + 页分裂,有写放大 |
| 核心优势 | 极致的点查速度 | 内存有序 + 实现简单 | 磁盘 I/O 最小化(尤其 HDD) |
| 典型系统 | Redis KV、Memcached | Redis ZSet、LevelDB MemTable | MySQL InnoDB、大多数关系库 |
所以怎么选,顺序是:
- 先问数据在哪。内存 → 继续往下。磁盘 → 再问是 HDD 还是 SSD、写入强度如何:HDD 或读多写少的 SSD → B+ 树;SSD 写密集 → LSM-Tree 或闪存友好改造的 B+ 树(LSM 本身是另一个话题,但它是这个分支的自然候选)。
- 再问要不要顺序。不要 → 哈希表。要 → 跳表。
- 最后问实现和维护成本。在内存有序结构里,跳表比平衡树更容易写对、更容易并发,这是一个经常被忽略但很实际的加分项。
前两步根据数据特征圈定候选集,第三步在候选集内做最终取舍。
引用与致谢
本文配图所用资源如下:
封面图
- 图片来源:Unsplash(免费可商用图库,遵循 Unsplash License)。
动图(图 1 ~ 图 3)
- 生成工具:Animated Sketch Diagram —— 一个把技术概念画成「黑墨手绘涂鸦 + 米色纸面」风格动画图的 Claude Code 插件。
- 项目地址:https://github.com/OLDyade/animated-sketch-diagram
- 作者:OLDyade
- 许可:见项目仓库中的 LICENSE 文件。
- 说明:三张动图均由该工具生成 SVG + CSS 动画后导出为无缝循环 GIF,文字内容依据本文正文整理,图中数据为示意值(节点数、页大小、耗时区间等取的是文中给出的典型量级,不是某次真实压测的结果)。
感谢阅读。